
98 Prozent in der Fabrik, 0 Prozent im Test: Was humanoide Roboter wirklich können
Xiaomi zeigt einen Humanoiden, der eine ganze Achtstundenschicht durcharbeitet. Im selben Zeitraum schafft im unabhängigen Benchmark RoboColosseum keine der fünf führenden Robotersteuerungen auch nur eine Haushaltsaufgabe auf einem Unitree G1. Wir legen beide Zahlen nebeneinander, erklären, warum beide stimmen können, und zeigen, woran man belastbare Roboter-Angaben erkennt.
Darum geht es
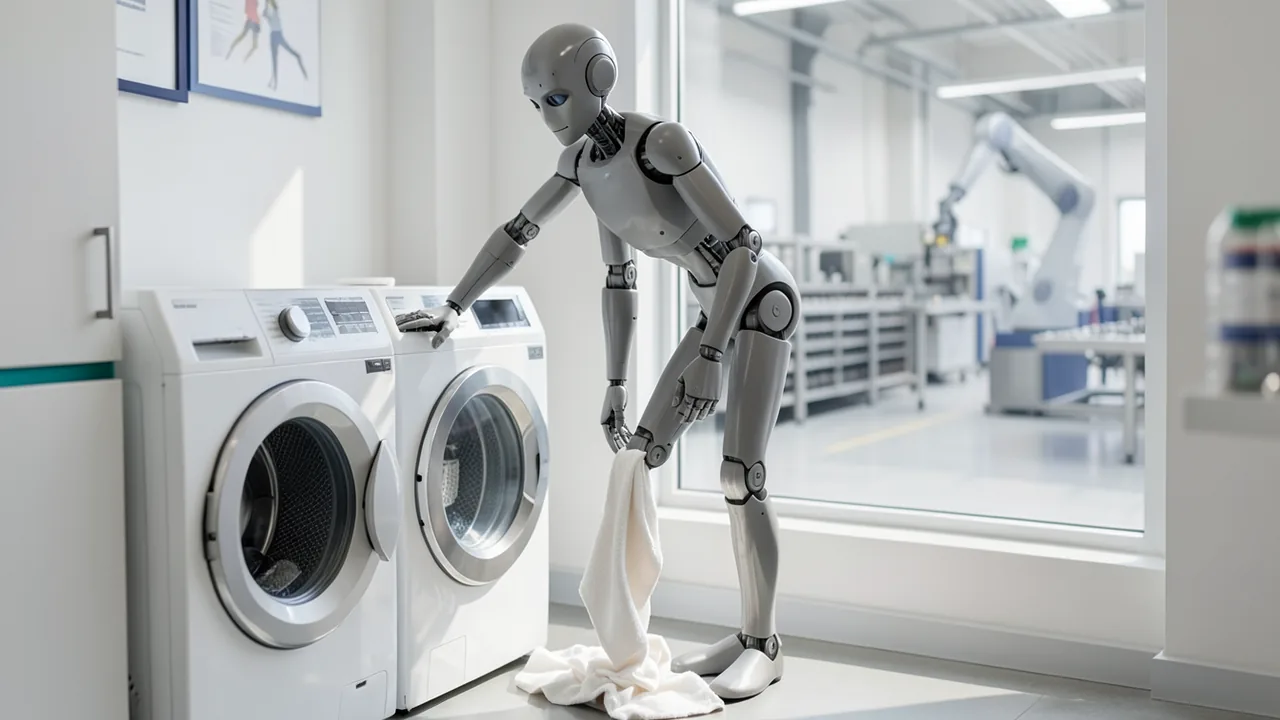
In dieser Woche sind drei Meldungen über humanoide Roboter erschienen, die auf den ersten Blick nicht zusammenpassen. Xiaomi zeigt ein Video, in dem Humanoide in der Pekinger Autofabrik eine komplette Schicht arbeiten. Zu UBTechs U1 für rund 25.000 Dollar hieß es, er „starte in Café und Werk“ in Südkorea. Und ein Forschungsverbund aus Singapur, Seattle, Stanford und von Hugging Face meldet mit dem Benchmark RoboColosseum: Auf dem humanoiden Unitree G1 hat keine der fünf führenden KI-Steuerungen auch nur eine einfache Haushaltsaufgabe geschafft.
Die Frage ist also, ob Humanoide schon arbeiten können oder nicht. Die kurze Antwort lautet: Beide Zahlen können stimmen, weil sie völlig verschiedene Dinge messen. Die lange Antwort folgt hier, dazu eine Checkliste für die nächste Erfolgsmeldung.
Was die Hersteller melden und was dabei fehlt
Xiaomi hat seine Zahlen schrittweise veröffentlicht. Im März arbeitete ein Humanoid als „Praktikant“ an einer Station, an der selbstschneidende Muttern eingesetzt werden. Er schaffte dort drei Stunden lang 90,2 Prozent Erfolg und hielt den Takt von 76 Sekunden ein, also die Zeit, die jeder Arbeitsschritt am Band dauern darf. Im Juli stieg der Wert an derselben Station auf 98 Prozent. Laut Xiaomi liegt das nur einen Prozentpunkt unter geschulten Arbeitern (99 Prozent). Zwei neue Stationen, das Sortieren von Seitenverkleidungen der Mittelkonsole und das Falten von Kisten, kamen damals laut TechNode auf je 90 Prozent.
Am 3. November folgte das Video der Achtstundenschicht an der Station für die Seitenverkleidungen. Chinesische Medien wie The Paper haben es genauer ausgewertet. Die Arbeit dauerte 8 Stunden und 5 Minuten, das Video läuft in hundertfacher Geschwindigkeit und ist knapp sechs Minuten lang. Nach 3:02 und 6:03 Stunden gab es je eine Ladepause. Einmal fiel ein Teil zu Boden, das dann ein Roboter auf Rädern aufhob. Zu sehen sind zwei Humanoide, ein fahrbarer Oberkörper-Roboter und ein autonomes Transportfahrzeug, das die Kisten bringt.
Wichtig ist, was fehlt. Electrek und Génération-NT zählen auf: keine Stückzahl, keine Erfolgsquote über die acht Stunden, keine Angabe, wie oft Menschen eingegriffen haben. Das Technikportal SMZDM betont, dass Xiaomi selbst vorsichtig formuliert. Der Roboter decke den Tagesbedarf einer Station ab, das sei eine „vorläufige Bestätigung“ der Tauglichkeit für eine ganze Linie. Xiaomi-Chef Lei Jun hat das Problem selbst benannt: Im Labor seien viele Fehlschläge erlaubt, in der Fabrik müsse jeder Handgriff sitzen.
Zur Größenordnung eine eigene Rechnung: Bei 76 Sekunden Takt passen in acht Stunden rund 379 Arbeitsgänge. Mit 98 Prozent Erfolg wären das sieben bis acht Fehlversuche pro Schicht. Die 98 Prozent gelten allerdings für die Mutter-Station und nicht für die Station aus dem Schichtvideo.
Bei UBTech muss man die Meldung korrigieren. Der U1 ist laut Hersteller ein lebensechter Begleitroboter mit Silikonhaut und bionischem Gesicht, verkauft unter der Konsumentenmarke UWorld. Die Pro-Version kostet 169.800 Yuan, also etwa 24.000 Dollar. In Südkorea hat ihn laut The Gadgeteer der Freizeitpark Galaxy Robot Park in Seoul gekauft. Die Café-Tests mit der Kette Hollys betreibt das Pekinger Start-up Anyverse Dynamics. Der Werkstest auf einer Linie für Autoteile (mit Duksan JM Robotics und Ajin Industrial) ist zwar ein UBTech-Projekt, welches Modell dort arbeitet und was es genau tut, steht aber in keinem Bericht. Über die Fähigkeiten des U1 bei Arbeitsaufgaben sagt die Meldung also nichts aus.
Was der unabhängige Test misst
RoboColosseum (arXiv 2611.02497) stammt unter anderem von der National University of Singapore, der University of Washington, Stanford, dem Allen Institute for AI (Ai2) und Hugging Face. Getestet wurden fünf VLA-Modelle, also Vision-Language-Action-Modelle, die Kamerabilder und einen Sprachbefehl direkt in Motorbefehle übersetzen: GR00T N1.7 (Nvidia), π0.5 (Physical Intelligence), MolmoAct2 (Ai2), G0.5 und LingBot-VLA v2.
Im Fine-tune-Track bekam jedes Modell pro Aufgabe dieselben 100 ferngesteuert aufgezeichneten Vorführungen (Teleoperation: Ein Mensch steuert den Roboter, das System lernt mit). Trainiert wurde nach dem offiziellen Rezept des jeweiligen Herstellers, danach folgten 25 Versuche pro Aufgabe. Gemessen wurden zwei Werte. Die Erfolgsquote zählt nur komplett gelöste Aufgaben. Der Fortschrittswert gibt an, welcher Anteil der Teilschritte geschafft wurde.
| Roboter | GR00T N1.7 | π0.5 | MolmoAct2 | G0.5 | LingBot-VLA v2 |
|---|---|---|---|---|---|
| SO-101 (kleiner Arm) | 89,0 / 82,4 | 85,4 / 77,6 | 71,8 / 59,2 | 58,8 / 40,0 | 55,2 / 36,8 |
| Franka (Industriearm) | 56,4 / 42,4 | 91,2 / 84,0 | 78,2 / 54,4 | 44,8 / 16,0 | 59,4 / 40,8 |
| YAM (zwei Arme) | 52,6 / 20,0 | 97,2 / 93,6 | 72,1 / 49,6 | 89,1 / 75,2 | 48,3 / 30,4 |
| Unitree G1 (Humanoid) | 22,7 / 0,0 | 16,3 / 0,0 | 19,8 / 0,0 | 13,3 / 0,0 | 23,2 / 0,0 |
Fortschritt / Erfolg in Prozent, Mittel über je fünf Aufgaben. Quelle: RoboColosseum-Paper, Tabelle 2.
Die fünf G1-Aufgaben liefen in echten Wohnungen in Malaysia, mit 150 Sekunden Zeitlimit: Teller ins Abtropfgestell stellen, leeren Karton tragen, Handtuch falten, Waschmaschine mit T-Shirt und Hose beladen, Schlüsselbund an einen Haken hängen. Zusammen sind das 625 Versuche (5 Modelle × 5 Aufgaben × 25) und kein einziger Erfolg. Laut Paper erfüllte in weniger als 40 Prozent der Versuche der Roboter überhaupt ein Viertel der Kriterien. Beim Tragen des Kartons und bei der Waschmaschine kamen einige Modelle weit, scheiterten aber an den letzten Schritten. Handtuch und Schlüssel waren für fast alle zu schwer.
Warum beide Zahlen stimmen können
Feste Station gegen fremde Wohnung. Xiaomis Roboter arbeitet monatelang an demselben Platz, mit denselben Teilen, demselben Licht und derselben Kiste. RoboColosseum stellt Roboter in Umgebungen, die das Modell nie gesehen hat. Schon π0.5 bewirbt sein Hersteller gerade mit der Fähigkeit, Neues zu verallgemeinern. Ai2 kommt mit seinem in derselben Woche erschienenen Testsystem ToyBlocks zum Schluss, dass π0.5 und MolmoAct 2 trotz großem Vortraining schlecht verallgemeinern.
Viele Daten gegen 100 Demos. Wie viele Daten Xiaomi für die Station gesammelt hat, ist nicht bekannt. Laut SMZDM wurde das Basismodell mit über 100.000 Stunden menschlicher Bewegungsdaten und etwa 10.000 Stunden Roboterdaten trainiert. Im Benchmark gab es pro Aufgabe 100 Vorführungen.
Gehen plus Greifen. Die G1-Aufgaben verlangen Laufen, Hocken, Umdrehen und ein Objekt von einer Hand in die andere geben. An zwei festen Armen fällt all das weg. Dort hält π0.5 seine 93,6 Prozent. Electrek merkt an, dass auch in Xiaomis Video Räder (Transportroboter, fahrbarer Oberkörper) die Lücken füllen.
Erfolg gegen Fortschritt. Die Herstellerzahlen sind oft wohlwollender definiert. Physical Intelligence meldet für π0.5 in fremden Testwohnungen 94 Prozent Erfolg. Diese Quote ist laut eigenem Blog aber über Teilaufgaben gemittelt, etwa als Anteil korrekt verstauter Gegenstände. Das liegt näher am Fortschrittswert von RoboColosseum als an dessen strenger Erfolgsquote.
Ein Gegenbeispiel zeigt, dass der G1 nicht grundsätzlich unfähig ist. Im Paper Zero-HLM kommt GR00T N1.7 auf dem G1 auf 66,7 Prozent Erfolg, trainiert mit 4.800 Simulations-Demos, gegenüber 46,7 Prozent mit echten Daten. Dort ging es aber um drei andere Aufgaben in einem anderen Aufbau. Direkt vergleichbar ist das nicht.
Ranglisten wandern nicht mit
Der vielleicht wichtigste Befund betrifft Ranglisten. Kendall W misst, wie einig sich mehrere Ranglisten sind, von 0 (gar nicht) bis 1 (völlig). Über die Roboter hinweg liegt der Wert bei 0,24. Ein Testsieger auf dem einen Roboter sagt also wenig über den nächsten. GR00T N1.7 ist auf dem kleinen SO-101 vorn und an zwei Armen mit 20 Prozent Erfolg weit abgeschlagen.
Im zweiten Teil, dem Open Track, liefen Modelle ohne aufgabenspezifisches Training in 5.699 verblindeten Paarvergleichen an 124 Standorten. Prüfer sahen zwei Durchläufe nebeneinander, ohne die Modellnamen zu kennen. Diese Rangliste sagt das Abschneiden nach dem Training schlecht voraus. Die Rangkorrelation liegt je nach Roboter bei −0,40 bis 0,20, die Reihenfolge kehrt sich also teils sogar um. Auf dem SO-101 stimmten selbst zwei Hälften der Standorte nur zu 59 Prozent überein. Stabil zu 90 Prozent wurden die Ranglisten erst nach rund 1.100 Bewertungen.
Allgemeine KI-Agenten wie Claude Opus 5.5 (+12,1 Punkte Fortschritt gegenüber den VLA-Modellen) und GPT-6 Astra (+11,0) schnitten im Open Track sogar besser ab als die Spezialmodelle, Grok 4.7 lag bei −7,5. Bei schweren Aufgaben (Schwierigkeit 9–10) sank die vollständige Erfolgsquote aller Systeme aber auf 0,4 Prozent. Die Autoren schreiben:
„Keines der Systeme löst Aufgaben in offener Umgebung zuverlässig.“
Auch die Messung selbst schwankt. Ai2 berichtet bei ToyBlocks, dass dasselbe Modell bei vier Durchläufen derselben 128 Simulationsepisoden zwischen 54 und 59 Prozent lag. Dieter Fox (Ai2, Mitautor von RoboColosseum) sagte dem Spokesman-Review über einen Roboter, der an einer Stelle klappte und an einer anderen nicht: „Für einen Menschen wäre das trivial.“
Checkliste: So prüfst du Roboter-Angaben
- Was heißt „Erfolg“? Die ganze Aufgabe oder ein Mittel über Teilschritte?
- Wie viele Versuche? Bei 25 Versuchen ist ein Fehlschlag schon 4 Prozentpunkte.
- Feste Station oder neue Umgebung? Wochenlanges Üben an einem Platz ist etwas anderes als eine fremde Wohnung.
- Wie viel Training für genau diese Aufgabe? Fehlt die Zahl der Demos, fehlt der Maßstab.
- Wurde eingegriffen? Teleoperation, Hilfsroboter, Reset durch Menschen. Tesla führte 2024 ferngesteuerte Optimus-Roboter vor, ohne das offenzulegen.
- Zeitraffer und Schnitte? Ladepausen und Pannen gehören in die Bilanz.
- Wer misst? Der Hersteller selbst oder blinde, unabhängige Prüfer?
- Welcher Roboter? Ergebnisse lassen sich kaum auf andere Hardware übertragen.
- Durchsatz und Kosten? Teile pro Stunde und Kosten pro Schicht im Vergleich zum Menschen.
Einordnung
Xiaomi veröffentlicht immerhin Takt- und Erfolgszahlen, was Electrek ausdrücklich lobt. Für das eigentliche Ergebnis, die Achtstundenschicht, fehlen aber genau die Zahlen, mit denen man sie prüfen könnte. RoboColosseum ist das Gegenteil: offene Daten im LeRobot-Format auf Hugging Face, Auswertungscode auf GitHub und auch Fehlschläge werden veröffentlicht. Die Autoren selbst sprechen von einer ersten Studie. Abgedeckt sind nur fünf Aufgaben pro Roboter, die Trainingsrezepte stammen von den Herstellern, und 100 Demos könnten für einen Humanoiden mit Ganzkörperbewegung schlicht zu wenig sein.
Unsere Einschätzung: Die Zahlen widersprechen sich nicht, sie zeigen zwei Enden derselben Skala. Eng begrenzte Aufgaben mit vielen Daten an einem festen Platz rücken in Reichweite. Der Humanoid, der in einer fremden Wohnung Wäsche einräumt, ist es noch nicht. Wer Humanoide kauft oder in sie investiert, sollte wie AI Weekly rät Tests auf der eigenen Hardware und in der eigenen Umgebung verlangen. Eine Rangliste von anderswo reicht dafür nicht.
Quellen
- arXiv-Paper: RoboColosseum (HTML) arxiv.org
- arXiv: RoboColosseum Abstract arxiv.org
- Hugging Face Paper-Seite RoboColosseum huggingface.co
- Hugging Face: RoboColosseum (Datensätze und Modelle) huggingface.co
- GitHub: RoboColosseum/robocolosseum-finetune-g1 github.com
- RoboColosseum Projektseite robocolosseum.ai
- AI Weekly: RoboColosseum policy rankings don't transfer aiweekly.co
- CCTest: RoboColosseum Tests Robot Policies cctest.ai
- Electrek: Xiaomi humanoid robot 8-hour shift electrek.co
- TechNode: Xiaomi 98 % success rate technode.com
- Génération-NT: Xiaomi huit heures generation-nt.com
- The Paper (澎湃): Xiaomi-Roboter 8 Stunden thepaper.cn
- SMZDM: Station vs. Produktionslinie post.smzdm.com
- 21jingji: Xiaomis neuer Humanoid-Prototyp m.21jingji.com
- The Gadgeteer: Chinese humanoid robots in South Korea the-gadgeteer.com
- ad-hoc-news: UBTech in Südkorea ad-hoc-news.de
- Physical Intelligence: π0.5 Blog pi.website
- note.com: Overview of GR00T N1.7 note.com
- arXiv: Zero-HLM arxiv.org
- Hugging Face Blog: ToyBlocks (Ai2) huggingface.co
- Unite.AI: Ai2 releases ToyBlocks unite.ai
- Spokesman-Review: Why a Seattle AI lab is making robots play with toy blocks spokesman.com
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.