
Engram erklärt: Warum neue KI-Modelle einen Teil ihres Wissens auf der SSD ablegen
DeepSeek, Qwen und jetzt Tencent bauen riesige Nachschlage-Tabellen in ihre Modelle ein. Pro Wort lesen sie daraus nur ein paar Dutzend kleine Zeilen. Wir erklären, wie dieses „Engram“ funktioniert, warum die Angabe „Gesamtparameter“ dadurch wenig aussagt und weshalb diese Tabellen ausnahmsweise auf der SSD liegen dürfen, ohne dass das Modell viel langsamer wird.
Darum geht es
Tencent hat heute Hy4 flash vorgestellt. Laut Tencent hat das Modell 224 Milliarden Parameter, aktiv sind pro Token aber nur 12 Milliarden. Bemerkenswert ist ein Detail aus der Ankündigung: 64 der 224 Milliarden sind „Engram-Gedächtnisparameter“. Das ist kein Einzelfall. DeepSeek-V4.1-Flash bringt rund 196 Milliarden solcher Parameter mit. Alibabas Qwen baut dasselbe Prinzip unter dem Namen PLE in die Architektur ein, auf der die kommenden Qwen4-Modelle beruhen. Kleinere Qwen4-Modelle sollen als offene Gewichte erscheinen.
Diese Parameter rechnen nicht, sie werden nachgeschlagen. Daraus folgen drei Fragen: Was steckt dahinter? Wie viel sagen Angaben wie „224B“ dann noch aus? Und was heißt das für deinen Rechner zu Hause?
Wie Engram funktioniert: ein Wörterbuch für Wortfolgen
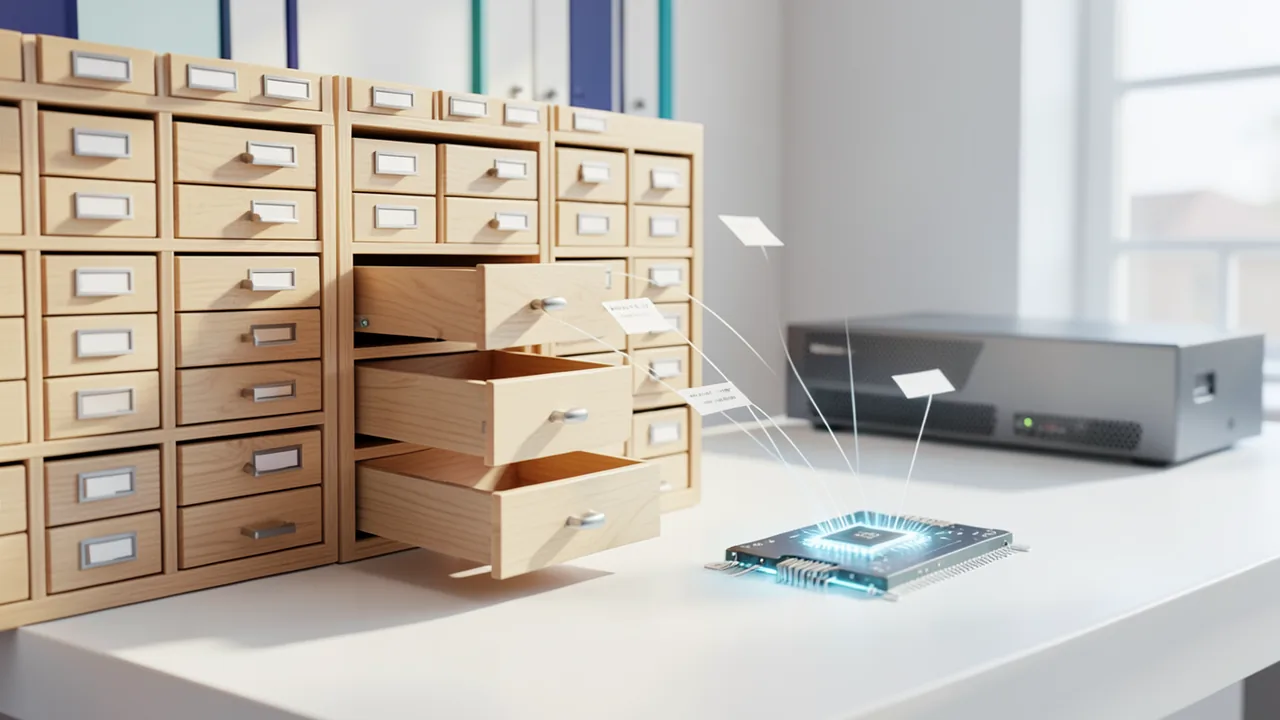
DeepSeek hat die Idee im Paper „Conditional Memory via Scalable Lookup“ beschrieben und den Code als deepseek-ai/Engram veröffentlicht. Ein Sprachmodell rechnet sich auch banale Zusammenhänge wie „Hauptstadt von Frankreich → Paris“ bei jedem Token neu aus. Engram legt solche festen Muster stattdessen in einer großen Tabelle ab.
Das läuft so ab: Das Modell nimmt die letzten zwei oder drei Tokens, also ein n-Gramm (eine kurze Wortfolge). Daraus berechnet es per Hash eine Adresse, eine Art Fingerabdruck, der direkt auf eine Tabellenzeile zeigt. Damit verschiedene Wortfolgen nicht dauernd auf derselben Zeile landen, nutzt Engram mehrere „Köpfe“, also mehrere unabhängige Hash-Funktionen mit je eigener Tabelle. Vorher werden Token-Varianten zusammengefasst, etwa Groß- und Kleinschreibung. Das verkleinert das Vokabular laut Paper um etwa 23 Prozent. Die gelesenen Zeilen laufen durch ein Gate, eine Art Ventil, das den Tabelleninhalt mit dem aktuellen Zusammenhang vergleicht. Passt die Erinnerung nicht zum Kontext, wird sie gedämpft.
Wichtig für alles Weitere: Die Adresse hängt nur von den Token-Nummern ab, nicht von Zwischenergebnissen der Rechnung. Das System weiß also schon vor dem Rechnen, welche Zeilen es braucht, und kann sie vorab holen. Mit Mixture-of-Experts (MoE) ist das nicht möglich. Dort entscheidet erst die laufende Rechnung, welche Teilnetze („Experten“) gebraucht werden.
Die wichtigsten Befunde des Papers (Herstellerangaben von DeepSeek):
- Engram-27B hat genauso viele Parameter (26,7 Mrd.) und genauso viel Rechenaufwand (3,8 Mrd. aktiv) wie ein reines MoE-Vergleichsmodell. Dafür fallen 17 der 72 Experten weg, ihr Budget fließt in 5,7 Mrd. Tabellenparameter. Ergebnis gegenüber dem Vergleichsmodell: MMLU +3,4, BBH +5,0, HumanEval +3,0, MATH +2,4 Punkte. Bei der Suche in langen Texten (Multi-Query-NIAH) steigt der Wert von 84,2 auf 97,0.
- Am besten schnitt eine Mischung ab, bei der etwa 20 bis 25 Prozent des „ruhenden“ Budgets in die Tabellen gehen. Die Kurve hat eine U-Form, beide Extreme sind schlechter.
- Schaltet man Engram nachträglich ab, behält das Modell beim Faktenwissen nur 29 bis 44 Prozent seiner Leistung (TriviaQA: 29 Prozent). Beim Leseverständnis sind es 81 bis 93 Prozent. Das Faktenwissen steckt also zu einem großen Teil in der Tabelle.
Drei Hersteller, drei Namen, eine Idee
| Modell | Gesamt | aktiv pro Token | davon Tabellen | Gewichte offen? |
|---|---|---|---|---|
| DeepSeek-V4.1-Flash | 552 + 196 Mrd. (HF zeigt 763 Mrd.) | 8 (Prefill) / 16 (Ausgabe) | 196 Mrd. | ja, MIT |
| Qwen3.8-Flash-Next (Qwen4-Exp-Architektur) | 125 Mrd. | 6 Mrd. | 51 Mrd. | ja |
| Qwen4-Max | 2.400 Mrd. | 71 Mrd. | 328 Mrd. | nein, nur API |
| Hy4 flash | 224 Mrd. | 12 Mrd. | 64 Mrd. | noch nicht, angekündigt |
| Engram-27B (Paper) | 26,7 Mrd. | 3,8 Mrd. | 5,7 Mrd. | Forschungsmodell |
Bei DeepSeek liegen laut vLLM-Rezept zwei Tabellen mit je rund 384 Millionen Zeilen in den Schichten 1 und 14. Qwen nennt das Verfahren PLE („Per-Layer Embedding“). Laut der Transformers-Dokumentation hasht es standardmäßig Dreierfolgen mit 8 Köpfen pro n-Gramm-Länge, ergänzt um eine kleine Faltung über die Nachbartokens. Den Namen PLE hat Google mit Gemma 3n eingeführt. Dort dürfen Einbettungen pro Schicht auf der CPU liegen: Bei Gemma 3n E2B stecken von 5 Mrd. Parametern nur etwa 2 Mrd. im Grafikspeicher. Qwen und DeepSeek adressieren ihre Tabellen aber ausdrücklich über gehashte Wortfolgen. Tencent beschreibt für Hy4 flash neben Engram eine „LatentMoE“-Bauweise und einen KV-Cache (den Zwischenspeicher für den bisherigen Text), der nur ein Sechstel so groß ist wie bei Hy4. Wie die 64 Mrd. Engram-Parameter genau aufgeteilt sind, hat Tencent bisher nicht veröffentlicht.
Warum „Gesamtparameter“ eine dritte Spalte braucht
Mit MoE gewöhnte man sich an zwei Zahlen: gesamt (bestimmt den Speicherbedarf) und aktiv (bestimmt das Tempo). Engram passt in keine der beiden Spalten. Die Tabellen zählen zum Gesamtwert, werden aber pro Token kaum gelesen. Nach der Rechnung von Rohit Ghumare braucht DeepSeek-V4.1-Flash pro Token 2 Tabellen × 3 n-Gramm-Längen × 8 Köpfe = 48 Zeilen. In der 4-Bit-Fassung (IQ4_NL, 144 Byte pro Zeile) sind das 6.912 Byte. Unsere Nachrechnung: Das ist etwa ein Sechzehnmillionstel der 110,6 GB großen Tabelle. Zum Vergleich: Die ausgewählten Experten bewegen bei 2 Bit pro Token rund 2 GB.
Unsere Einschätzung: Ehrlich wäre eine Angabe in drei Teilen, also „aktiv / rechnend gesamt / Nachschlage-Tabellen“. Hy4 flash wäre dann 12 / 160 / 64, DeepSeek-V4.1-Flash 16 / 552 / 196. Selbst auf Hacker News schrieb ein Nutzer, er werde aus der tatsächlichen Parameterzahl von V4.1 Flash nicht schlau.
Der Sonderfall, in dem die SSD fast nichts kostet
Normalerweise heißt „läuft von der SSD“ bei Sprachmodellen: quälend langsam. Bei Engram ist das anders, weil nur winzige, vorab bekannte Leseaufträge anfallen.
vLLM, eine Server-Software, lagert die Tabellen laut Dokumentation standardmäßig in festgehaltenen Arbeitsspeicher aus (cpu_offload ist an). Die GPU liest die Zeilen über UVA, also einen gemeinsamen Adressraum von Grafikkarte und RAM. Das Vorabholen läuft parallel zur Rechnung, und der frei gewordene Grafikspeicher geht an den KV-Cache. Für DeepSeek-V4.1-Flash sind das etwa 200 GB in FP8 oder 104 GB in MXFP4. Für Qwen4-Exp gibt es zusätzlich disk_offload, das die Zeilen bei jedem Schritt direkt aus den Dateien liest. Alles läuft nur auf CUDA-Hardware.
llama.cpp kann seit PR #27794 (Ende August) große Tabellen „lazy“ lesen. Die Datei wird per mmap eingeblendet, also so in den Speicher gespiegelt, dass das Betriebssystem nur die tatsächlich angefassten Stücke von der Platte holt. Der Schalter heißt -lzm/--lazy-mode. Die Voreinstellung auto gilt für Tensoren über 4 GiB. Zusätzlich markiert llama.cpp den Bereich mit MADV_RANDOM, damit das System nicht unnötig vorausliest. DeepSeek V4.1 unterstützt llama.cpp seit Build b11870 vom 25. Oktober. Bei korrekt geladenem Modell meldet das Log für per_layer_token_embd.weight „lazy read enabled“.
Ghumare kommt bei 10 Tokens pro Sekunde auf etwa 2 MB/s und 500 zufällige Lesezugriffe pro Sekunde. Das sind rund 0,06 Prozent der Leistung einer 3,6-GB/s-NVMe. Häufige Wortfolgen landen außerdem im Page Cache, dem Platten-Zwischenspeicher im RAM. Sie kosten deshalb nur beim ersten Auftreten einen Plattenzugriff. Die Firma Capacity hat die Latenzen auf einem Apple-Rechner gemessen und schätzt, dass eine ordentliche NVMe bis etwa 40 bis 60 Tokens pro Sekunde mithält.
Für Hardware zu Hause heißt das: Laut Unsloth braucht DeepSeek-V4.1-Flash in der kleinsten Variante (UD-IQ1_S, 233 GB auf der Platte) rund 122 GB für den Rest des Modells. Ohne Auslagern kämen 110 GB Tabelle obendrauf. Erst so wird ein 128-GB-System realistisch. Den vollen Plattenplatz brauchst du trotzdem.
Wo Tools sich verrechnen
Software, die vorab ausrechnet, ob ein Modell auf deinen Rechner passt, kannte diesen Fall zunächst nicht. In Unsloth Studio stand DeepSeek V4.1 nicht auf der Liste der „lazy“ gelesenen Modelle. Studio zählte die 110,6 GB große Tabelle deshalb komplett zum RAM-Bedarf. Auf einem Testsystem mit 120 GiB RAM und 32-GB-GPU warnte es, rund 186 GB müssten aus dem Arbeitsspeicher laufen (PR #14444). Diesen Entwurf hat Unsloth nicht übernommen, sondern durch den umfassenderen PR #14465 ersetzt, der am 26. Oktober eingeflossen ist. Seitdem führt Studio Tabellen von DeepSeek V4.1, Qwen4-Exp und Gemma 4 als eigenen Posten. Bei 24 GB VRAM und 64 GB RAM schrumpfte der angezeigte Fehlbetrag damit von etwa 132 auf 29 GiB. Wer andere Rechner-Tools nutzt, sollte deren Angaben bei solchen Modellen skeptisch prüfen. Auch Kronk hat dazu ein offenes Issue.
Die Grenzen
- mlock und no-mmap: Laut der orcarouter-Model-Card holen
--mlockoder--no-mmapalle 110 GB in den RAM. In neueren Builds laufen diese Optionen über-lm/--load-mode. Auch-lzm offoder ein Build vor b11870 heben den Vorteil auf. - Lange Eingaben: Beim Prefill, dem Einlesen des Prompts, braucht das Modell Tausende Zeilen auf einmal. Jede noch nicht geladene Zeile holt per mmap eine ganze 4-KiB-Seite für rund 90 Byte und wartet einzeln darauf. In PR #28136 kam eine RTX 5090 unter Windows so auf 167 statt 621 Tokens/s. Diese Direktlese-Variante wurde nicht übernommen, Nachfolger sind noch offen. Unsloth berichtet für gestreamte Tabellen Prefill-Werte zwischen 140 und 3.158 Tokens/s und einen Serverdurchsatz, der im RAM 1,6- bis 2-mal höher liegt.
- Das 3-Prozent-Versprechen: Die weniger als 3 Prozent Verlust aus dem Paper (Dense-4B: −1,9 %, Dense-8B: −2,8 %) gelten für eine Tabelle im DRAM einer H800. Für SSDs liefern sie keinen Beleg. Auch kleine Modelle verlieren: Bei Gemma 4 E4B kostete das Lazy-Lesen in PR #27794 etwa 8 bis 11 Prozent Ausgabetempo.
- Ausreißer und Plattentyp: Capacity maß einzelne Lesezugriffe von bis zu 36,8 ms. Eine Festplatte mit rund 30 ms verpasst jedes Zeitfenster. Unsloth prüft den Plattentyp nicht. Auf integrierten GPUs liest llama.cpp die Tabelle ohnehin komplett in den Speicher.
- Die Experten bleiben das Problem: Messungen wie 4 bis 11 Tokens/s für V4.1 Flash auf 12-GB-Karten stammen vom Engine-Entwickler Strata selbst. Langsam ist dort das Nachladen der Experten, nicht die Tabelle.
- Inhaltliche Kritik: Die Tabellen sind nach dem Training eingefroren und lernen nichts Neues. Die Autoren von Memory Grafting nennen es „teuer und manchmal wirkungslos“, die Tabellen von Grund auf zu trainieren. NVIDIA bezeichnet die Umwandlung der Tabelle von FP8 in MXFP4 als verlustbehaftet.
Einordnung
Engram ist die zweite große Sparidee nach MoE. MoE spart Rechenarbeit, Engram spart teuren Grafikspeicher, weil es auswendig gelerntes Wissen in billigen Speicher verlagert. Dass DeepSeek, Qwen und Tencent sie binnen weniger Monate übernehmen, ist ein starkes Signal. Laut The Next Web legt Qwen die Tabellen ausdrücklich für Beschleuniger mit wenig Speicher aus. Die Gewinne in den Benchmarks stammen bisher aber fast nur von den Herstellern selbst, eine unabhängige Nachprüfung des Papers fehlt.
Unsere Einschätzung: Für dich zu Hause ist Engram eine gute Nachricht mit Kleingedrucktem. Die Tabellen dürfen tatsächlich auf der NVMe liegen, ohne das Schreibtempo spürbar zu bremsen. Dafür brauchst du aktuelle Software, mmap muss an bleiben, und du musst langsameres Einlesen langer Prompts in Kauf nehmen. An den großen Angaben ändert sich trotzdem wenig: Ein 224B-Modell mit 64B Engram braucht im RAM ungefähr so viel Platz wie ein 160B-Modell. Spannend wird es, wenn die angekündigten kleinen Qwen4-Modelle und ein offenes Hy4 flash erscheinen. Dann zeigt sich, ob die dritte Spalte auf normalen PCs den Unterschied macht.
Quellen
- arXiv: Conditional Memory via Scalable Lookup (Engram-Paper) arxiv.org
- arXiv HTML: Engram-Paper (Details, Ablationen, Offload-Messung) arxiv.org
- GitHub: deepseek-ai/Engram github.com
- vLLM-Dokumentation: Engram docs.vllm.ai
- vLLM-Rezept: DeepSeek-V4.1-Flash recipes.vllm.ai
- vLLM-Rezept: Qwen3.8-Flash-Next recipes.vllm.ai
- Hugging Face: deepseek-ai/DeepSeek-V4.1-Flash huggingface.co
- GitHub: llama.cpp Release b11870 github.com
- GitHub: llama.cpp PR #27794 (TENSOR_READ_LAZY) github.com
- GitHub: llama.cpp PR #28136 (Direktlesen der PLE-Tabelle) github.com
- GitHub: llama.cpp PR #27742 (qwen4exp-Unterstützung) github.com
- Hugging Face: ISTA-DASLab/DeepSeek-V4.1-Flash-1017-GSQ-RCO-GGUF huggingface.co
- Hugging Face: orcarouter/DeepSeek-V4.1-Flash-1017-abliterated-GGUF huggingface.co
- GitHub: unslothai/unsloth PR #14444 github.com
- GitHub: unslothai/unsloth PR #14465 github.com
- Unsloth Docs: DeepSeek-V4.1-Flash unsloth.ai
- Rohit Ghumare: A 763B Model on a 12 GB Card rohitghumare.com
- Capacity Technologies: Engrams in DeepSeek 4.1 auf der SSD capacity.at
- OpenClawDC: DeepSeek V4.1 Flash GSQ-RCO Quants openclawdc.com
- Hugging Face Transformers: Qwen4-Exp huggingface.co
- Qwen-Blog: Qwen4-Max qwen.ai
- Google Developers Blog: Gemma 3n Developer Guide developers.googleblog.com
- InfoQ China: Hy4 flash infoq.cn
- ChainCatcher: Hy4 flash, 224B gesamt, 12B aktiv chaincatcher.com
- Jiemian: Tencent veröffentlicht Hy4 flash jiemian.com
- arXiv: Memory Grafting arxiv.org
- arXiv: Pooling Engram Conditional Memory using CXL arxiv.org
- DEV Community: The Lookup Table That Beat 17 Experts dev.to
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.