
Erst träumen, dann greifen: Wie World Action Models Roboter steuern und was das kostet
Runway, Nvidia und Huawei setzen auf ein neues Rezept für Roboter-KI: Ein Videomodell stellt sich die nächsten Sekunden vor, ein kleines Zusatzmodul macht daraus Bewegungen. Wir erklären das Prinzip und vergleichen es mit den bisherigen VLA-Modellen und mit Agenten, die Robotercode schreiben. Unsere Zahlen zeigen, warum die neuen Modelle robuster, aber bis zu 83-mal langsamer sind.
Darum geht es
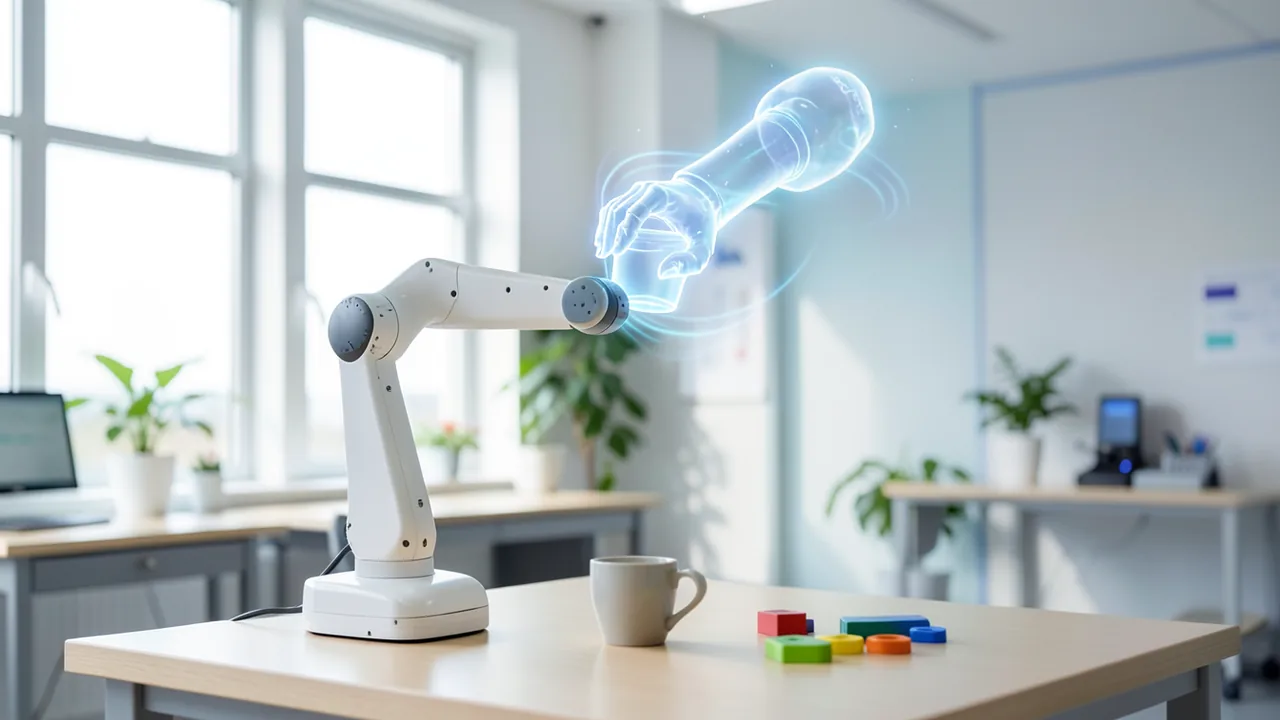
Innerhalb weniger Wochen sind mehrere große Robotermodelle unter einem neuen Etikett erschienen: World Action Model, kurz WAM. Runway hat am 11. November Praxis-1 mit offenen Gewichten freigegeben. Nvidia bewirbt DreamZero, und Huawei Cloud hat am 16. November CloudRobo-WM1.2 vorgestellt. Hinter dem Etikett steckt eine einfache Idee: Ein Roboter soll sich vorstellen, wie die nächsten Sekunden aussehen, und erst dann zugreifen. Wir erklären das Prinzip, vergleichen es mit den bisher üblichen Modellen und mit einem dritten Ansatz und prüfen eine Behauptung mit Zahlen: WAMs sind robuster, aber deutlich langsamer.
Das Prinzip: Ein Videomodell träumt, ein Experte übersetzt
Bisherige Robotermodelle starten meist von einem Sprach-Bild-Modell. WAMs starten von einem vortrainierten Videogenerator. Der hat aus riesigen Mengen Video gelernt, wie Hände greifen, wie Dinge fallen und wie sich Szenen verändern. Laut Nvidias Übersichtsartikel von Moritz Reuss sagen WAMs „sowohl künftige Zustände als auch Roboteraktionen“ voraus. Nvidia unterscheidet drei Varianten:
- Erst Video, dann Aktion: Das Modell erzeugt ein Zukunftsvideo und leitet daraus die Bewegung ab, zum Beispiel UniPi und LingBot-VA.
- Beides gleichzeitig: Video und Aktionen entstehen im selben Rechenvorgang, zum Beispiel DreamZero und GR-1.
- Nur noch die Vorstellung nutzen: Video wird nur im Training vorhergesagt, beim Einsatz wird kein Bild mehr erzeugt, zum Beispiel Fast-WAM.
Wie das konkret aussieht, zeigt Praxis-1. Den Kern bildet Runways Video-Diffusionsmodell mit 26,9 Milliarden Parametern. Diffusion heißt, dass das Bild schrittweise aus Rauschen herausgearbeitet wird. Das Modell ist ein Mixture of Experts, also in viele Teilnetze aufgeteilt, von denen pro Token nur rund 2,8 Milliarden Parameter rechnen. Daneben sitzt ein kleiner Action Expert mit 16 Schichten und etwa 314 Millionen Parametern. Er liest über Querverbindungen acht Blöcke des Videomodells mit. Die Information fließt dabei nur in eine Richtung, vom Videomodell zum Experten. Pro Aufruf liefert Praxis-1 sechs vorhergesagte Video-Frames und 24 Bewegungsbefehle bei 15 Hz, also 1,6 Sekunden Bewegung. Diesen Block nennt man Action Chunk.
DreamZero baut auf Wan 2.1 mit 14 Milliarden Parametern auf und kommt ohne getrennten Experten aus: Laut Nvidia ist die Aktion dort „nur eine weitere erzeugte Modalität im selben Entrauschungsprozess“. Huawei nennt seine Architektur DualAct. Ein gemeinsames Weltmodell-Rückgrat soll die Szene darstellen, DualAct die Aktionen erzeugen. Es gibt vier kombinierbare Betriebsarten (World oder Expert Action, Joint oder Action-only). Details nennt Huawei nicht, auch keine Parameterzahl.
PAN 2 von der MBZUAI wird oft in einem Atemzug genannt, passt aber nicht ganz in diese Reihe. Das Modell erzeugt aus Szene und geplanter Handlung ein Video. Ein Agent nutzt diese Simulation, um zwischen Plänen zu wählen. Motorbefehle gibt PAN 2 nach allem, was wir gefunden haben, nicht aus. Es ist eher ein Planungswerkzeug als eine Robotersteuerung.
Der Unterschied zu VLAs wie π0.5
Das bisherige Standardrezept heißt VLA (Vision-Language-Action). Ein Sprach-Bild-Modell sieht das Kamerabild, liest die Anweisung und gibt direkt Bewegungen aus. Der bekannteste offene Vertreter ist π0.5 von Physical Intelligence. Ein VLA weiß dadurch viel über Wörter und Objekte, aber wenig darüber, wie sich die Welt in den nächsten Sekunden verändert. WAMs bringen genau dieses Wissen über Bewegung und Physik aus dem Videotraining mit. Laut Runway skaliert die Leistung deshalb mit der Menge an Video statt mit teuren, ferngesteuerten Roboterdemonstrationen.
Das hat seinen Preis. Nvidia schätzt, dass WAM-Sequenzen oft etwa zehnmal so lang sind wie die eines VLA. Der Ansatz tausche „Effizienz bei Roboterdaten gegen Rechenkosten“.
Was die Robustheitsstudie zeigt
Die Studie „Do World Action Models Generalize Better than VLAs?“ (Zhang et al., arXiv 2603.22078, aktuelle Version vom Juli 2026) hat Modelle unter Störungen getestet: anderes Licht, Bildrauschen, verschobene Objekte, neue Kameraposition. Ein Auszug:
| Störung | π0.5 (RoboTwin) | LingBot-VA (WAM) | Fast-WAM (WAM) | π0.5 (LIBERO) | Cosmos-Policy (WAM) |
|---|---|---|---|---|---|
| Licht | 49,6 % | 89,0 % | 88,8 % | 96,9 % | 96,5 % |
| Rauschen | 64,9 % | 80,9 % | 76,4 % | 89,7 % | 92,7 % |
| Layout | 56,8 % | 87,9 % | 83,2 % | 85,7 % | 82,2 % |
| Kamera | 45,6 % | 28,9 % | 30,4 % | 75,4 % | 75,8 % |
| Roboter-Startpose | 27,6 % | 36,2 % | 53,2 % | 77,5 % | 63,3 % |
| Gesamt | 58,6 % | 74,2 % | 72,7 % | 85,7 % | 82,2 % |
Auf RoboTwin 2.0-Plus halten die WAMs Licht, Rauschen und Layoutänderungen deutlich besser aus. Bei einer verschobenen Kamera schneiden sie aber schlechter ab. Auf LIBERO-Plus ist π0.5 sogar das robusteste Modell der ganzen Studie. Die Autoren schreiben, π0.5 könne mit WAMs mithalten, brauche dafür aber umfangreiches Training auf vielfältigen Roboterdaten. Alle Tests liefen in der Simulation.
Der Preis: bis zu 83-mal so viel Rechenzeit
Dieselbe Studie hat gemessen, wie lange ein Modellaufruf dauert:
| Modell | Typ | Aktionen pro Aufruf | Zeit pro Aufruf | Faktor zu π0.5 |
|---|---|---|---|---|
| π0.5 | VLA | 50 | 63 ms | 1,0× |
| Fast-WAM* | WAM | 32 | 190 ms | 3,0× |
| X-VLA | VLA | 30 | 195 ms | 3,1× |
| GE-Act | WAM | 36 | 300 ms | 4,8× |
| Cosmos-Policy | WAM | 16 | 390 ms | 6,2× |
| LingBot-VA (Real-Setup) | WAM | 32 | 480 ms | 7,6× |
| MOTUS | VLA+Weltmodell | 16 | 1.175 ms | 18,6× |
| LingBot-VA (RoboTwin) | WAM | 32 | 5.230 ms | 83,0× |
*Der Wert stammt aus dem Fast-WAM-Paper und wurde nicht neu gemessen.
Wichtig für die Einordnung: Die Zeiten gelten pro Aufruf, nicht pro einzelner Aktion. Pro Aufruf liefern die Modelle unterschiedlich viele Aktionen. Außerdem schwanken die Angaben für π0.5: Das Light-WAM-Paper nennt 76 ms, Nvidia zitiert aus dem Fast-WAM-Paper etwa 190 ms. Fairer ist der Echtzeitfaktor, also Rechenzeit pro Sekunde Roboterbewegung. Black Forest Labs misst auf einer B200-GPU für π0.5 0,032 und für Cosmos 3 Nano 0,150, fast fünfmal so viel. Das eigene Modell FLUX 3 Action kommt nach Destillation, bei der das Modell lernt, mit weniger Rechenschritten auszukommen, auf 0,015.
Auch Praxis-1 ist kein Echtzeit-Wunder. Auf einer H100 dauert ein Aufruf laut Runway im Mittel 522 bis 545 ms, etwa ein Drittel der gelieferten 1,6 Sekunden Bewegung. Mit dem optionalen „Real-Time Chunking“ sind es 124 bis 128 ms. DreamZero erreicht laut Paper 7 Hz im geschlossenen Regelkreis, aber nur nach starken Optimierungen. Das Projekt-README nennt laut Sekundärquellen rund 0,6 Sekunden auf GB200 und etwa 3 Sekunden auf H100.
Die Forschung arbeitet an Gegenmitteln. Fast-WAM verzichtet beim Einsatz ganz auf das Zukunftsvideo und findet, dass der Nutzen vor allem aus dem Videotraining kommt, nicht aus dem Träumen zur Laufzeit. Light-WAM (arXiv 2606.08242) schrumpft das Prinzip auf 1,99 Milliarden Parameter, 72 ms und 4,1 GB Grafikspeicher. Damit liegt es auf π0.5-Niveau, auf RoboTwin 2.0 mit 76,4 Prozent aber deutlich hinter Fast-WAM (91,9 Prozent).
Jeder ist irgendwo Erster
| Modell | Wo Erster (laut Hersteller) | Gegencheck |
|---|---|---|
| Praxis-1 | RoboLab-120: bestes WAM und bestes offenes Modell, 46,2 % | Gesamt Platz 5. Vorn liegen zwei Sprachmodell-Agenten (AMP1 86,0 %, SenseNova-RoboRSI 57,1 %), Lakeside und BiMind v0.5 |
| DreamZero | RoboArena April 2026: Elo 1750 vs. π0.5 mit 1622 | RoboLab-120: 25,7 %, hinter π0.5 (28,0 %). RoboArena im Juni laut eWeek: Platz 3 |
| CloudRobo-WM1.2 | RoboTwin 2.0 (88,98 %) und LIBERO-Pro 2.0 (81,7 %), laut Folien bei der Vorstellung | Auf keiner der anderen Listen. Eine öffentliche LIBERO-Pro-2.0-Rangliste haben wir nicht gefunden |
Die einzige gemeinsame Referenz ist π0.5. Direkt vergleichen lassen sich die drei WAMs nicht. Bei RoboTwin kommt hinzu, dass es mehrere Testprotokolle gibt. Der Hersteller Dasheng meldete im Juni für sein Modell Kairos 96,1 Prozent, offenbar unter anderen Bedingungen.
„Open Source“ ohne Gewichte
Huawei Cloud bezeichnet CloudRobo-WM1.2 als quelloffen und will außerdem das Trainingsframework und Best Practices für seine Ascend-Rechenplattform freigeben. Laut Pandaily nannten die Unterlagen aber keinen Download-Ort. Auch wir haben weder Gewichte noch ein Repository gefunden. Praxis-1 (Apache 2.0) und PAN 2 (Apache 2.0) kann man dagegen herunterladen.
Der dritte Weg: Code as Policy
Statt Bewegungen zu träumen, kann ein KI-Agent auch einfach Robotercode schreiben. Bei ACE-CaP-0 von ACE Robotics entwickelt Claude Opus 5.5 ein Programm, testet es und bittet bei Bedarf um eine Vorführung durch einen Menschen oder um eine Simulation. Danach wird das Programm eingefroren und läuft ohne Agent. In acht realen Aufgaben gelangen 221 von 240 Versuchen (92,1 Prozent). Einen Vergleich mit VLAs oder WAMs enthält das Paper nicht. Die Autoren räumen ein, dass nicht belegt ist, ob mehrere Entwicklungsläufe gleich gut ausfallen. CaP-X von Nvidia, Berkeley, Stanford und CMU zeigt, dass Agenten bei geänderten Anweisungen besser abschneiden als π0.5, bei verschobenen Objekten aber nur vergleichbar. Auf RoboLab-120 belegen Agentensysteme bereits die ersten beiden Plätze.
Diesen Weg geht nun auch OpenAI. Laut Fortune hat das Unternehmen sein eigenes Robotikteam aufgelöst und die Mitarbeiter in die Forschungs- und Anwendungsabteilungen eingegliedert. Begründung: Allgemeine Modelle wie GPT-6 Astra ließen sich direkt auf Roboter anwenden. CMU-Forscher Guanya Shi sieht trotzdem Bedarf an kleinen Modellen direkt im Roboter, weil Cloud-Modelle Verzögerung und Netzabhängigkeit mitbringen.
Einordnung
Unsere Einschätzung: WAMs sind keine Mode, sondern eine plausible Antwort auf den Datenmangel in der Robotik. Videos gibt es fast unbegrenzt, Roboterdemonstrationen nicht. Die Robustheitsvorteile sind aber bisher nur in der Simulation gemessen und hängen stark vom Benchmark ab. Die Rechenzeit ist das eigentliche Problem: Ein Modell, das pro Entscheidung eine halbe Sekunde auf einer H100 braucht, gehört nicht ohne Weiteres in einen akkubetriebenen Roboter. Fast-WAM und Light-WAM deuten an, wohin es geht. Behalten wird das Videotraining, wegfallen soll das Träumen zur Laufzeit. Nvidias eigenes Fazit lautet, dass „noch niemand wirklich weiß, was am besten funktioniert“, und Nvidia rechnet mit Mischformen aus WAM und VLA. Ranglisten-Siege einzelner Hersteller solltest du bis dahin mit Vorsicht lesen. Bei Huawei gilt das doppelt, solange niemand die Gewichte prüfen kann.
Quellen
- NVIDIA Technical Blog: Pretrained to Imagine, Fine-Tuned to Act – The Rise of World Action Models developer.nvidia.com
- arXiv: Do World Action Models Generalize Better than VLAs? A Robustness Study arxiv.org
- arXiv HTML: Robustheitsstudie (Tabellen) arxiv.org
- Runway Research: Praxis-1 – Video Pretraining to Robot Control runway.com
- Runway News: Praxis-1 is now available runway.com
- NVIDIA RoboLab-120 Leaderboard research.nvidia.com
- arXiv: DreamZero – World Action Models are Zero-shot Policies arxiv.org
- Pandaily: Huawei Cloud Releases CloudRobo-WM1.2 pandaily.com
- IT之家: 华为云发布并开源 CloudRobo-WM1.2 ithome.com
- CNMO: 华为云发布并开源昇腾原生世界模型 ai.cnmo.com
- arXiv: ACE-CaP-0 – Real-World Code-as-Policies in the Era of Experience arxiv.org
- Pandaily: ACE Robotics' ACE-CaP-0 pandaily.com
- arXiv: CaP-X / CaP-Agent0 arxiv.org
- arXiv: Light-WAM arxiv.org
- arXiv: Fast-WAM arxiv.org
- Black Forest Labs: FLUX 3 Action bfl.ai
- humanoid.guide: OpenAI disbands robotics team (nach Fortune) humanoid.guide
- It Can Think (Substack): What Do Robotics Leaderboards Tell Us itcanthink.substack.com
- eWeek: Spirit AI tops Nvidia in Physical AI Ranking eweek.com
- GitHub: LIBERO-PRO github.com
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.