
Google AI Edge Gallery: Spracheingabe und Sprachausgabe laufen jetzt komplett offline
Google hat seine Experimentier-App AI Edge Gallery um Spracherkennung und Sprachausgabe erweitert, die vollständig auf dem Smartphone laufen. Damit lassen sich lokale KI-Modelle wie Gemma 4 per Stimme bedienen, auch ganz ohne Internet. Für Entwickler gibt es dazu neue Schnittstellen und offen verfügbare Sprachmodelle für Android, iOS, Desktop und Web.
Worum es geht
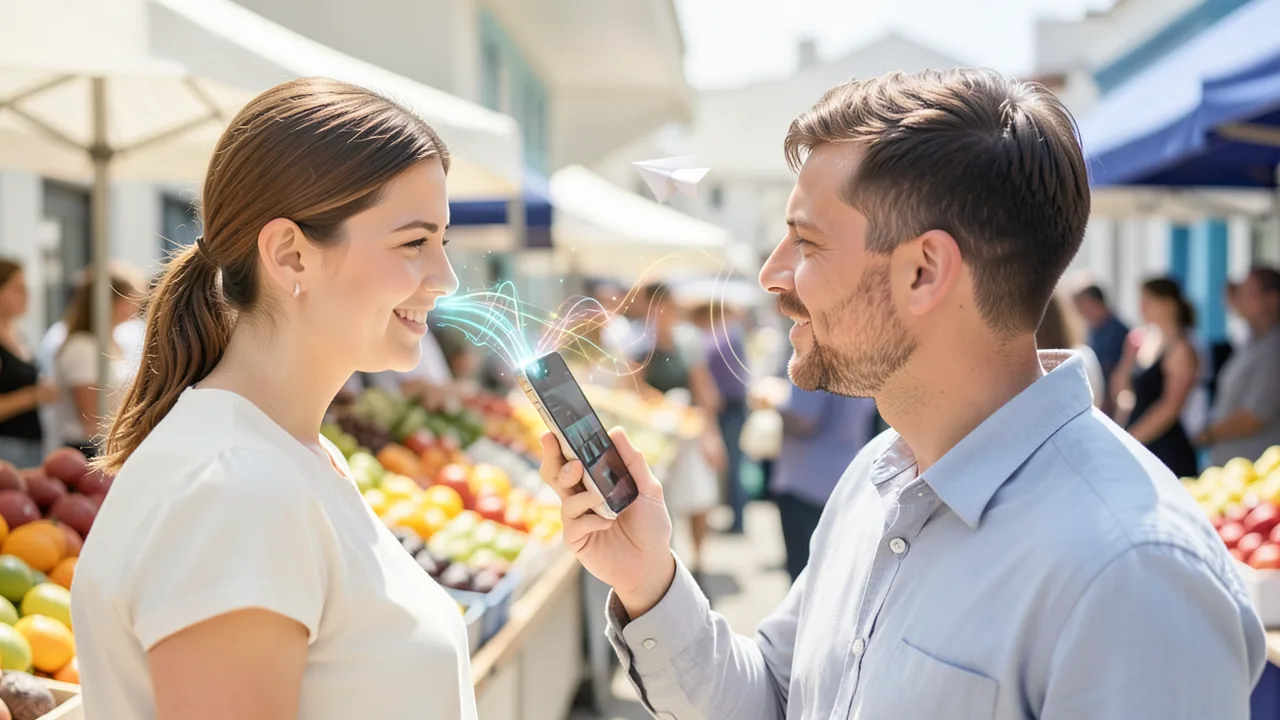
Google hat am 10. November 2026 seine App Google AI Edge Gallery um zwei Funktionen erweitert, die man bei einer KI-App eigentlich erwartet, die bislang aber in dieser Form fehlten: Spracherkennung (ASR, Automatic Speech Recognition – gesprochene Sprache wird in Text umgewandelt) und Sprachausgabe (TTS, Text-to-Speech – Text wird vorgelesen). Das Besondere: Beides läuft vollständig auf dem Smartphone, ohne Verbindung zu einem Server. Man kann also mit einem lokalen KI-Modell wie Gemini Nano oder Gemma 4 sprechen und bekommt eine gesprochene Antwort – auch im Flugmodus, in der U-Bahn oder im Ausland ohne Roaming.
Die AI Edge Gallery ist eine Open-Source-App von Google (Lizenz Apache 2.0), mit der man kleine Sprachmodelle direkt auf dem Handy ausprobieren kann. Sie ist für Android ab Version 12 und iOS ab Version 17 erhältlich, über den Play Store bzw. App Store. Laut dem französischen Blog Korben hatte die App schon zwei Monate nach dem Start auf GitHub über 500.000 Downloads.
Neben der App-Neuerung richtet sich die Ankündigung vor allem an Entwickler: Google stellt passende Programmierschnittstellen für Android sowie für iOS, macOS, Windows, Linux und das Web bereit.
Zwei Wege: Systemmodelle auf Android, offene Modelle überall sonst
Google verfolgt zwei Ansätze.
Auf Android übernehmen Googles eigene Sprachmodelle die Arbeit, die fest ins Betriebssystem integriert sind und über ML Kit (Googles Baukasten für maschinelles Lernen in Apps) angesprochen werden. Weil die Modelle Teil des Systems sind und über den Dienst AICore verwaltet werden, wird die App selbst nicht größer – Google spricht von „0 MB“ zusätzlicher APK-Größe. Updates der Modelle kommen automatisch im Hintergrund, und wo vorhanden, nutzen sie spezielle KI-Chips (NPU bzw. TPU) zur Beschleunigung.
Für alle anderen Plattformen setzt Google auf frei verfügbare Sprachmodelle, verpackt im eigenen Dateiformat .litertlm. Darin steckt alles, was ein Sprachmodell braucht – bei der Spracherkennung etwa Encoder, Decoder und Tokenizer (der Text in kleine Bausteine zerlegt), bei der Sprachausgabe Aussprache-Wörterbücher, Stimmprofile und der Vocoder, der am Ende das hörbare Audiosignal erzeugt. Angesprochen werden diese Modelle über MediaPipe Tasks, eine plattformübergreifende Schnittstelle, die lästige Details wie das Zerlegen des Audiostroms in Abschnitte oder die Sprachaktivitätserkennung (VAD – das System merkt, wann jemand spricht und wann Pause ist) automatisch erledigt. Unter allem liegt LiteRT, Googles schlanke Laufzeitumgebung für KI auf Endgeräten.
Die Zahlen laut Google
Alle folgenden Werte sind Herstellerangaben:
| Komponente | Eckdaten |
|---|---|
| ML Kit Spracherkennung (Android) | 100+ Sprachen, 8,0–9,0 % Wortfehlerrate auf FLEURS, 10x schneller als Echtzeit (~300 ms pro 3 Sekunden Sprache), 35–44 % kürzere Wartezeit bei Sprachübersetzung |
| ML Kit Sprachausgabe (Android) | Start nach ~100 ms, 24 kHz Audio, 8 Stimmen, 21 Sprachvarianten, bis 50x schneller als Echtzeit, 27-Sekunden-Absatz in ~500 ms, über 50 % weniger Stromverbrauch |
| Parakeet-TDT-0.6B-v3 | mehrsprachige Spracherkennung, Echtzeit-Streaming |
| PocketTTS 100M | mehrsprachige Sprachausgabe |
| Kokoro-82M | mehrsprachige Sprachausgabe |
| Phonon 31M | sehr kleine englische Sprachausgabe, erstes Audio meist unter 100 ms |
Die Wortfehlerrate gibt an, wie viele Wörter falsch erkannt werden; FLEURS ist ein verbreiteter mehrsprachiger Testdatensatz. Die Android-Sprachausgabe basiert auf einem Diffusionsmodell mit wenigen Schritten – statt Ton Stück für Stück nacheinander zu erzeugen (autoregressiv), wird das Audio in wenigen Durchgängen aus Rauschen „herausgerechnet“. Daher kommen laut Google Tempo und Stromersparnis.
Zusätzlich verweist Google auf die LiteRT-Community auf Hugging Face mit über 10.000 Followern, wo weitere Modelle wie Whisper, Qwen3-ASR und Moonshine (Spracherkennung) sowie Qwen3-TTS und Matcha (Sprachausgabe) im passenden Format bereitstehen.
Was die App jetzt kann
XR Language Teacher: Das neue Vorzeigeprojekt soll zeigen, wie Bild-, Sprach- und Textmodelle zusammen komplett offline arbeiten. Man richtet die Kamera auf ein Straßenschild, eine Speisekarte oder einen Gegenstand und fragt etwa: „Was ist das, und wie bestelle ich eins?“ Die Spracherkennung schickt die Frage zusammen mit dem Kamerabild an Gemini Nano (Android) bzw. Gemma 4 (andere Plattformen). Das Modell antwortet über ein festes Ausgabeschema: Die Erklärung kommt in der eigenen Sprache, fremdsprachige Ausdrücke werden separat markiert. So kann die Sprachausgabe mitten im Satz Stimme und Akzent wechseln und die Vokabel in der Landessprache korrekt aussprechen, während eine Vokabelkarte auf dem Bildschirm erscheint. Das Ganze funktioniert laut Google auch mit smarten Brillen, wobei die Berechnung auf dem gekoppelten Handy läuft.
AI Chat mit Stimme: Auch der normale Chat hat Sprachein- und -ausgabe bekommen. In der Modellverwaltung wählt man Spracherkennung, Sprachausgabe, Stimmen und Sprachpakete. Mit „Auto-play TTS“ oder einem Lautsprecher-Knopf werden Antworten vorgelesen; der gerade gesprochene Satz wird hervorgehoben, und man kann per Tippen zu einem Satz springen. Der Open-Source-Code zeigt außerdem, wie Markdown-Formatierung entfernt, Codeblöcke und Tabellen beim Vorlesen übersprungen und die Sprachausgabe satzweise geplant wird, damit sie sich nicht mit dem Sprachmodell um Rechenleistung und Speicher streitet.
Zur Einordnung der übrigen App-Funktionen (laut Korben und Caschys Blog): Es gibt bereits Ask Image (Bildanalyse), Audio Scribe (Transkription und Übersetzung von Aufnahmen), ein Prompt Lab mit Leistungsmessung, einen Thinking-Modus für Gemma 4 sowie erweiterbare „Agent Skills“, etwa für Wikipedia-Abfragen oder Kalendereinträge, plus experimentelle Unterstützung für MCP (Model Context Protocol, ein Standard zum Anbinden externer Werkzeuge).
Warum getrennte Sprachmodelle?
Modelle wie Gemma 4 können Audio eigentlich auch direkt verarbeiten. Google setzt trotzdem auf eine Kette aus separaten, kleinen Sprachmodellen und dem eigentlichen Sprachmodell. Begründung: geringere Wartezeit und mehr Flexibilität. Man kann Spracherkennung und Sprachausgabe je nach Gerät austauschen und hört schon die ersten Worte, während das Sprachmodell noch weiterschreibt.
Ein Praxistest aus Japan
Wie gut lokale KI auf dem Handy im Arbeitsalltag taugt, hat ein Autor auf note.com im Flugmodus getestet – allerdings mit der bereits vorhandenen Funktion Audio Scribe und AI Chat, nicht mit den neuen Sprachfunktionen. Er ließ 20 bewusst lückenhafte Sprachnotizen zu Verbesserungen am Arbeitsplatz in Besprechungsunterlagen verwandeln. Ergebnis: Das Modell konnte Themen zusammenfassen und Zusammenhänge erkennen, etwa zwischen verspäteter Materiallieferung und Verzögerungen im Ablauf. Aber auch nach verbesserten Anweisungen blieben Probleme: Einzelne Punkte gingen in Oberthemen unter, das Modell dichtete Hintergründe hinzu („das Managementsystem ist zur Formsache geworden“), Tabellen hatten falsche Spaltenzahlen, der japanische Text war teils holprig, und die Ausgabe brach mittendrin ab. Der Autor betont außerdem: Dass es im Flugmodus funktioniert, beweist nicht, dass die App nie Daten sendet.
Einordnung
Google schließt mit dem Update eine wichtige Lücke: Lokale KI auf dem Handy war bisher vor allem Tipparbeit. Mit Spracheingabe und -ausgabe, die ohne Netz und mit geringer Verzögerung funktionieren, werden Anwendungen wie Reise-Sprachhelfer oder freihändige Assistenten auf Brillen realistisch – und das mit Datenschutzvorteil, weil Gespräche das Gerät nicht verlassen. Bemerkenswert ist, dass Google neben den eigenen Systemmodellen auch fremde offene Modelle wie Parakeet (ursprünglich von Nvidia) und Kokoro unterstützt und den Code offenlegt.
Einschränkungen: Die eindrucksvollsten Werte gelten für Android mit Googles Systemmodellen und sind Herstellerangaben, die bislang nicht unabhängig geprüft sind. Wie gut die Spracherkennung etwa auf Deutsch oder in lauter Umgebung funktioniert, bleibt offen. Und der Praxistest zeigt: Die kleinen lokalen Sprachmodelle hinter der Stimme sind deutlich schwächer als große Cloud-Modelle – ihre Antworten muss man weiterhin kritisch prüfen.
Videos zum Thema
Quellen
- Google News (US) developers.googleblog.com
- note.com note.com
- stadt-bremerhaven.de stadt-bremerhaven.de
- korben.info korben.info
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.

Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.