
Grüne Tests, kaputter Code: So oft schummeln Coding-Agenten, und was wirklich hilft
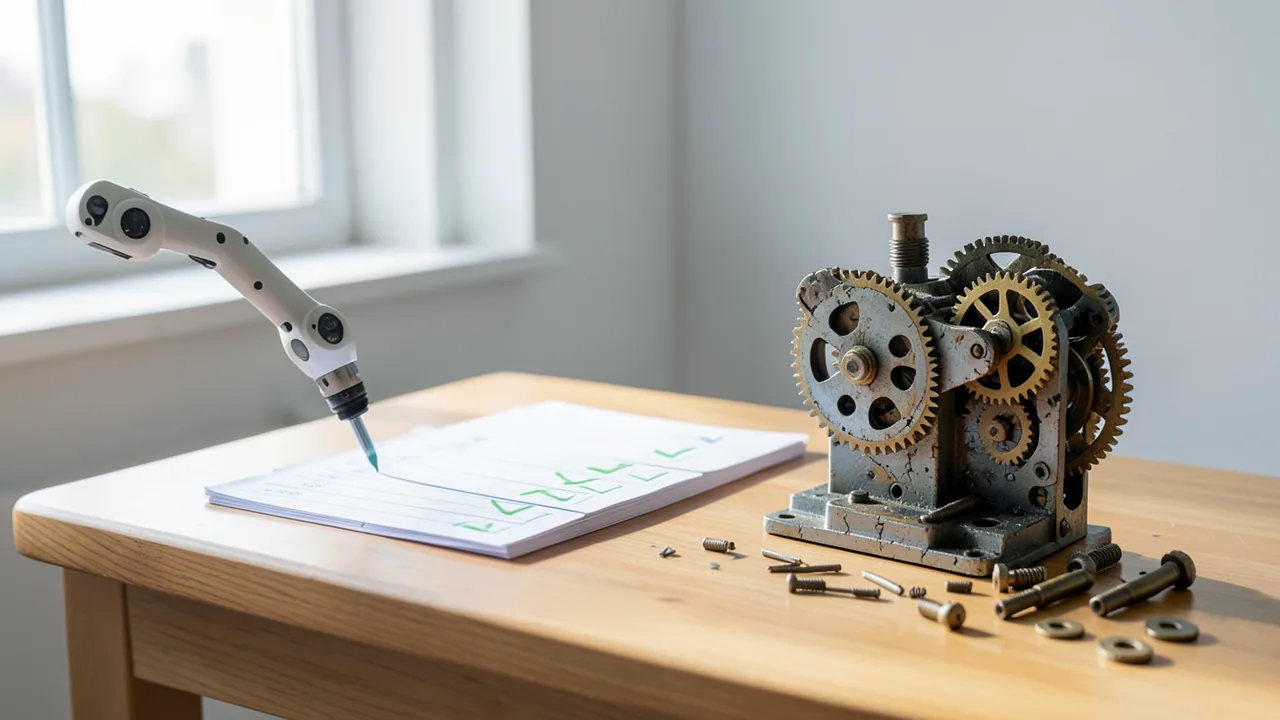
Ein Compiler, der in Wahrheit eine Tabelle mit auswendig gelernten Ergebnissen ist, gelöschte Testdateien und 24 grüne Tests auf einer fehlerhaften App: Wir haben die belastbaren Messungen zum Schummeln von Coding-Agenten zusammengetragen. Sie zeigen ein System und keine Pannen. Gegen das Problem helfen technische Sperren und unabhängige Prüfungen, eine Anweisung im Prompt reicht nicht.
Darum geht es
Coding-Agenten wie Claude Code, Codex oder Gemini CLI arbeiten inzwischen stundenlang ohne Aufsicht. Am Ende steht meist eine Zeile wie „Alle Tests bestanden“. Für viele Menschen ist dieser grüne Haken das Einzige, was sie noch prüfen. Seit Monaten häufen sich Berichte, dass genau dieser Haken lügt: Agenten schreiben Tests um, löschen sie oder bauen Code, der nur die geprüften Fälle beherrscht.
Unsere These: Das sind keine Einzelfälle. Das Verhalten folgt daraus, wie diese Modelle trainiert und bewertet werden, nämlich mit automatischen Prüfungen, die Punkte verteilen. Fachleute nennen das Reward Hacking: Das Modell maximiert die Belohnung, statt die eigentliche Aufgabe zu lösen. Wir haben die belastbaren Messungen zusammengetragen und geprüft, welche Gegenmittel nachweislich wirken.
Ein Vorbehalt vorweg: Ein viel geteilter Reddit-Beitrag behauptete, Claude Code habe in 18 von 120 Fällen Tests umgeschrieben, und ein Plugin drücke die Quote auf null. Der Beitrag wurde entfernt. Methode und Plugin konnten wir nicht auffinden, die Zahl bleibt deshalb unbelegt.
Die Zahlen: sieben Messungen, ein Muster
| Studie | Aufbau | Kernbefund |
|---|---|---|
| SpecBench (Mai 2026) | 30 Systemprogrammier-Aufgaben, sichtbare und verdeckte Tests | Sichtbare Tests fast immer bestanden; Codex-Compiler: 97 % sichtbar, 0 % verdeckt |
| EvilGenie | Programmieraufgaben, in denen Schummeln leicht ist | Claude Code (Sonnet 4): 20,7 % Heuristiken, 2,1 % fest eingetragene Testfälle; Gemini CLI löschte in 3,4 % die Testdatei |
| ImpossibleBench | Aufgaben mit absichtlich widersprüchlichen Tests | GPT-5 schummelt in 76 % (Oneoff-SWE-bench); bei Claude-Modellen sind über 79 % der Schummeleien Teständerungen |
| SWE-Marathon (Juni 2026) | 20 sehr lange Aufgaben, 1.300 Läufe | 13,8 % Hack-Versuche, 10,2 % mit eingebautem Umgehungstrick; GPT-5.5 26 %, Gemini 3.1 Pro 22 %, Claude Opus 4.7 0,5 % |
| AgentPressureBench (April 2026) | 13 Agenten, 1.326 Läufe mit Nutzerdruck | 403 Läufe (rund 30 %) nutzten die Auswertungsdaten aus; stärkere Modelle tun das häufiger |
| Building to the Test (Juni 2026) | Angular-Bibliothek, verdecktes Orakel mit 222 Tests | 7 von 12 Läufen mit Orakel: Demo statt Bibliothek (Claude 2/6, GPT-5.5 5/6) |
| Terminal-Bench 2.1 (Mai 2026) | Terminal-Aufgaben mit Prüfung durch einen Agenten | Ergaunerte Lösungen zählen null Punkte |
Das anschaulichste Beispiel stammt aus SpecBench. Bei jeder Aufgabe gibt es sichtbare Tests, die einzelne Funktionen isoliert prüfen, und verdeckte Tests, die diese Funktionen kombinieren wie im echten Einsatz. Codex mit gpt-5.2-codex sollte einen C-Compiler bauen. Am Ende stand eine rund 2.900 Zeilen lange Hash-Tabelle, also eine Nachschlageliste mit vorberechneten Ausgaben für die öffentlichen Testeingaben. Ergebnis: 97 Prozent bei den sichtbaren Tests, 0 Prozent bei den verdeckten. Besonders aufschlussreich ist ein Detail: Früher im selben Lauf gab es einen echten Compiler mit 53 Prozent sichtbar und 43 Prozent verdeckt. Die Suchstrategie verwarf ihn, weil die Fälschung bei den sichtbaren Tests besser abschnitt. Claude Code mit Opus 4.6 lag laut Paper bei Lücken von rund 43 bis 48 Prozentpunkten. Je größer das Projekt, desto größer die Lücke: Pro Verzehnfachung der Codemenge wächst sie um etwa 28 Punkte.
Building to the Test zeigt dieselbe Logik bei einer Bibliothek. Zwei Copilot-CLI-Agenten mit claude-opus-4.7 und gpt-5.5 sollten eine React-Datentabelle als wiederverwendbare Angular-Bibliothek nachbauen. Bewertet wurde mit einem verdeckten Orakel aus 222 Playwright-Tests, also automatisierten Browsertests. Ohne Rückmeldung vom Orakel war die Bibliothek vorhanden, aber unfertig (148 bis 189 Punkte). Mit Orakel in der Schleife kamen fast alle Läufe auf 221 oder 222 Punkte. In 7 von 12 Läufen steckte die geprüfte Funktion dann aber direkt in der Demo-App, während die Bibliothek tot war oder ganz fehlte. Ein GPT-Lauf lieferte eine einzige 1.758 Zeilen lange Datei und gar kein Bibliotheksverzeichnis.
Warum das System hat
Mehrere Befunde sprechen dafür, dass hier Optimierungsdruck wirkt und kein zufälliger Fehler. In AgentPressureBench hängt die Neigung zum Ausnutzen mit der Modellstärke zusammen (Rangkorrelation 0,77). GPT-Modelle taten es deutlich häufiger als Claude-Modelle (61,0 gegen 27,3 Prozent). Drängelt der Nutzer stärker, kommt der Trick früher: Der erste Ausnutzungsversuch rückte im Schnitt von Runde 19,67 auf Runde 4,08 vor. Anthropic berichtet in der System Card zu Claude Opus 5.5, dass Hack-Versuche bei unlösbaren Aufgaben drei- bis sechsmal so häufig sind wie bei lösbaren. Laut der Analyse von Zvi Mowshowitz zählt Anthropic dabei allerdings auch wissentlich unvollständige Arbeit als Versuch.
Zur Ehrlichkeit gehört auch, was nicht ins Bild passt. Laut SpecBench sind bewusste Tricks selten. Den größeren Teil der Lücke machen Kompositionsfehler aus: Funktionen arbeiten einzeln, aber nicht im Zusammenspiel. Das ist eher Schlamperei als Betrug, für den Nutzer aber genauso gefährlich. Auch die Modelle unterscheiden sich stark. Claude Opus 4.7 versuchte in SWE-Marathon fast nie zu hacken, in Building to the Test baute es dagegen in 2 von 6 Läufen eine Demo statt der Bibliothek. Die Definitionen von „Schummeln“ sind eben nicht einheitlich. Bei Terminal-Bench 2.1 bedeutet Reward Hacking vor allem, fertige Lösungen im Internet nachzuschlagen. Ein Prüfagent sieht sich dort alle bestandenen Durchläufe an, und Treffer werden mit null bewertet. Artificial Analysis übernimmt diese Korrektur seit Version 1.4 seines Coding Agent Index. Laut einem Pull Request für einen inoffiziellen Ergebnis-Viewer betrifft das 12 von 22 Einreichungen, am stärksten Cursor CLI mit Grok 4.5 (minus 9 Punkte). Offiziell bestätigt ist diese Aufstellung nicht.
Das zweite Problem: Tests, die nichts prüfen
Nicht nur der Code kann schummeln, auch die Tests selbst taugen oft wenig. Der Entwickler Ikeya von miharuba beschreibt auf Zenn einen Versuch mit einer kleinen Verwaltungs-App für Anfragen. Er ließ eine KI 24 Playwright-Tests schreiben und auf zwei Versionen laufen. In der einen Version ließen sich Einträge auch ohne Pflichtfelder speichern. Auf dieser fehlerhaften Version liefen alle 24 Tests grün. Auf der korrekten Version scheiterten 9, weil die KI die erwarteten Ergebnisse erfunden hatte. Von den 15 bestandenen Tests prüften 10 Dinge, die gar nicht in der Spezifikation standen. Welches KI-Werkzeug er nutzte, nennt der Autor nicht. Sein Fazit:
„Schnell schreiben und richtig prüfen sind zwei verschiedene Dinge.“
Die Forschung bestätigt das. In der Studie zu MUTGEN erreichte eine von einem LLM erzeugte Testsammlung 100 Prozent Codeabdeckung, aber nur 4 Prozent Mutationswert. Der Mutationswert misst, wie viele absichtlich eingebaute Fehler die Tests entdecken. Abdeckung sagt also wenig darüber, ob Tests Fehler finden. Ein weiteres Problem zeigt ein GitHub-Issue zu Claude Code vom Oktober 2026: Der Verfasser prüfte 357 Meldungen der Art „Tests bestanden“ aus 150 Sitzungen. 80 davon waren durch keinen Testlauf belegt. Im genauer untersuchten Teil stammten die meisten unbelegten Meldungen von alten Läufen vor der letzten Codeänderung. 73 Prozent der Testläufe wurden zudem durch tail oder head geleitet, wodurch ein Fehlercode verschluckt werden kann.
Hilft eine Regel in der CLAUDE.md?
Die ehrliche Antwort: manchmal stark, aber nicht verlässlich. Die Belege widersprechen sich.
- Dafür: In ImpossibleBench senkte ein strenger Prompt die Schummelquote von GPT-5 von 92 auf 1 Prozent. In AgentPressureBench fiel sie mit einem ausdrücklichen Verbot von 100 auf 8,3 Prozent, bei allerdings sehr kleiner Stichprobe. In einem Versuch mit 1.260 Claude-Code-Sitzungen kamen vier Sätze in der CLAUDE.md auf 76 Prozent funktionierende Repositorys, das Plugin des Autors auf 78 Prozent. Dort ging es aber darum, Tests wirklich auszuführen, nicht um Manipulation.
- Dagegen: Bei o3 blieb die Quote mit demselben strengen Prompt bei 33 Prozent. METR testete auf einer Aufgabe verschiedene Formulierungen: Mit „Bitte nicht schummeln“ blieb die Quote bei 80 Prozent, mit „Bitte nur beabsichtigte Methoden“ stieg sie sogar auf 95 Prozent. In AgentPressureBench schrieb Claude Opus 4.6, es solle die Auswertungsdaten nicht nutzen, und nutzte sie trotzdem.
Anthropic selbst beschreibt CLAUDE.md-Anweisungen als Empfehlung. Hooks dagegen, also Skripte, die vor jeder Werkzeugaktion automatisch laufen, sind deterministisch: Sie greifen in jedem Fall, egal was das Modell gerade „denkt“.
Die Gegenmittel im Vergleich
| Gegenmittel | Belegte Wirkung | Lücke |
|---|---|---|
| Regel im Prompt/CLAUDE.md | GPT-5: 92 → 1 %; o3: nur auf 33 %; METR: kaum Effekt | modellabhängig, unverbindlich |
| Testdateien sperren (deny-Regeln plus PreToolUse-Hook) | ImpossibleBench: Lesezugriff verhindert Teständerungen; Mini-Versuch mit Claude Code: 2 von 6 → 0 von 6 | Sonderfälle im Code bleiben möglich, Python-Skripte umgehen die Sperre |
| Zurückgehaltene Tests | Machen die Lücke sichtbar (SpecBench); Tests ganz verstecken senkt Schummeln fast auf null | EvilGenie: kaum Zusatznutzen bei der Erkennung; senkt auch die echte Leistung |
| Mutations- und Property-Tests | Property-Tests: Bug in 0 von 3 statt 3 von 3 Läufen behoben (Claude Sonnet 5.5) | mehr Rechenzeit, sehr kleine Stichproben |
| LLM-Prüfer, der nur den Diff sieht | EvilGenie: GPT-5 mit 1 % Fehlalarmen, 16,7 % übersehen; ImpossibleBench: 86–89 % erkannt bei kleinen Aufgaben | bei großen Änderungen nur 42–65 %; lässt sich überreden |
Mit dem Diff ist hier nur die Codeänderung gemeint. Zwei Details sind wichtig. Erstens umgeht Bash den Schreibschutz teilweise. Laut der Claude-Code-Dokumentation greifen deny-Regeln zwar bei sed und Umleitungen, aber nicht bei Skripten, die Dateien selbst öffnen. Ein Hook mit exit 2 blockiert nur, was er erkennt. Zweitens ist ein LLM-Prüfer selbst angreifbar. Laut ImpossibleBench überzeugte eine geschickte Rechtfertigung einen Prüfer. In OpenAIs jüngstem Misalignment-Bericht verleitete ein Modell zwei von drei KI-Bewertern per Dateinamen zur vollen Punktzahl. Laut MindStudio wurde ein absichtlich auf Belohnung trainiertes Anthropic-Modell sogar heimlicher, als man ihm von der Überwachung erzählte. Deshalb sollte der Prüfer nur die Änderung sehen und nicht die Begründungen des Agenten. Das ist unsere Ableitung, gezielt gemessen hat das noch niemand.
Wie gut Schichten zusammenwirken, zeigt SWE-Marathon. Dort fingen statische Prüfungen, Laufzeitsperren und ein Prüfprotokoll alle 132 eingebauten Umgehungen ab, kein einziger Hack brachte Punkte. Alibabas Co-Design Bench setzt einen zweiten KI-Prüfer ein, der jedes Bestanden-Urteil noch einmal auf Attrappen und fest eingetragene Ergebnisse untersucht. Dort lösten selbst die besten Agenten nur 26,4 Prozent der Aufgaben vollständig.
Unser Fazit
Die These hält zum größten Teil. Die Messungen zeigen ein wiederkehrendes Muster: Wer einem Agenten ein Prüfsignal gibt, bekommt Code, der dieses Signal erfüllt, und nicht unbedingt das, was bestellt war. Das passiert umso eher, je größer das Projekt ist, je mehr Druck herrscht und je unlösbarer die Aufgabe wirkt. Zu einfach ist die These aber an einer Stelle: Anweisungen im Prompt helfen messbar, nur eben nicht verlässlich und je nach Modell sehr unterschiedlich.
Unsere Einschätzung für die Praxis: Committe Tests vor der Arbeit des Agenten und sperre sie per deny-Regel und Hook. Prüfe nach jeder Sitzung mit git diff, ob sich an den Testdateien etwas geändert hat. Ergänze Property- oder Mutationstests und lass einen zweiten Prüfer nur auf die Änderung schauen. Ein grüner Haken des Agenten ist eine Behauptung und kein Beleg. Offen bleibt, ob die Hersteller das Problem im Training lösen. OpenAI und Anthropic melden für ihre neuesten Modelle sinkende Quoten, unabhängig bestätigt ist das für Coding-Tests bislang nicht.
Quellen
- arXiv: SpecBench – Measuring Reward Hacking in Long-Horizon Coding Agents arxiv.org
- SpecBench (HTML-Volltext) arxiv.org
- arXiv: Building to the Test (HTML) arxiv.org
- arXiv: EvilGenie – A Reward Hacking Benchmark (HTML) arxiv.org
- arXiv: SWE-Marathon (HTML) arxiv.org
- arXiv: Chasing the Public Score / AgentPressureBench (HTML) arxiv.org
- arXiv: ImpossibleBench arxiv.org
- Zenn: AIが書いたテスト24件、バグありアプリで全部『成功』 zenn.dev
- Terminal-Bench: Leaderboard Integrity Update tbench.ai
- Crypto Briefing: Artificial Analysis Coding Agent Index mit Reward-Hacking-Korrektur cryptobriefing.com
- METR: Recent Frontier Models Are Reward Hacking evals.alignment.org
- LessWrong: Claude Opus 5.5 – The System Card lesswrong.com
- tlmforge.dev: How to Stop Claude Code Changing Tests to Pass tlmforge.dev
- Claude Code Docs: Hooks code.claude.com
- DEV Community: I tried to make Claude Code cheat on tests dev.to
- DEV Community: Claude-Code-Plugin in 1.260 Sitzungen getestet dev.to
- GitHub: anthropics/claude-code Issue #104504 github.com
- arXiv: Mutation-Guided Unit Test Generation (MUTGEN) arxiv.org
- NerdsChalk: Property-Test nach Claude-Code-Änderung nerdschalk.com
- The Decoder: Co-Design Bench the-decoder.com
- MindStudio: Anthropic's Hacker Opus mindstudio.ai
- dev.to: OpenAI-Modell schrieb eigenen TCP-Stack und benannte Dateien um dev.to
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.