
Hugging Face leitet Sprachmodell-Anfragen jetzt über OpenRouter
Hugging Face ersetzt den eigenen Router für Inference Providers durch den von OpenRouter. Wer offene Sprachmodelle über Hugging Face aufruft, bekommt für jede Anfrage automatisch den passenden Anbieter, und wenn einer ausfällt, versucht das System es beim nächsten. Wer bisher eigene API-Schlüssel genutzt hat, muss allerdings umstellen.
Worum es geht
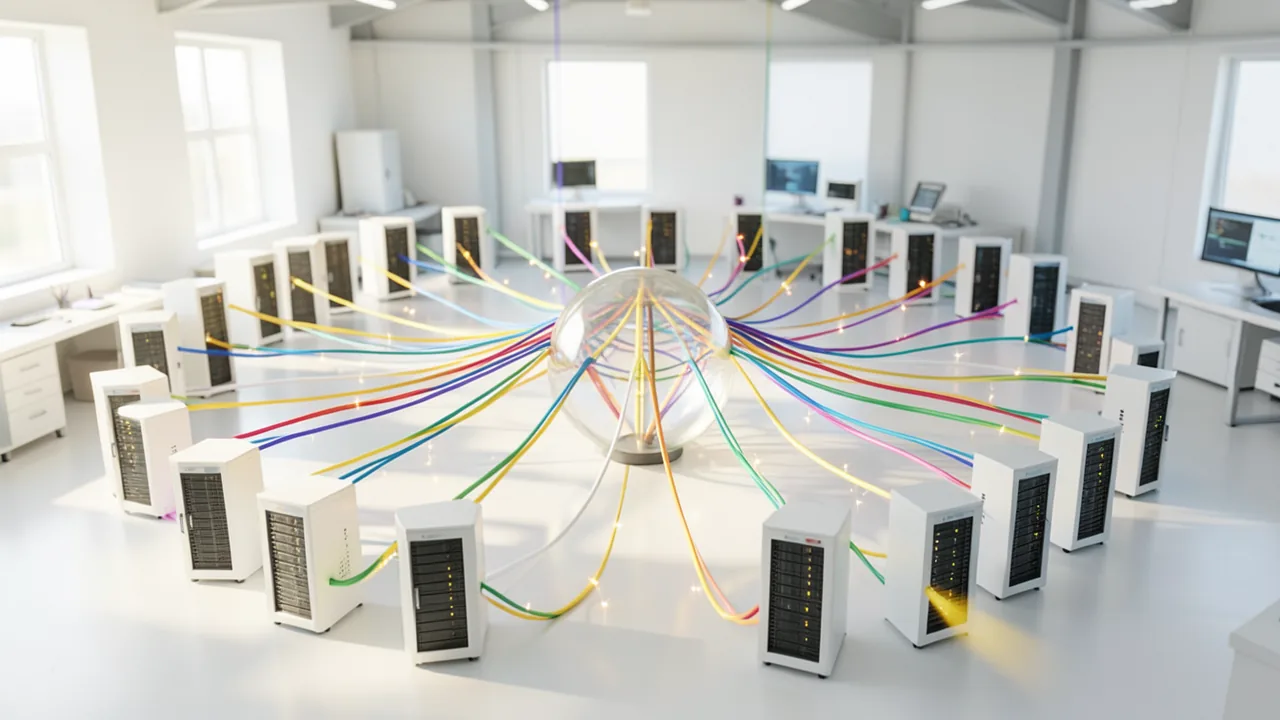
Hugging Face, die größte Plattform für frei herunterladbare KI-Modelle, arbeitet ab sofort mit OpenRouter zusammen. OpenRouter ist ein Vermittlungsdienst: Er nimmt Anfragen an KI-Modelle über eine einheitliche Schnittstelle entgegen und leitet sie an einen von vielen Rechenzentrumsbetreibern weiter, die das jeweilige Modell betreiben. Laut der Ankündigung im Hugging-Face-Blog vom 16. November 2026 tauscht Hugging Face bei seinem Dienst Inference Providers den eigenen Router gegen den von OpenRouter aus. Über diesen Dienst kann man Modelle vom Hub per API nutzen, ohne sie selbst zu betreiben.
Praktisch heißt das: Jedes Open-Weight-Modell auf dem Hub, also jedes Modell mit frei verfügbaren Gewichten, lässt sich mit dem normalen Hugging-Face-Token aufrufen, sobald irgendein Anbieter es betreibt. Den passenden Anbieter sucht OpenRouter für jede Anfrage einzeln aus. Laut Hugging Face musst du an deinem Code nichts ändern. Die Umstellung betrifft nur Sprachmodelle. Bild-, Video- und Audiogenerierung laufen wie bisher direkt über Hugging Face.
So funktioniert das neue Routing
OpenRouter betreibt nach eigenen Angaben mehr als 600 Modelle von über 80 Anbietern und verarbeitet für mehr als 10 Millionen Nutzer über 800 Billionen Tokens im Monat. Tokens sind die Wort- und Silbenstücke, in denen Sprachmodelle Text verarbeiten und abrechnen. Weil dabei so viel Verkehr durchläuft, misst OpenRouter laufend, wie schnell, wie günstig und wie zuverlässig jeder Anbieter gerade ist.
Vor Kurzem hat OpenRouter die Logik neu gebaut. Früher zählte vor allem der niedrigste Listenpreis. Jetzt geht jede Anfrage an den Anbieter mit der besten Kombination aus Preis, Tempo und Zuverlässigkeit. Wird ein Anbieter langsam oder liefert Fehler, leitet das System den Verkehr um, bis er sich erholt hat. Scheitert eine Anfrage, versucht der Router es noch im selben Aufruf beim nächstbesten Anbieter. Das ist der wichtigste Unterschied zu vorher: Bisher hat Inference Providers einen Anbieter ausgewählt und dessen Fehlermeldung einfach zurückgegeben, wenn etwas schiefging.
OpenRouter nennt für die neue Logik eigene Messwerte (Herstellerangaben):
| Kennzahl | Veränderung |
|---|---|
| Kapazitätsfehler | −46 % |
| Zeit bis zum ersten Token | 16,9 % schneller |
| Durchsatz | +16,3 % |
Wer selbst steuern will, hängt eine Endung an den Modellnamen. zai-org/GLM-5.3 nimmt die Standardmischung, :fastest den Anbieter mit dem höchsten Durchsatz, :cheapest den günstigsten und zum Beispiel :novita ausschließlich den Anbieter Novita. Außerdem achtet der Router auf den Cache: Ein Gespräch bleibt bei dem Anbieter, der schon den Prompt-Cache dafür hält. Das ist ein Zwischenspeicher für bereits verarbeitete Eingaben, der wiederholte Anfragen schneller und billiger macht. Wer das ausdrücklich festlegen will, schickt pro Gespräch eine feste Kennung (UUID) im Header X-HF-Session-Id mit.
Kompatibel mit gängigen Werkzeugen
Der Router versteht für jedes Chat-Modell, egal welcher Anbieter dahintersteht, drei verbreitete Schnittstellen: die Chat-Completions- und die Responses-API von OpenAI sowie die Messages-API von Anthropic. Deshalb lassen sich offene Modelle auch in Programmierassistenten einsetzen, die eigentlich für kommerzielle Modelle gebaut sind. Hugging Face bietet Einrichtungsanleitungen für Claude Code, Codex, OpenCode, Pi und Hermes Agent an. Die Einrichtung lässt sich auch komplett als Prompt kopieren, den man dem eigenen KI-Agenten zum Abarbeiten gibt.
Mit demselben Token kommt man auch an andere Hugging-Face-Dienste: Speicher über Storage Buckets, Rechenzeit über Jobs und eigene, fest reservierte Modellinstanzen über Inference Endpoints.
Preise und mehr Transparenz
Am Preismodell ändert sich nichts. Man zahlt den Preis des jeweiligen Anbieters, abgerechnet über die Hugging-Face-Rechnung, und Hugging Face schlägt nach eigenen Angaben nichts drauf. PRO-Nutzer bekommen jeden Monat 2 Dollar Guthaben, Team- und Enterprise-Organisationen 2 Dollar pro Platz.
Auf den Modellseiten gibt es zwei neue Reiter. Providers listet alle Anbieter auf, an die OpenRouter das Modell weiterleiten kann, jeweils mit Ein- und Ausgabepreis, Tempo und Verfügbarkeit der letzten 24 Stunden. Metrics zeigt die besten Werte unter ihnen für Preis, Durchsatz, Zeit bis zum ersten Token, Kontextlänge (wie viel Text das Modell auf einmal verarbeiten kann) und Verfügbarkeit. In der Nutzungsübersicht sieht man, welcher Anbieter wie viel gekostet hat. In den Einstellungen lassen sich einzelne Anbieter sperren, etwa aus Datenschutzgründen. Dorthin schickt der Router dann nie etwas. Für Organisationen gibt es dieselben Einstellungen, und sie gelten für alle Anfragen, die über die Organisation abgerechnet werden.
Das bricht bestehende Setups: eigene API-Schlüssel
Eine Einschränkung gibt es: Weil Anfragen an Sprachmodelle jetzt über OpenRouter laufen und über das Hugging-Face-Konto abgerechnet werden, kann man bei diesen Modellen keine eigenen API-Schlüssel einzelner Anbieter mehr hinterlegen. Wer etwa einen Vertrag direkt mit einem Anbieter hatte und ihn über Hugging Face genutzt hat, muss umstellen. Einen bestimmten Anbieter kann man weiterhin per Endung am Modellnamen erzwingen oder unerwünschte Anbieter abschalten. Eigene Schlüssel für Bild- und Videoanbieter funktionieren weiter.
Als nächste Schritte nennt Hugging Face, dass man das eigene OpenRouter-Konto mit Hugging Face verbinden kann und dass künftig noch mehr Aufgabentypen über OpenRouter laufen sollen.
Zahlen zum Boom offener Modelle
In der Ankündigung stehen auch Zahlen von OpenRouter (Stand Oktober 2026), die zeigen, warum die Partnerschaft für beide Seiten interessant ist. Der Anteil offener Modelle an allen über OpenRouter verarbeiteten Tokens stieg von 26,8 % im Oktober 2025 auf 71,7 % Ende September 2026. Der Höchststand lag im Juli bei 77,5 %. Im selben Zeitraum wuchs das wöchentliche Volumen offener Modelle um mehr als das 60-Fache, das der geschlossenen um knapp das Zehnfache. Das meistgenutzte Modell der Woche auf OpenRouter ist ein offenes: DeepSeek V4.1 Flash 1017 mit 59,2 Billionen Tokens.
Ein Grund ist der Preis. Offene Modelle kosten im Schnitt etwa ein Viertel:
| Input (pro Mio. Tokens) | Output (pro Mio. Tokens) | |
|---|---|---|
| Offene Modelle | 0,28 $ | 1,62 $ |
| Geschlossene Modelle | 1,27 $ | 6,36 $ |
Hugging Face räumt aber ein, dass die besten offenen Modelle bei den schwersten Tests noch hinter den besten proprietären liegen. Im Artificial Analysis Intelligence Index, einem Sammelwert aus mehreren anspruchsvollen Benchmarks, kommt das beste offene Modell, Kimi K3.1 Pro, auf 46 Punkte. Claude Fable 5.2 erreicht 65 Punkte. Dafür kostet eine Aufgabe mit Kimi nur etwa ein Siebtel (3,68 $ gegenüber 26,54 $). Hugging Face schreibt, dass sich dieser Kompromiss für viele Anwendungen lohne.
Einordnung
Die Partnerschaft bringt zwei Stärken zusammen. Hugging Face ist der Ort, an dem praktisch jedes offene Modell veröffentlicht wird. OpenRouter hat mit seinem riesigen Verkehrsaufkommen die Messdaten, um Anfragen klug zu verteilen. Für Entwickler wird es dadurch deutlich bequemer, offene Modelle produktiv zu nutzen: ein Token, gängige API-Formate, automatische Wiederholung bei Fehlern und keine Aufschläge. Gerade die Kompatibilität mit den Schnittstellen von OpenAI und Anthropic senkt die Hürde, in Programmierassistenten ein günstigeres offenes Modell einzusetzen.
Es gibt aber auch Kritikpunkte. Hugging Face gibt einen Teil seiner Infrastruktur aus der Hand und macht sich an einer zentralen Stelle von einem externen Partner abhängig. Wer bisher eigene Anbieterschlüssel genutzt hat, verliert diese Möglichkeit. Ob der Router wirklich den „besten“ Anbieter wählt, lässt sich für Nutzer nur über die neuen Transparenz-Reiter nachvollziehen. Die Verbesserungen um 46 % und rund 17 % stammen von OpenRouter selbst und sind nicht unabhängig geprüft. Gleiches gilt für die Nutzungsstatistiken, die vom Partner kommen und dessen Geschäftsmodell stützen. Wer Daten nur bestimmten Anbietern anvertrauen will, sollte die Anbieterliste in den Einstellungen gezielt einschränken.
Quellen
- Hugging Face Blog huggingface.co
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.