
Hugging Face PyBot: 1.000 KI-Agenten schreiben einen Chatbot ganz ohne neuronales Netz
Hugging Face hat PyBot veröffentlicht, einen Chatbot aus rund einer halben Million Zeilen reinem Python-Code ohne jedes neuronale Netz. Geschrieben hat ihn ein Schwarm von über 1.000 KI-Agenten. Das Experiment zeigt, wie weit fest programmierte Regeln kommen, wenn nicht Menschen, sondern Maschinen sie schreiben.
Worum es geht
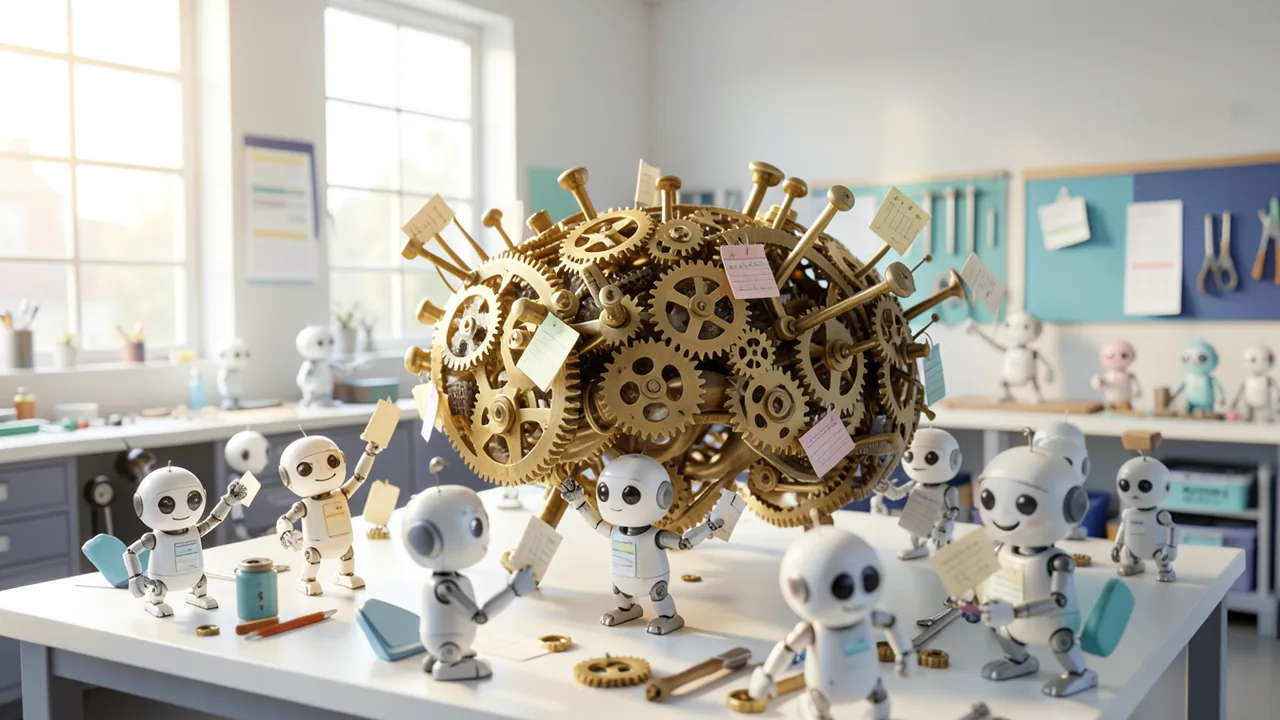
Hugging Face, die bekannte Plattform für KI-Modelle, hat am 12. November 2026 ein ungewöhnliches Projekt veröffentlicht: PyBot, einen Chatbot, der ganz ohne neuronales Netz auskommt. Hinter ihm steckt kein trainiertes Sprachmodell, sondern rund eine halbe Million Zeilen ganz normaler Python-Code – also fest programmierte Regeln. Neu ist, wer diese Regeln geschrieben hat: Laut der Projektbeschreibung (README) waren es mehr als 1.000 KI-Agenten, also Programme, die selbstständig Code schreiben, testen und einreichen. Sie haben über 5.000 Versionen erzeugt, bis der Bot im hauseigenen Benchmark SmolTalkBench eine Gewinnrate von etwa 26 Prozent erreichte.
Das Projekt steht unter der freien Apache-2.0-Lizenz auf GitHub: github.com/huggingface/pybot. Zusätzlich gibt es laut README einen Hugging Face Space, in dem man den Bot im Browser ausprobieren kann. Diese Zusammenfassung stützt sich auf einen Bericht von explainx.ai, der wiederum vor allem die Angaben aus dem README wiedergibt.
Die Idee: ELIZA mit Maschinenkraft
Hugging Face stellt eine bewusst gegen den Strich gebürstete Frage: Wenn KI-Agenten Regeln viel schneller schreiben können als Menschen, wie weit kommt dann ein rein symbolischer Chatbot – also einer, der nur nach festen Wenn-dann-Regeln arbeitet?
Das README erinnert dazu an ELIZA, einen Chatbot aus den 1960er-Jahren. ELIZA arbeitete mit simplen Textmustern und Antwortschablonen und täuschte damit manche Nutzer, ein echtes Gegenüber zu haben. Das Problem solcher Systeme war immer dasselbe: Jede Regel musste ein Mensch von Hand schreiben, und das lässt sich nicht beliebig ausweiten. PyBot ersetzt diesen menschlichen Autor durch einen Schwarm von Programmier-Agenten, die Module vorschlagen, testen und zusammenführen.
Laut explainx.ai ist das kein nostalgischer Gag, sondern ein Experiment: Wie viel Gesprächsabdeckung lässt sich mit roher Rechen- und Schreibkraft in explizite Regeln pressen, bevor man zu einem Transformer – der Architektur hinter ChatGPT und Co. – greifen muss?
So ist PyBot aufgebaut
Der Code ist in mehrere Bereiche aufgeteilt. Die Zeilenangaben stammen aus dem README:
| Ordner | Aufgabe | Zeilen (ca.) |
|---|---|---|
| bot/modules/ | Antwort-Module und Schiedsrichter | 67.000 |
| bot/understanding/ | Eingaben verstehen, Tippfehler, Bezüge | 22.000 |
| bot/memory/ | Gesprächsgedächtnis | 92.000 |
| bot/knowledge/ | Weltwissen als Daten | 275.000 |
| bot/compose/ | Formulierungen und Notfallantworten | 75.000 |
| tests/ | Von Agenten geschriebene Tests | ca. 550.000 |
Das Herzstück ist ein Arbiter, ein Schiedsrichter-Modul (bot/modules/arbiter.py). Bei jeder Nachricht dürfen alle Module eine Antwort vorschlagen und angeben, wie sicher sie sich sind. Der Arbiter wählt dann nach ebenfalls fest programmierten Regeln den Gewinner aus – das README vergleicht das mit einer Wahl unter Kandidaten. Größere Agenten-Systeme verteilen Anfragen ähnlich auf spezialisierte Teile, nur dass hier jeder Kandidat aus handfestem Python-Code besteht und nicht aus Wörtern, die ein Modell Stück für Stück erzeugt.
Das README zeigt das an einem Beispiel: Ein Nutzer erwähnt Kalk im Wasserkocher, PyBot erklärt die Entkalkung mit Essig. Auf die Nachfrage „Wie lange dauert das?“ springt ein Modul für Zeitangaben ein. Und auf „Wie heiße ich?“ holt der Bot den Namen aus dem Gedächtnis, weil der Nutzer vorher „Ich bin Sam“ geschrieben hat. Der Bot merkt sich also, was im Gespräch gesagt wurde, und das komplett ohne neuronales Netz und ohne RAG, also ohne dass ein Sprachmodell nachgeschlagene Dokumente verarbeitet.
Was die 26 Prozent bedeuten
SmolTalkBench ist ein Test von Hugging Face, bei dem ein „Richter-Modell“, also eine andere KI, die Antworten von PyBot mit Referenzantworten vergleicht. Über die 5.000 Versionen stieg die Gewinnrate laut README von 0 auf rund 26 Prozent. Damit liegt PyBot nach Projektangaben etwa auf dem Niveau von SmolLM-360M-Instruct, einem kleinen Sprachmodell mit 360 Millionen Parametern, das vor einigen Jahren für seine Größe als sehr stark galt.
Mit heutigen Spitzenmodellen wie GPT oder Claude kann das nicht mithalten, und das behauptet Hugging Face auch nicht. Die Stärken liegen woanders:
- Keine Grafikkarte nötig: Der Bot läuft auf jedem Rechner mit Python.
- Nachvollziehbarkeit: Jede Antwort lässt sich auf eine bestimmte Code-Datei zurückführen.
- Tests inklusive: Die Agenten haben parallel zu jeder Funktion Tests geschrieben, die Rückschritte aufdecken sollen.
explainx.ai empfiehlt Teams, PyBot als Vergleichsmaßstab zu nehmen: Wer für sein Fachgebiet eigene Regeln mit einer Wissenssuche baut und damit PyBot nicht schlägt, sollte die Arbeit der Agenten vielleicht lieber in bessere Daten stecken als in noch mehr Textmuster.
So probierst du es aus
Die Installation ist laut README denkbar einfach. Man braucht nur Python ab Version 3.8, für den Chat keine Zusatzpakete:
git clone https://github.com/huggingface/pybot
cd pybot
python -m pybot
Nützliche Befehle: /reset löscht die Sitzung, /exit beendet das Programm, -p "Frage" liefert eine einzelne Antwort, --seed N sorgt dafür, dass der Bot bei gleicher Eingabe immer gleich formuliert, und -v zeigt an, welches Modul gewonnen hat und wie lange es gedauert hat. Mit pip install . lässt sich PyBot auch als normaler Befehl pybot einrichten.
Der Start dauert ein paar Sekunden, weil Python Hunderttausende Codezeilen laden muss. Danach antwortet der Bot laut README in etwa einer Sekunde. Das ist auf einem normalen Prozessor ähnlich schnell wie kleine Sprachmodelle, kostet aber viel Speicherplatz und Arbeitsspeicher.
Für Unterricht und Workshops schlägt explainx.ai vor, mit dem -v-Modus live zu zeigen, wie die Antworten verteilt werden, eigene kleine Module zu ergänzen (etwa für die Öffnungszeiten der Mensa), dafür Tests zu schreiben und vorher wie nachher die Gewinnrate und die Startzeit zu messen.
Grenzen und Risiken
explainx.ai nennt mehrere Schwachstellen:
- Wartung: Eine halbe Million Zeilen kann kein Mensch sinnvoll pflegen. Das Projekt geht davon aus, dass künftig wieder Agenten die Änderungen übernehmen.
- Kein echtes Verallgemeinern: Das Wissen steckt in Nachschlagetabellen. Fragen außerhalb dieser Tabellen landen bei allgemeinen Notfallantworten.
- Sicherheit: Reiner Python-Code schützt nicht automatisch vor manipulierten Eingaben. Falls in den Commits des Schwarms gefährliche Konstrukte wie
eval, das Text als Code ausführt, durchgerutscht sind, könnten feindselige Eingaben sie erreichen. Vor einem öffentlichen Einsatz sollte man den Code prüfen. - Ressourcen: Ladezeit und Speicherbedarf übersteigen typische kleine Webdienste deutlich. PyBot ist eine Forschungsdemo, keine Vorlage für den Produktiveinsatz.
- Ecken und Kanten: Wenn zwei Module gleichauf liegen, entscheidet der Arbiter ohne
--seedmehr oder weniger zufällig. Das riesige Git-Repository kann automatische Testabläufe ausbremsen.
Auffällig ist außerdem: Wie Hugging Face die über 1.000 Agenten koordiniert hat, steht nicht im Repository. Das Steuerungssystem dahinter ist nicht veröffentlicht. explainx.ai liest aus dem Projekt nur heraus, dass die Versionsverwaltung die Agenten koordiniert hat und nach jeder Zusammenführung automatisch der Benchmark lief.
Einordnung
PyBot ist kein Produkt, das Sprachmodelle ersetzen soll. Hugging Face stellt es selbst neben ein Mini-Modell mit 360 Millionen Parametern, nicht neben Claude oder GPT. Interessant ist das Projekt als Vergleichsgröße und Lehrmaterial. Es zeigt, dass KI-Agenten heute eine Menge Code produzieren können, der tatsächlich funktioniert, und dass sich ein regelbasiertes System mit genug Fleiß messbar verbessern lässt. Jede Entscheidung bleibt dabei nachvollziehbar, was bei neuronalen Netzen kaum möglich ist.
Gleichzeitig ist das Projekt auch eine Mahnung: Agenten vervielfachen die Menge an Code, aber nicht automatisch das Urteilsvermögen. Eine halbe Million Zeilen, die kein Mensch mehr überblickt, sind kaum zu warten. Und dass gut 1.000 Agenten und 5.000 Versionen nötig waren, um ein winziges Sprachmodell von vor einigen Jahren einzuholen, passt gut zu Richard Suttons „Bitter Lesson“: Allgemeine, lernende Verfahren schlagen auf Dauer handgeschriebenes Wissen, auch wenn die Hand inzwischen eine Maschine ist. Offen ist außerdem, wie verlässlich SmolTalkBench mit einem KI-Richter misst. Die Zahlen stammen bisher allein von Hugging Face.
Quellen
- Merkliste: explainx.ai explainx.ai
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.