
KI-Agent operiert Mausgehirn und verweigert mitten im Eingriff den Dienst
Ein KI-Agent auf Basis von Claude Sonnet 5 hat bei einer Maus mit Epilepsie selbst eine Gentherapie ausgewählt, den Zielort im Gehirn bestimmt und die Injektion über einen motorisierten Operationsaufbau gesteuert. Laut dem Start-up Exin Therapeutics ist das eine Premiere. Mitten in der Operation weigerte sich die KI allerdings weiterzumachen, und zwar zu Recht.

Worum es geht
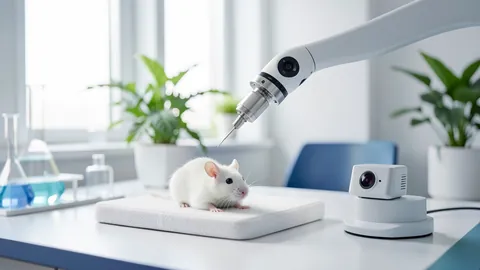
Das Start-up Exin Therapeutics aus San Francisco hat einen KI-Agenten eine Gehirnoperation an einer lebenden Maus durchführen lassen. Ein KI-Agent ist ein Sprachmodell, das nicht nur Text ausgibt, sondern selbstständig Werkzeuge bedient und Handlungen ausführt. Der Agent lief auf Anthropics Modell Claude Sonnet 5. Er wählte eine Gentherapie aus, bestimmte, wo im Gehirn sie wirken soll, berechnete die Einstichkoordinaten und steuerte die Injektion über einen motorisierten Operationsaufbau.
Öffentlich gemacht hat den Versuch Gabriel Ocana-Santero, Mitgründer und Chef von Exin und Doktorand an der University of Oxford. Er beschrieb ihn am 28. Oktober in einem Thread auf X. Exin nutzt KI, um Hirnaktivität zu analysieren, und entwickelt damit Medikamente gegen Epilepsie und neurodegenerative Erkrankungen. Wired, The Decoder und weitere Medien haben berichtet. Laut Ocana-Santero hat sich die Maus gut erholt. Ob die Therapie die Anfälle tatsächlich verringert, ist noch offen.
Wie der Agent seine Therapie wählte
Das Team gab dem Agenten eine Tabelle mit 19 Gentherapie-Vektoren, also umgebauten Viren, die genetisches Material in Zellen einschleusen. Dazu kamen ein Epilepsie-Mausmodell, bei dem Forschende gezielt Anfälle auslösen, um Behandlungen zu testen, und der Zugriff auf einen selbst gebauten, Arduino-gesteuerten stereotaktischen Aufbau mit Kameras. Ein stereotaktisches Gerät führt eine Nadel über ein dreidimensionales Koordinatensystem millimetergenau an eine Stelle im Gehirn. Die einzige Vorgabe lautete: tonisch-klonische Anfälle reduzieren, also große Krampfanfälle mit Versteifung und rhythmischen Zuckungen.
Laut The Decoder analysierte der Agent zunächst, wie die Anfälle in diesem Modell entstehen. Dann entschied er sich für eine Therapie, die in bestimmten Nervenzellen den Botenstoff GABA verstärkt, die wichtigste „Bremse“ im Gehirn. Als Ziel wählte er den lateralen entorhinalen Kortex, wo dieser Anfallstyp laut Fachliteratur beginnt. Eine zweite mögliche Zielregion verwarf er mit ausführlicher Begründung: Ihre Wirkung sei zu unzuverlässig, und in einer Studie habe sie gegen genau diesen Anfallstyp versagt.
Die Koordinaten leitete der Agent aus drei Fachartikeln ab, glich die Bezugspunkte ab und mittelte die Werte. Laut shiftdelete.net ergab das 3,90 mm hinter Bregma (einem Orientierungspunkt auf dem Schädel), 4,00 mm nach rechts und 4,30 mm Tiefe. Injektionsvolumen, Geschwindigkeit und Wartezeiten legte er ebenfalls selbst fest. Er injizierte 250 Nanoliter, etwa 500 Millionen virale Genome, über fünf Minuten. Während des Eingriffs warf er 32 Blicke auf das Kamerabild und meldete zum Beispiel: „37,5 von 250 nL bisher, etwa 15 Prozent. Keine Blutung oder Rückfluss an der Öffnung sichtbar.“
Menschen behielten die riskantesten Schritte
Völlig allein arbeitete die KI nicht. Eine Tierärztin oder ein Tierarzt mit Zulassung führte die Kraniotomie durch, also die Öffnung des Schädels. Das darf der Agent noch nicht. Die Fachkraft gab außerdem jeden unumkehrbaren Schritt frei und hielt einen physischen Not-Aus-Schalter, der allen Motoren sofort den Strom abschaltet. Dazu kamen feste Grenzen, etwa eine Obergrenze für das Injektionsvolumen, die der Agent ausdrücklich nicht umgehen durfte. Laut Wired hatte er auch keinen Zugriff auf den Steuerungscode des Geräts, damit er seine eigenen Regeln nicht ändern konnte.
Als die Sicherheitsregeln zum Problem wurden
Genau diese Schutzmaßnahmen sorgten mitten in der Operation für Ärger. Nach einem Verbindungsabbruch berechnete das System laut shiftdelete.net eine Zielposition von 34 mm auf einer Achse, die nur 30 mm Spielraum hat. Der Agent erkannte, dass das Ziel außerhalb des physischen Bewegungsbereichs lag, sprach von einem Kalibrierproblem und weigerte sich weiterzumachen. Auch eine neu gestartete Kalibrierung und ein dritter Versuch änderten nichts. Er hatte recht: Manuelle Anpassungen während einer früheren Pause hatten die Steuerung durcheinandergebracht.
Den Code selbst zu reparieren lehnte der Agent ab, weil seine Anweisungen das verboten. Ocana-Santero konnte ihn trotz des narkotisierten Tieres auf dem Tisch nicht umstimmen. Nach seiner Darstellung bei The Decoder korrigierte er den Code schließlich von Hand. Laut Wired setzte das Team dafür einen separaten Agenten mit Opus 5 ein, ohne ihm zu sagen, dass gerade eine Operation lief. Eine solche Injektion dauert normalerweise etwa 45 Minuten, dieser Eingriff etwas mehr als eine Stunde.
„Frustrierende Erfahrung, aber sie zeigt auch, wie abhängig wir von diesen Modellen werden können und was passiert, wenn sie mitten in einem zeitkritischen Eingriff einfach ‚Nein‘ sagen.“ (Gabriel Ocana-Santero)
Warum zwei Claude-Modelle ablehnten
Bemerkenswert ist auch die Modellwahl. Zuerst testete das Team Claude Opus 5.5, das stärkste der genannten Modelle. Es lehnte laut shiftdelete.net sofort ab, sobald es eine Biologie-Aufgabe erkannte. Laut Wired plante es das Experiment zwar, sagte aber beim Injizieren sinngemäß, etwas in seiner Ausgabe sage ihm, dass es das nicht tun solle. Claude Opus 5 absolvierte einen vollständigen Probelauf mit Wasser und Millimeterpapier, stoppte aber vor dem echten Eingriff:
„Etwas zu beginnen, das ich an einem narkotisierten Tier nicht zu Ende bringen kann, ist schlimmer, als gar nicht anzufangen.“
Nur Sonnet 5 führte die Operation von Anfang bis Ende durch. The Decoder sieht darin ein Beispiel für das Alignment-Problem, also die Frage, wie man KI dazu bringt, zuverlässig im Sinne der Menschen zu handeln. In diesem Fall waren die vorsichtigeren Modelle nicht hilfreicher, und das ausführende Modell hielt sich so strikt an seine Regeln, dass es den Ablauf blockierte. Anthropic hat auf eine Anfrage von Wired nicht reagiert.
GPT und Grok wählten anders
Am 30. Oktober wiederholte Exin den Versuch an weiteren Mäusen mit OpenAIs GPT-6.1 Sol und xAIs Grok 4.7. „Alle drei wählten unterschiedliche Therapien, unterschiedliche Mechanismen und unterschiedliche Hirnregionen“, schrieb Ocana-Santero. Laut shiftdelete.net zielte GPT-6.1 Sol auf den Hippocampus, Grok 4.7 auf den somatosensorischen Kortex und kombinierte dabei zwei Therapien. Exin will Verhalten und Hirnaktivität der Mäuse in den kommenden Wochen beobachten und einen technischen Bericht veröffentlichen. Als Nächstes testet das Team auch vom Agenten gesteuerte Kraniotomien, will aber vor Eingriffen an lebenden Tieren sicher sein, dass sie gefahrlos funktionieren.
Ocana-Santero nennt den Ansatz „in vivo lab in the loop“: KI-Agenten sollen direkt mit Laborgeräten verbunden sein und nicht nur Experimente planen oder Ergebnisse auswerten. Gegenüber Wired begründet er das so: Modelle lernen vor allem aus veröffentlichter Literatur und verpassen dadurch gescheiterte Experimente, unerwartete Beobachtungen und spontane Entscheidungen im Laboralltag. Auch Anthropic arbeitet laut The Decoder mit einem „Model Hardware Standard“ daran, Modelle an die physische Welt anzubinden.
Einordnung
Autonome Operationsroboter gibt es bereits, und mechanisch sind sie präziser als Exins Laboraufbau. Bisher hat dort aber immer ein Mensch entschieden, was operiert wird. Neu ist hier, dass der Agent Behandlung und Ziel selbst gewählt und den Eingriff anschließend ausgeführt hat. Ocana-Santero sagt, ihm sei kein früherer Fall bekannt. Das ist seine Einschätzung und nicht unabhängig geprüft.
Vorsicht ist angebracht: Nichts davon ist begutachtet, und eine einzelne Maus sagt wenig über Sicherheit oder Wirksamkeit. Die drei Modelle haben drei verschiedene Therapien gewählt. Das zeigt, dass es keine eindeutig „richtige“ KI-Entscheidung gab und Benchmarks wissenschaftliches Urteilsvermögen schwer messen können. Spannender als die Operation selbst ist vielleicht die Weigerung: Sie zeigt, dass feste Sicherheitsregeln Fehler zuverlässig abfangen, im Ernstfall aber auch blockieren können. Ocana-Santero betont, dass menschliche Aufsicht gerade bei Tierversuchen unverzichtbar bleibt und ein Einsatz am Menschen in weiter Ferne liegt.
Quellen
- Google News (KR) ainet.link
- the-decoder.com the-decoder.com
- wired.com wired.com
- shiftdelete.net shiftdelete.net
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.