
MOSS-Image-SFT: Apache-2.0-Text-zu-Bild-Modell mit Layout-Steuerung
OpenMOSS veröffentlicht MOSS-Image-SFT, ein feinabgestimmtes 5,1B-Text-zu-Bild-Modell. Es nimmt Prompts, Tag-Folgen und JSON-Layouts entgegen.
Worum es geht
OpenMOSS hat MOSS-Image-SFT veröffentlicht. Es ist die Supervised-Fine-Tuning-Variante des Text-zu-Bild-Modells MOSS-Image-Base. Architektur und Inferenz-Pipeline sind identisch. Das Modell versteht natürlichsprachige Prompts, Tag-Sequenzen und JSON-Layouts, mit denen sich Textplatzierung und Objektanordnung steuern lassen.
Die wichtigsten Fakten
- 5,1 Mrd. Parameter, Lizenz Apache 2.0.
- Nutzung über diffusers (≥0.38) mit
trust_remote_codeund der Custom Pipelinepipeline_moss_image. - Voraussetzungen: Python ab 3.10, NVIDIA-GPU mit CUDA, PyTorch ab 2.9.
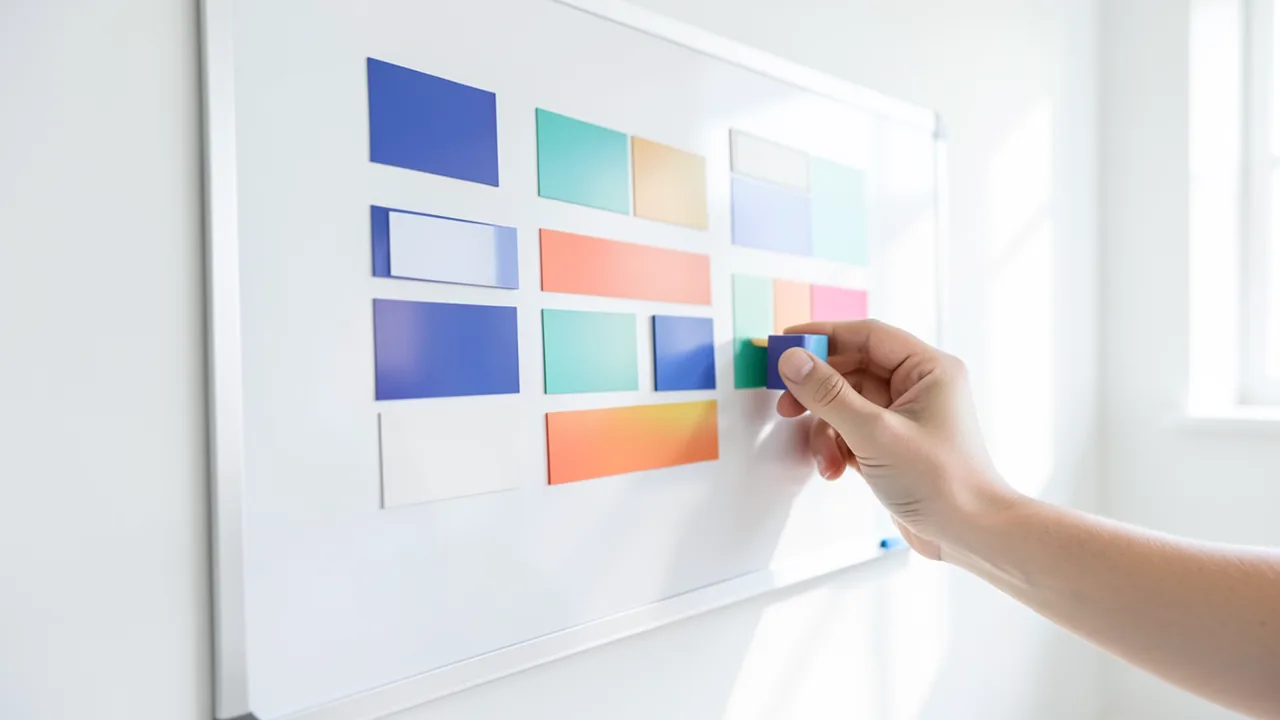
- Laut Model Card erzeugt SFT klarere Textgruppierung und ein geordneteres Layout als Base, gezeigt an einem Whiteboard-Beispiel.
- Unterstützte Sprachen: Englisch und Chinesisch.
- Es gibt ein ComfyUI-Setup, eine Spaces-Demo, einen Technical Report und ein arXiv-Paper (2610.23374).
- Rund 6.900 Downloads und 570 Likes.
Einordnung
Mit 5,1B Parametern und Apache-2.0-Lizenz ist das Modell für lokale Experimente attraktiv. Die JSON-Layout-Steuerung ist für Poster und Text im Bild interessant. Konkrete Benchmarks stehen in der Model Card nicht, und der VRAM-Bedarf wird nicht genannt. Die Qualität im Vergleich zu etablierten Bildmodellen ist daher noch offen.
🧪 Selbst ausprobieren: MOSS-Image-SFT
| Hugging Face | OpenMOSS-Team/MOSS-Image-SFT |
|---|---|
| Größe | 5.1 Mrd. Parameter |
| VRAM (4-bit, geschätzt) | ~4.6 GB |
| Lizenz | apache-2.0 |
| Typ | image-gen · text-to-image |
☁️ Google Colab
Notebook herunterladen- colab.research.google.com öffnen
- Datei → Notebook hochladen →
colab.ipynb - Laufzeit → Laufzeittyp ändern → GPU (T4)
- Laufzeit → Alle ausführen
Die Skripte sind automatisch erzeugt. Vor dem Ausführen kurz reinschauen – und die Model Card lesen, manche Modelle brauchen spezielle Versionen.