
Nvidia GR00T 2: Roboter lernen Feinmotorik aus Videos von Menschen
Nvidia hat auf der Robotik-Konferenz CoRL in Austin GR00T 2 vorgestellt, ein KI-Modell, das Robotern Handgriffe beibringt, unter anderem anhand von Videos, in denen Menschen Alltagsarbeiten erledigen. Dazu gibt Nvidia 100.000 Stunden solcher Aufnahmen frei. Die Testergebnisse sind beeindruckend, Nvidias eigenes Paper schränkt die besten Zahlen aber selbst ein.
Worum es geht
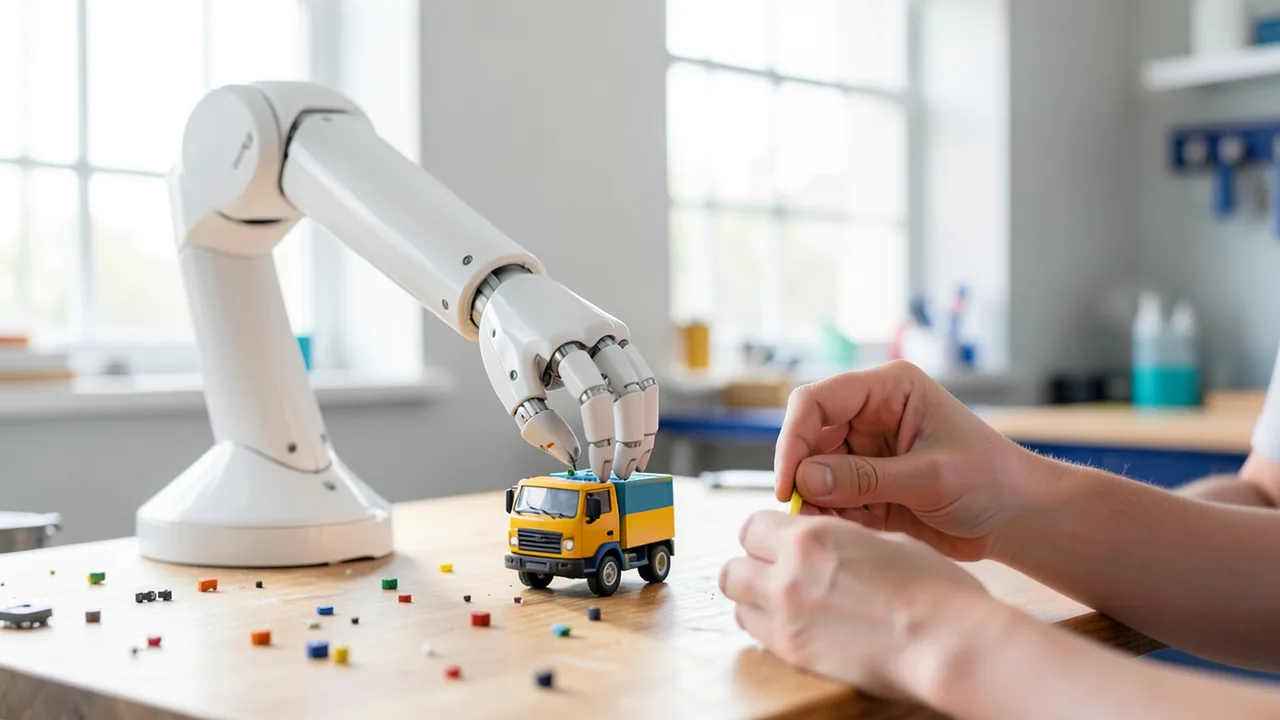
Nvidia hat am 9. November 2026 auf der Conference on Robot Learning (CoRL) in Austin, Texas, GR00T 2 vorgestellt. Das ist die nächste Generation seiner Basismodelle für Roboter. Ein Basismodell (englisch Foundation Model) wird einmal mit sehr vielen Daten trainiert und dann an viele einzelne Aufgaben angepasst, ähnlich wie die Sprachmodelle hinter Chatbots. GR00T 2 soll Robotern vor allem feine Handarbeit beibringen, also Teile greifen, einsetzen und zusammenstecken. Gelernt hat es das zu einem großen Teil, indem es Videos von Menschen bei Alltagsarbeiten ausgewertet hat.
Nvidia nennt GR00T 2 ein offenes „World Action Model“. Gemeint ist ein Modell, das vor jeder Bewegung vorhersagt, wie sich seine eigene Aktion auf das auswirkt, was es danach sieht. Es stellt sich die Folgen sozusagen vorher bildlich vor. Ganz offen ist es allerdings noch nicht: Laut der Forschungsseite von Nvidia, die Unite.AI zitiert, soll der Code erst im Dezember erscheinen. Schon jetzt freigegeben ist ein großer Teil der Trainingsdaten.
Neben dem Modell zeigte Nvidia das Simulationswerkzeug Isaac Lab 3.0 und mehrere neue Benchmarks, also standardisierte Testreihen, mit denen sich Roboter vergleichen lassen.
So funktioniert GR00T 2
Laut Unite.AI ist GR00T 2 ein Transformer-Modell mit 2 Milliarden Parametern, das auf Nvidias Videomodell Cosmos-Predict2.5-2B aufbaut. Es bekommt drei Dinge als Eingabe: die letzten Kamerabilder, den aktuellen Zustand des Roboters (etwa die Gelenkstellungen) und eine schriftliche Anweisung. Daraus erzeugt es die Bilder, die es als Nächstes erwartet, und die nächste Folge von Bewegungen. Ein einziger vortrainierter Checkpoint, also ein gespeicherter Trainingsstand, soll für Arme mit einfachem Zweifingergreifer, für Roboter mit beweglichen Händen und für einen Humanoiden funktionieren.
Die Vorgänger GR00T N1.6 und N1.7 waren laut Cryptobriefing VLA-Modelle (Vision-Language-Action) mit 3 Milliarden Parametern. Ein VLA-Modell sieht ein Bild, versteht eine Anweisung in normaler Sprache und gibt Bewegungen aus.
Der eigentliche Kniff steckt in den Trainingsdaten:
| Datenquelle | Umfang |
|---|---|
| Videos von Menschen aus der Ich-Perspektive | 402.730 Stunden |
| Demonstrationen mit einem Handgreifer (2.897 Aufgaben) | 10.184 Stunden |
| Teleoperation (Roboter von Menschen ferngesteuert) | 23.500 Stunden |
Roboter haben ein Datenproblem: Sprachmodelle können aus dem Internet lernen, aber jahrelanges Übungsmaterial fürs Wäschefalten lässt sich nicht einfach herunterladen. Videos von Menschen gibt es viel leichter, sie sind aber keine fertigen Roboterbefehle. Das Modell muss lernen, das Gesehene auf seinen eigenen Körper zu übertragen. Wie gefragt solche Daten sind, zeigt laut The Next Web das Start-up Maxinsights, das Menschen dafür bezahlt, ihre Hausarbeit zu filmen.
100.000 Stunden der Menschen-Daten veröffentlicht Nvidia als Human-1M-100K: Videos, sprachliche Beschreibungen sowie Daten zu Kopf- und Handbewegungen. Die Lizenz CC BY 4.0 erlaubt die Nutzung auch für kommerzielle Zwecke, solange die Quelle genannt wird.
Was die Tests zeigen und wo man genau hinsehen muss
Nvidia hat untersucht, wie gut sich Fähigkeiten von einem Körper auf einen anderen übertragen lassen (Cross-Embodiment). Ein Filterpapier einzusetzen lernte das Modell nur aus Demonstrationen von Menschen, ohne eigens ferngesteuerte Roboterdaten für diese Aufgabe. Es klappte in 65 Prozent der Versuche. Einen Spielzeug-Kipplaster zusammenzubauen, übertragen vom Handgreifer auf einen YAM-Roboterarm, gelang in 60 Prozent der Fälle.
Beim Zero-Shot-Test, also bei Aufgaben ohne jedes vorherige Training dafür, unterscheiden sich die Darstellungen. The Next Web schreibt, GR00T 2 habe 40 von 50 Aufgaben mindestens einmal ohne Training geschafft. Unite.AI und Diario Bitcoin sprechen dagegen von 40 Prozent Zero-Shot-Erfolg bei 50 Aufgaben, die nicht in den Trainingsdaten des Zielroboters vorkamen. Unite.AI erwähnt zusätzlich, dass das Modell in der Testreihe „Dexter“ bei 40 Aufgaben mindestens einen Versuch erfolgreich abschloss.
Zeigt man dem Roboter eine Aufgabe einmal vor, liegt der Erfolg im Schnitt bei 71 Prozent, bei fünf Vorführungen bei 95 Prozent. Fünf Vorführungen entsprechen weniger als drei Minuten Roboterdaten pro Aufgabe. Danach folgt eine etwa 30-minütige Feinabstimmung eines sogenannten Adapters auf einer einzelnen RTX 5090. Ein Adapter ist ein kleines Zusatzmodul, das nachtrainiert wird, während das große Modell unverändert bleibt.
Die Einschränkung steht in Nvidias eigenem Whitepaper: Getestet wurden nur Aufgaben, die das Modell mit fünf Vorführungen zu mindestens 80 Prozent lernen kann. Der hohe Durchschnitt ergibt sich also teilweise schon aus der Auswahl. Darauf weisen The Next Web und Unite.AI ausdrücklich hin.
Ein KI-Agent als Aufpasser
Bei längeren Aufgaben arbeitet GR00T 2 mit einem Reasoning-Agenten zusammen. Das ist ein übergeordnetes KI-System, das die einzelnen Schritte plant, den Fortschritt überwacht und Korrekturroutinen startet, wenn etwa ein Teil herunterfällt. GR00T 2 selbst übernimmt die eigentliche Handarbeit. Mit Korrekturdaten und Agent gelangen laut Nvidia in jeweils 100 Versuchen 98 Spielzeugflugzeuge, 97 Spielzeugtraktoren und 97 Hot-Wheels-Modelle. Die Teile lagen dabei zu Beginn jeweils zufällig verstreut. Mit reinem Supervised Fine-Tuning, also klassischem Nachtrainieren mit Beispielen, waren es nur 69, 51 und 23.
Der Preis dafür ist Wartezeit. Beim Sortieren von Müll wartete der Roboter im Median 38 Prozent einer Aufgabe auf den Agenten. Bei den langen Aufgaben gibt das Whitepaper insgesamt rund 70 Prozent durchschnittlichen Erfolg an.
Isaac Lab 3.0 und neue Benchmarks
Isaac Lab 3.0 ist Nvidias quelloffenes Werkzeug, mit dem Roboter in einer Simulation trainiert werden, bevor sie in die echte Welt kommen. Laut Unite.AI ist es seit dem 20. Oktober 2026 allgemein verfügbar. Unterschiedliche Physik-Engines wie Newton oder PhysX lassen sich einstecken; Newton kann starre und verformbare Körper sowie Partikel simulieren. Viele Abläufe funktionieren ohne eine vollständige Isaac-Sim-Installation. In einem Benchmark für bildbasierte Handmanipulation trainiert Isaac Lab 3.0 mit Newton nach Nvidias Angaben bis zu 2,5-mal schneller als Version 2.3 mit PhysX. Laut Cryptobriefing gehört auch LEAPP dazu, ein Werkzeug, das trainierte Steuerungen leichter auf echte Hardware bringen soll.
Weitere Projekte:
- AlphaNIST trainiert in der Simulation 20 Montageaufgaben des NIST Assembly Task Board mit Teilen ab 4 Millimetern Größe. Eine gemeinsame Steuerung, die nur die Rückmeldung „geschafft/nicht geschafft“ bekommt, erreicht 98,2 Prozent Trainingserfolg. Einzelne Steuerungen pro Aufgabe kommen auf 81,4 Prozent und brauchen etwa 39-mal mehr GPU-Zeit. Das sind allerdings Simulationswerte.
- Dahinter steckt Success-Guided Sampling von der University of Washington und Nvidia. Das Verfahren lässt bevorzugt die Situationen üben, die der Roboter etwa jedes zweite Mal schafft. Laut den Autoren skaliert es auf mehr als eine Million simulierte Umgebungen und überträgt sich ohne Nachtraining auf echte UR5e-Roboterarme.
- Isaac Lab-Arena baut wiederholbare Tests aus Bausteinen und zeigt, unter welchen Bedingungen ein Roboter scheitert. Version 0.4 erscheint als Developer Preview zur CoRL.
- DexBench v1.0 von RLWRLD und Nvidia umfasst 15 Aufgaben aus Einzelhandel, Logistik, Montage und Hotelgastronomie. VABAR von UC Berkeley und Nvidia testet unter anderem Zahnräder ineinandergreifen lassen und Kabel verlegen. Ein schwierigeres Testset steht hier noch aus.
- Graph-as-Policy von UC Berkeley setzt Roboterfähigkeiten mit mehreren Agenten zu einem nachvollziehbaren Ablaufgraphen zusammen. Nach zehn Proberunden stieg der Erfolg bei der Aufgabe „Popcorn machen“ von 33 auf 94 Prozent in der Simulation und auf 90 Prozent (18 von 20) am echten Roboter.
Partner und Reaktionen
Foxconn, das inzwischen den Großteil seines Umsatzes mit KI-Servern macht, nutzt GR00T 2 bei deren Fertigung. Siemens prüft industrielle Einsätze, Nexuni testet das Modell fürs Wäschehandling. Laut allen Quellen handelt es sich um Tests, eine Einführung in der Produktion hat niemand angekündigt. Frühere GR00T-Modelle stecken bereits in Robotern, die gerade entwickelt werden, darunter ein Humanoid von LG, der 2027 kommen soll. Ken Goldberg, Robotikprofessor an der UC Berkeley, der an zwei der Projekte mit Nvidia gearbeitet hat, sagte laut The Next Web:
„Für mich ist agentische Robotik die aufregendste technologische Entwicklung seit dem Internet 1995.“
Einordnung
GR00T 2 setzt darauf, Roboter mit der riesigen, billig verfügbaren Menge an Videos von Menschen zu trainieren statt nur mit teuren Roboterdaten. Für die ganze Branche könnte der frei nutzbare Datensatz Human-1M-100K sogar wichtiger sein als das Modell selbst, denn ihn können auch Konkurrenten und Forschende verwenden. Das Modell lässt sich dagegen noch nicht ausprobieren, weil der Code erst im Dezember kommen soll.
Die Zahlen stammen durchweg von Nvidia und sind deutlich weniger glänzend, als sie auf den ersten Blick wirken. Die 95 Prozent beruhen auf vorausgewählten Aufgaben, viele Rekordwerte gelten nur in der Simulation, und für hohe Zuverlässigkeit braucht es Nachtraining pro Aufgabe und einen Agenten, der Zeit kostet. Für Unternehmen zählt deshalb nicht die Erfolgsquote des Modells allein, sondern der ganze Ablauf: wie viel Anpassung und Aufsicht jede einzelne Aufgabe braucht. Diesen Aufwand zu senken, ohne die Zuverlässigkeit zu verlieren, ist die offene Aufgabe, die Nvidias eigene Ergebnisse aufzeigen.
Quellen
- Merkliste: thenextweb.com thenextweb.com
- Unite.AI unite.ai
- Bing News (es-MX) diariobitcoin.com
- cryptobriefing.com cryptobriefing.com
- finance.yahoo.com finance.yahoo.com
- gcn.com gcn.com
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.