
Portal2Bench: Nur GPT-6 Astra knackt eine Portal-2-Kammer, an der alle anderen scheitern
Ein Hobby-Entwickler hat einen Test gebaut, in dem KI-Modelle Portal 2 nur über Bildschirmfotos und Tastendrücke spielen. OpenAIs GPT-6-Modelle lösen dort 20 von 26 Testkammern, Anthropics Opus 5.5 nur 11. Kurz zuvor hatte GPT-6 Astra in einem anderen Experiment schon das erste Portal komplett durchgespielt, für 571 Dollar an API-Kosten.
Worum es geht
Ein Hobby-Entwickler, auf Reddit als u/Deep-Garbage6832 unterwegs und mit der Projektseite kingstonyip.com/portal2bench, hat einen Test für KI-Agenten gebaut, der Portal2Bench heißt. Darin sollen aktuelle Sprachmodelle die Testkammern aus Valves Rätselspiel Portal 2 lösen, und zwar ohne Hilfe. Die Modelle sehen nur Bildschirmfotos und drücken virtuell Tasten. Ein Agent ist hier ein KI-Modell, das selbstständig mehrere Schritte nacheinander plant und ausführt.
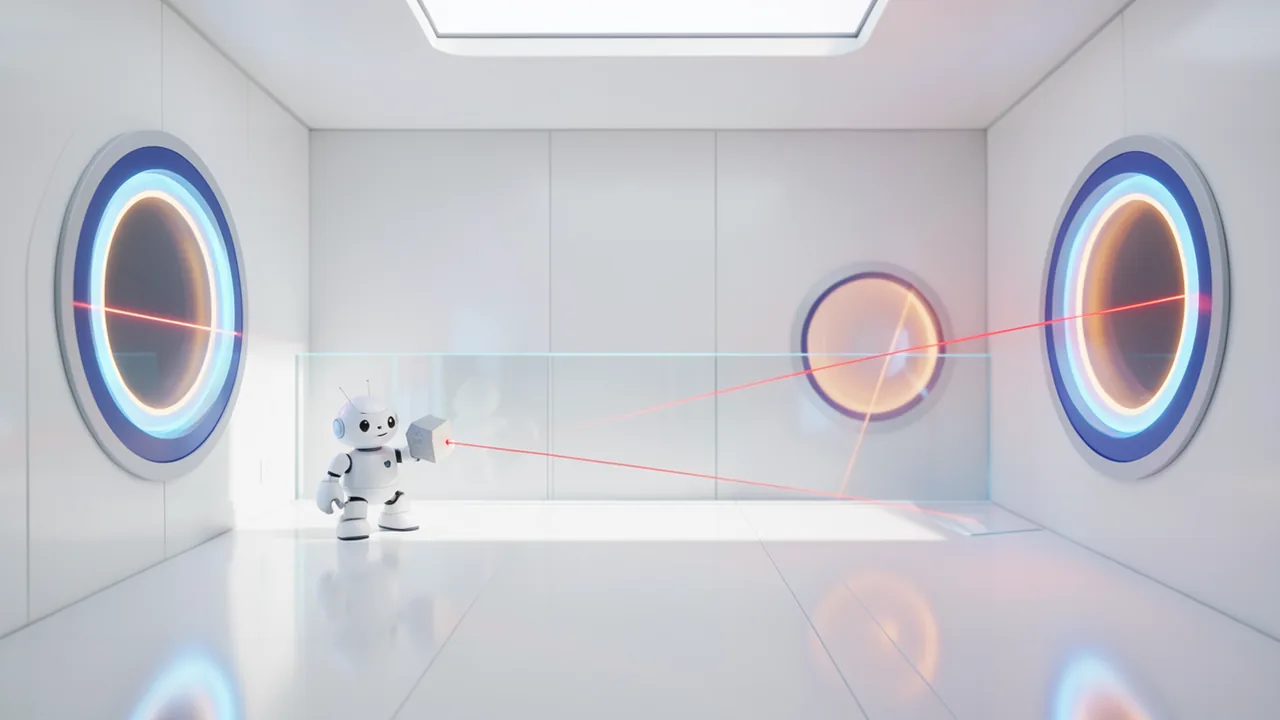
Das Ergebnis, das der Entwickler auf Reddit hervorhebt: Die Kammer in Kapitel 4, Level 1 hat von sieben getesteten Modellen nur OpenAIs GPT-6 Astra geschafft. Laut seiner Beschreibung richtete das Modell mit Würfeln Laserstrahlen aus, bis alle Relais leuchteten. Danach versetzte es ein Portal so, dass eine Lichtbrücke flach lag, sprang geduckt darauf und lief hinaus. Er selbst habe das Level beim ersten Spielen anders gelöst, schreibt er: nach vielen Versuchen, indem er einen Würfel auf ein Geschütz warf.
Der Test läuft noch. Viele Kammern sind laut Projektseite wegen begrenzter Rechenleistung und Nutzungslimits noch nicht für alle Modelle durchgespielt. Portal2Bench hat nichts mit Valve zu tun und wird von Valve auch nicht unterstützt.
So funktioniert der Test
Damit das Modell nachdenken kann, ohne dass die Spielfigur weiterläuft, wird Portal 2 über das SAR-Plugin angehalten, eine Erweiterung aus der Speedrunner-Szene. Erst wenn die KI einen Befehl schickt (Tool-Aufruf), läuft das Spiel kurz weiter. Der Agent kann:
- zielen: die Ansicht drehen und in eine Richtung schauen,
- sich bewegen: W, A, S, D, ducken, springen,
- benutzen: die Taste E und die Portalkanone.
Zurück bekommt er Bildschirmfotos und seine Position im Level. Er hat einen eigenen Ordner für Notizen, aber keine Kommandozeile, kein Internet und keinen Zugriff auf die Spielkonsole. Komplettlösungen, Kartennamen oder Cheats gibt es in der Umgebung laut Entwickler nicht. Seine Dateiwerkzeuge reichen nur bis zum Notizordner. Eine Qualitätsprüfung meldet jeden anderen Zugriff. Stirbt die Spielfigur, startet sie wie im normalen Spiel am letzten Checkpoint, und der Agent erfährt nur, dass er gestorben ist.
Jede Kammer ist ein neuer, unabhängiger Durchlauf. Gelöst ist sie, wenn der Agent die nächste Karte erreicht, und zwar innerhalb von 300 Plänen (Planungsschritten) und 30 Dollar API-Kosten. Abgerechnet wird zu den offiziellen Listenpreisen der Anbieter. Gewertet werden 26 Kammern aus den Kapiteln 2 bis 5. Jedes Modell läuft in der Agenten-Umgebung seines Herstellers ("Harness"), also OpenAIs Codex, Anthropics Claude Code oder Googles Antigravity, jeweils auf der höchsten Denkstufe ("max effort"). Gemini 4 Argon läuft nur auf "high".
Die Ergebnisse
| Modell | Agenten-Umgebung | Gelöste Kammern | Mittlere Kosten pro gelöster Kammer | Mittlere Zahl der Pläne | Mittlere Spielzeit |
|---|---|---|---|---|---|
| GPT-6.1 Sol | Codex | 20 / 26 | 1,0 $ | 92 | 4:50 |
| GPT-6 Astra | Codex | 20 / 26 | 4,5 $ | 71 | 3:09 |
| GPT-6.1 Terra | Codex | 19 / 26 | 0,74 $ | 111 | 3:06 |
| Opus 5.5 | Claude Code | 11 / 26 | 10,6 $ | 127 | 4:06 |
| Sonnet 5.5 | Claude Code | 6 / 26 | 8,9 $ | 155 | 3:59 |
| Fable 5.1 | Claude Code | 3 / 15 | 13,12 $ | 50 | 2:52 |
| GPT-6 Luna | Codex | 0 / 26 | – | – | – |
| Gemini 4 Argon | Antigravity | noch keine Daten | – | – | – |
| Fable 5.2 | Claude Code | noch keine Daten | – | – | – |
Die Spielzeit ist ohne die Denkpausen gemessen.
OpenAIs Modelle liegen klar vorn. Sol, Astra und Terra lösen jeweils etwa drei Viertel der Kammern, Anthropics stärkstes getestetes Modell Opus 5.5 schafft nicht einmal die Hälfte. GPT-6.1 Terra ist mit im Mittel 74 Cent pro gelöster Kammer außerdem das mit Abstand günstigste Modell. Astra kommt mit den wenigsten Plänen aus, wenn man Fable 5.1 außen vor lässt. Fable 5.1 wurde bisher nur in 15 Kammern getestet. Bemerkenswert ist auch GPT-6 Luna, das trotz OpenAI-Herkunft keine einzige Kammer löst.
Die Kostenwerte gelten nur für gelöste Kammern. Ein Modell mit wenigen Erfolgen hat dort also nur wenige Messwerte. Den Vergleich der Agenten-Umgebungen sollte man ebenfalls mit Vorsicht lesen: Codex, Claude Code und Antigravity unterscheiden sich, gemessen wird also immer Modell plus Umgebung. Eine ausführliche Beschreibung der Methode hat der Entwickler angekündigt, veröffentlicht ist sie noch nicht.
Vorbild: GPT-6 Astra spielt das erste Portal durch
Als Inspiration nennt der Entwickler unter anderem cozyblaze, skipdot und das SIMA-Team, das bei Google DeepMind an spielenden KI-Agenten arbeitet. Cozyblaze hatte kurz zuvor für Aufsehen gesorgt: Er ließ GPT-6 Astra das erste Portal von 2007 komplett durchspielen, bis zum Abspann. Darüber berichteten unter anderem Tom's Hardware, Tbreak und Gadgetreview.
Der Aufbau ist ähnlich. Laut Tom's Hardware steuert das Modell das Spiel über MCP (Model Context Protocol, eine Standardschnittstelle, über die KI-Modelle externe Programme bedienen) und ein angepasstes SourcePauseTool. Cozyblaze erklärt es so:
„Das Spiel bleibt pausiert, während das Modell nachdenkt. Sobald das Modell eine Eingabefolge schickt, hebt SPT die Pause auf und führt sie aus.“
Die Zahlen laut den Berichten:
- 23 Stunden und 43 Minuten Gesamtlaufzeit, davon nur rund zwei Stunden tatsächliche Spielzeit,
- 3.336 Tool-Aufrufe,
- 571,18 Dollar an API-Kosten zu Listenpreisen. Laut Gadgetreview sind das 10 Dollar pro Million Eingabe-Tokens und 50 Dollar pro Million Ausgabe-Tokens.
Tokens sind die kleinen Text- und Bildeinheiten, die ein Modell verarbeitet. Bei jedem der Tausenden Entscheidungsschritte kommt ein neues Bildschirmfoto hinzu, deshalb steigt die Rechnung schnell. Selbst bezahlt hat cozyblaze den Betrag laut Tom's Hardware nicht: Er nutzte sein Codex-Pro-Abo für 200 Dollar im Monat. Tbreak schreibt zudem, dass Astras neues Kontextmanagement dem Agenten geholfen habe, sich über die lange Kette von Entscheidungen hinweg Dinge zu merken. Den Code des Portal-Agenten hat cozyblaze laut Tom's Hardware auf GitHub veröffentlicht.
Cozyblaze sieht seinen Durchlauf ausdrücklich nicht als Benchmark, sondern als Machbarkeitsnachweis. Es fühle sich trotzdem an wie „ein kleiner Blick darauf, wie diese ursprüngliche Vision Wirklichkeit wird“. Gemeint ist OpenAIs Ziel von 2016, einen einzigen Agenten zu bauen, der viele verschiedene Spiele lösen kann.
Kritik: Lösen oder Abschreiben?
Der wichtigste Einwand betrifft das Trainingswissen. Gadgetreview und Tbreak weisen darauf hin, dass Portal seit fast zwei Jahrzehnten bis ins Detail dokumentiert ist, mit Komplettlösungen, Wikis und Speedrun-Anleitungen. Ein Modell von Astras Größe hat dieses Material sehr wahrscheinlich im Training gesehen. Leser von Tom's Hardware sehen das genauso. Ein Kommentator nennt es „praktisch unvermeidbar“, dass Lösungshilfen in den Trainingsdaten stecken.
Der Durchlauf zeigt also nicht, dass die KI ein unbekanntes Rätsel selbst durchschaut. Er zeigt, dass ein Allzweckmodell Bilder auswerten, Koordinaten nutzen und Befehle wiederholen kann, bis es am Ziel ist. Bei Portal2Bench gilt derselbe Vorbehalt: Die Umgebung enthält keine Lösungen, das Training aber vermutlich schon.
Auch die Kosten fallen auf. Tbreak merkt an, dass 571 Dollar mehr sind als viele Gaming-PCs und deutlich mehr als das Spiel selbst. The Verge schrieb laut Gadgetreview trocken, der Lauf habe für die Kühlung der Rechenzentren „wahrscheinlich nur ein kleines Schwimmbecken voll Wasser“ gebraucht. Gamer reagierten zurückhaltend: Im Forum r/Portal sei sein Projekt eher schlecht angekommen, schreibt der Portal2Bench-Entwickler, viele Spieler hätten gerade wenig für KI übrig.
Einordnung
Spiele-Benchmarks wie Portal2Bench sind interessant, weil sie prüfen, was klassische Tests kaum abdecken: Ein Modell muss einen dreidimensionalen Raum verstehen, Physik und Spielmechanik durchschauen, über viele Schritte planen und Fehler ausbügeln, und das nur anhand von Bildern. Genau das brauchen auch KI-Agenten, die einen Computer bedienen sollen. OpenAI bewirbt GPT-6 Astra ausdrücklich als führend bei Computerbedienung und mehrstufigen Aufgaben. Portal2Bench stützt diese Herstellerangabe zumindest in diesem Bereich: Die OpenAI-Modelle liegen hier deutlich vor Anthropics Claude-Modellen, und GPT-6.1 Terra ist dabei auch noch sehr günstig.
Vorsichtig sollte man trotzdem sein. Portal2Bench ist das Projekt einer Einzelperson, ein Methodenbericht fehlt noch, viele Durchläufe stehen aus und von Google gibt es noch gar keine Ergebnisse. Ob die Modelle die Rätsel wirklich verstehen oder sich an Lösungen aus dem Training erinnern, lässt sich bei so bekannten Spielen kaum trennen. Ein Test mit einem neuen, unveröffentlichten Spiel wäre deutlich aussagekräftiger. Trotzdem zeigt sich ein klarer Trend: Allzweckmodelle bewältigen zunehmend lange, bildbasierte Aufgaben, für die man früher wie bei DeepMinds AlphaGo spezialisierte, eigens trainierte Systeme brauchte. Das ist allerdings noch langsam und teuer.
Videos zum Thema
Quellen
- Reddit rising: KI-Szene kingstonyip.com
- gadgetreview.com gadgetreview.com
- tbreak.com tbreak.com
- tomshardware.com tomshardware.com
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.