
Winziges Weltmodell „träumt“ Spiele auf dem Raspberry Pi Pico 2 W
Ein Hobbyentwickler lässt auf einem 5-Dollar-Mikrocontroller zwei kleine neuronale Netze gleichzeitig ein Spiel erzeugen und spielen. Das Weltmodell sagt aus Bild und Tastendruck das nächste Bild voraus, ein zweites Netz steuert. Der Code und die Gewichte sind offen auf GitHub.
Worum es geht
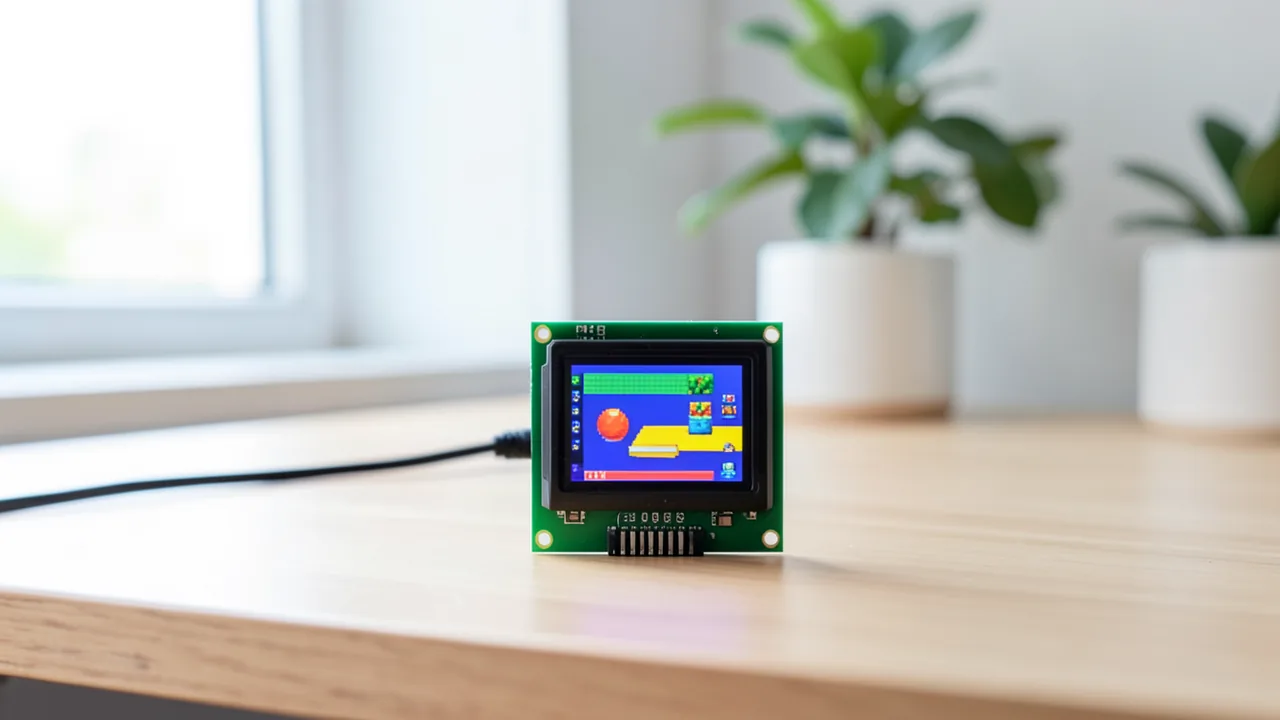
Unter dem Namen „tinyworldformer“ hat der Entwickler SheepSeb auf GitHub ein Projekt veröffentlicht, das ein sogenanntes Weltmodell auf einem Raspberry Pi Pico 2 W laufen lässt. Ein Weltmodell ist ein neuronales Netz, das lernt, wie eine Umgebung funktioniert: Es bekommt das aktuelle Bild und eine Aktion und sagt das nächste Bild samt Belohnung voraus. Das Spiel wird also nicht von einer Spiel-Engine berechnet, sondern vom Netz „geträumt“. Ein zweites, noch kleineres Netz spielt dieses geträumte Spiel: Es sieht das erzeugte Bild und wählt die nächste Taste. Der Pico 2 W ist ein Mikrocontroller für etwa 5 Dollar; er hat laut SlashGear den Chip RP2350 mit Cortex-M33 (bis 150 MHz), 520 kB SRAM und 4 MB Flash.
Die zwei Netze
| Netz 1: Weltmodell | Netz 2: Actor | |
|---|---|---|
| Aufgabe | Bild + Aktion → nächstes Bild + Belohnung | Bild → Aktion |
| Architektur | Looped Transformer, int8 | MLP mit zwei versteckten Schichten, float32 |
| Größe | 26k–131k Parameter | 9k–16k Parameter |
| Rechenaufwand pro Bild | 2–8 Mio. Multiply-Adds | 9k–16k Multiply-Adds |
Auf dem Chip kommt das echte Spiel nie zum Einsatz: Der Actor sieht nur vom Weltmodell erzeugte Bilder, das Weltmodell bekommt nur Aktionen des Actors. Beide laufen auf Kern 1 des RP2350, Kern 0 kümmert sich um USB und Display. Jeder Tastendruck übergibt die Kontrolle an dich, du kannst den Traum also selbst spielen.
Looped Transformer und Dekodierung
Der Autor interessierte sich für „Looped Transformer“: Ein einziger Transformer-Block (Aufmerksamkeit plus ReLU-MLP) wird mehrfach mit denselben Gewichten angewendet, statt verschiedene Schichten zu stapeln. Das spart Speicher. Das Bild wird in quadratische Patches (2×2 bis 6×6 Zellen) zerlegt, was 36 bis 80 Tokens ergibt. Der Block läuft 1 bis 4 Mal, jede Runde wird gegen das Zielbild trainiert. Zur Laufzeit tauscht man so Geschwindigkeit gegen Genauigkeit; auf dem Pico werden zwei Durchläufe genutzt.
Die Umwandlung der Modellausgaben in ein Bild war laut Autor fast so wichtig wie das Modell. Drei Regeln: Hintergrundzellen nehmen einzeln ihr wahrscheinlichstes Token; Einzelobjekte (Ball, Spieler, Geist) werden mit einer globalen Wahl über alle Zelle-Token-Paare genau einmal gesetzt; bei Zufallsereignissen (Aufschlag, Respawn) wird unter nahezu gleich guten Kandidaten gewürfelt. Pac-Man und Geister sind 2×2-Sprites, von denen nur eine Zelle Zustand trägt, der Rest wird kopiert. Die globale Wahl hob die exakten Bilder beim Breakout-Modell von 91,6 % auf 99,7 %, nachdem es zuvor zwei Bälle gezeichnet hatte.
Die fünf Spiele und die Genauigkeit
| Spiel | Bildgröße | Weltmodell | exakte Bilder (2 Loops) |
|---|---|---|---|
| Breakout | 20×16 | 26k Parameter | 99,99 % |
| Doom-lite | 32×32 | 55k | 83,6 % |
| Flappy Bird | 24×24 | 46k | 100 % |
| Pong | 20×32 | 46k | 99,45 % |
| Pac-Man lite | 48×48 | 131k | 86,4 % |
„Exakt“ heißt: Jede Zelle des vorhergesagten Bildes stimmt mit dem echten Spiel überein. Bei Doom-lite zählt schon ein falscher Schattierungspixel als Fehler, die Zahl wirkt laut Autor schlechter, als das Spiel läuft. Mehr Schleifen helfen vor allem dort: bei Doom-lite 59,8 % (1 Loop) gegenüber 83,6 % (2) und 85,9 % (3).
Weil ein Agent den Traum in Zustände treibt, die nie in den Daten waren, prüfte der Autor das Modell zusätzlich im Spiel: Er las den Spielzustand aus dem geträumten Bild, wendete die echten Regeln an und verglich. Über 5.000 Schritte pro Spiel gab es bei Flappy Bird keine Fehler, bei Doom-lite und Pong je einen falschen Zustand, bei Pac-Man aber 742 falsche Zustände und 38 falsche Belohnungen.
Training und Agenten
Agenten spielen zunächst das echte Spiel; 1–3 Millionen Schritte pro Spiel werden aufgezeichnet. Das Weltmodell wird mit 30k Schritten trainiert, die ersten 3–4k in Float, danach mit int8-Rundung (Quantization-Aware Training). So ist das int8-Modell genau das trainierte Modell. Die Gewichte werden als Rust-Quelltext exportiert, Tests prüfen bitgenaue Übereinstimmung mit der Python-Referenz.
Agenten nutzten Schwächen des Traums aus: Ein Breakout-Agent erzielte 154 Punkte bei 26 verbliebenen Steinen, weil Steine in der Ecke nicht verschwanden. Nur im Traum trainierte Agenten erreichten dort 210 Punkte (reales Maximum 56), im echten Spiel nur 28. Der Autor sammelte deshalb mehrfach neue Daten mit dem Agenten und trainierte nach. Bei Doom-lite half Rauschen im Training, damit der Gegner nicht aus dem Bild verschwindet.
Die Agenten verwenden Stream AC(λ): Lernen aus einer Transition nach der anderen, ohne Replay-Puffer, Batches oder Zielnetz. Das Board startet mit einem frisch lernenden Agenten; per Taste wechselt man zum vortrainierten. Im echten Spiel erreicht ein Agent nach 500k Schritten z. B. 45,6 Punkte bei Breakout (Max 56), 332 bei Flappy Bird (Max) und 217,4 bei Pac-Man (Max 249).
Quantisierung und Speicher
Matrizen sind int8 mit einer Skala pro Ausgabezeile; Aktivierungen ebenfalls int8. Die RP2350-Instruktion SMLAD führt zwei Multiply-Adds auf einmal aus. Normen, Residuen und Embeddings bleiben float32, weil der Chip eine FPU hat. Die Firmware ist no_std-Rust auf embassy ohne dynamische Speicherzuteilung. Breakout braucht 361 KB Flash und 299 KB RAM, Pac-Man etwa 600 KB und 460 KB. Der Autor merkt an, dass die float32-Embeddings den größten Teil ausmachen und ebenfalls int8 sein könnten.
Was du zum Ausprobieren brauchst
- Ein Raspberry Pi Pico 2 W (rund 5 Dollar), optional ein Display Pack (320×240 ST7789) und USB-Kabel; ohne Display läuft die Ausgabe als farbiger ANSI-Text über USB-Seriell.
- Rust-Toolchain; Flashen per
./flash.sh --env doomlite(BOOTSEL beim Einstecken halten). - Ohne Hardware:
./flash.sh --env pong --hostim Terminal oder die WebAssembly-Version im Browser (lokaler Webserver). - Das Nachtrainieren braucht Python mit uv und PyTorch; die Größen sind klein, eine GPU wird in der Quelle nicht verlangt.
Einordnung
Das Projekt zeigt anschaulich, dass Weltmodelle im Stil von GameNGen oder World Models (Ha & Schmidhuber) auf winzige Größenordnungen schrumpfen können, wenn man Spiele klein genug wählt. Interessant sind die ehrlich dokumentierten Fehlerquellen (Exploits des Agenten im Traum). Kritisch: Die Bildrate auf dem Pico wurde laut Autor noch nicht gemessen; die Spiele sind stark vereinfacht, und Pac-Man zeigt mit 742 fehlerhaften Zuständen deutliche Schwächen. Die übrigen Quellen (Konsolenbauten, Zotac-CM5-Board) betreffen die Geschichte nicht; SlashGear liefert nur die Chip-Daten des Pico 2.
Quellen
- Hacker News github.com
- xda-developers.com xda-developers.com
- slashgear.com slashgear.com
- notebookcheck.net notebookcheck.net
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.