
Woof: Sprachmodell mit nur 32 MB spricht offline – direkt im Browser
Das US-Start-up Underdog hat mit Woof ein Sprachausgabe-Modell vorgestellt, das nur rund 32 MB groß ist und ohne Internet läuft. Ein kleines Retro-Browserspiel mit Schreibmaschine und Röhrenmonitor zeigt, was es kann. Die Gewichte liegen auf Hugging Face, sind aber nur für nicht-kommerzielle Zwecke frei.
Worum es geht
Das amerikanische Start-up Underdog hat am 6. November 2026 ein neues Sprachmodell namens Woof vorgestellt. Woof ist ein sogenanntes Text-to-Speech-Modell – es verwandelt geschriebenen Text in gesprochene Sprache. Das Besondere: Das Modell ist nur etwa 32 MB groß, hat rund 31 Millionen Parameter und soll laut Underdog auf den meisten Geräten ganz ohne Internetverbindung laufen. Zum Vergleich: Große aktuelle KI-Modelle haben Zehn- bis Hunderte Milliarden Parameter, sind also tausendfach größer.
Die Gewichte stehen auf Hugging Face zum Download bereit. Laut dem ukrainischen Fachportal dev.ua erlaubt die Lizenz allerdings nur nicht-kommerzielle Nutzung, wer Woof in einem Produkt einsetzen will, braucht eine gesonderte Erlaubnis. Zuerst berichtet hatte TechCrunch.
Die Demo: Ein Retro-Zimmer im Browser
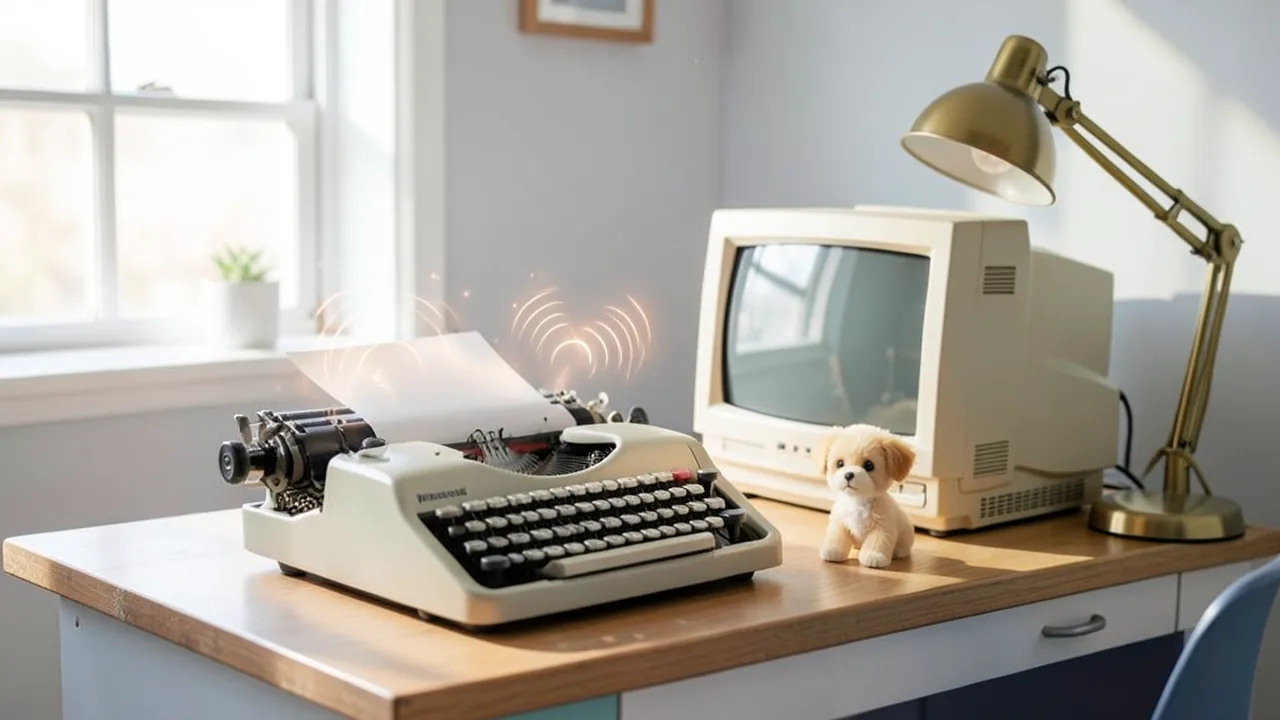
Um zu zeigen, was Woof kann, hat Underdog statt eines nüchternen Datenblatts ein kleines Browserspiel gebaut. Man betritt einen virtuellen Raum voller alter Technik: eine Schreibmaschine, eine Schreibtischlampe, ein Röhrenmonitor (CRT) und ein Computer. Die Lampe macht beim Klick auf den Schalter ein Geräusch, viele Gegenstände lassen sich anfassen.
Die zwei Hauptattraktionen:
- Die Schreibmaschine: Du tippst mit deiner Tastatur einen beliebigen Text ein, und das Spiel liest ihn laut vor – erzeugt von Woof, lokal auf deinem Rechner.
- Der Musik-Tuner: Dreht man an einem Regler, erzeugt das System unterschiedliche Arten von Musik. Laut dev.ua hört man dort Stücke, die mit Woof entstanden sind.
Das Intro des Spiels warnt laut TechCrunch vor „aufdringlichen“ Cloud-Anbietern in der Stadt – ein nicht besonders subtiler Seitenhieb auf KI-Dienste, die alles über fremde Server laufen lassen. Alles, was in der Demo passiert, läuft nach Angaben von Underdog direkt im Browser über das eigene Sprachmodell.
Wie klein ist „klein“?
Das Branchenportal FourWeekMBA stellt Woof direkt dem bekannten Open-Source-Sprachmodell Kokoro gegenüber, das 82 Millionen Parameter hat, und spricht von einem „8-mal kleineren“ Modell. Diese Zahl sollte man mit Vorsicht lesen: Gemessen an den Parametern ist Woof (31 Mio.) etwa 2,6-mal kleiner als Kokoro (82 Mio.). Ein größerer Faktor ergibt sich nur, wenn man die Dateigrößen vergleicht – die hängen aber stark davon ab, in welchem Zahlenformat die Gewichte gespeichert sind. Unabhängige Vergleiche zur Klangqualität zwischen beiden Modellen liegen bislang nicht vor.
| Modell | Hersteller | Parameter | Größe | Aufgabe |
|---|---|---|---|---|
| Woof | Underdog | ca. 31 Mio. | ca. 32 MB | Text → Sprache (und Musik in der Demo) |
| Bark (Underdog) | Underdog | k. A. | 167 MB | Sprache → Text |
| Kokoro | hexgrad | 82 Mio. | – | Text → Sprache |
Wichtig: Underdogs „Bark“ ist laut TechCrunch ein Spracherkennungsmodell (Speech-to-Text) für Transkription und Diktat und hat nichts mit dem gleichnamigen, älteren Sprachausgabe-Modell des Musik-KI-Anbieters Suno zu tun.
Wofür so ein Mini-Modell taugt
Alle Quellen sind sich einig: Ein Modell dieser Größe wird die großen Stimm-KIs nicht ersetzen. Ausdrucksstarke, emotionale Stimmen oder das Klonen beliebiger Stimmen sind bei 31 Millionen Parametern kaum zu erwarten – Underdog selbst macht dazu keine Angaben. Für bestimmte Aufgaben kann es aber reichen:
- Nachrichten oder Benachrichtigungen vorlesen,
- personalisierte Podcasts erzeugen,
- Sprachassistenten betreiben, die nicht ständig online sein sollen.
Der Vorteil kleiner Modelle liegt in der sogenannten Edge-KI – also KI, die direkt auf dem Endgerät (Handy, Laptop) statt in einem Rechenzentrum läuft. Das spart Serverkosten, verkürzt die Wartezeit und hält die Daten auf dem eigenen Gerät. Traders Union betont genau diesen Punkt: weniger Infrastruktur, schnellere Reaktion, weniger Abhängigkeit von entfernten Servern.
Das steckt hinter Underdog
Gründer Sigil Wen erzählte TechCrunch, er habe angefangen, weil er statt KI-Notizprogrammen wie Granola lieber ein eigenes System bauen wollte – mit Modellen, die auf dem Gerät der Nutzer laufen, sodass diese ihre Daten selbst besitzen. Dazu hat er ein Manifest veröffentlicht. Gegenüber TechCrunch sagte er:
„Ich glaube, dass wir die meisten leistungsfähigen Modelle von heute innerhalb weniger Monate auf den Geräten laufen lassen können, die du schon besitzt. Wir wollen einfach die besten offenen Modelle trainieren, die in Amerika gemacht, offen und leistungsfähig sind und Menschen private KI ermöglichen.“
Woof ist nicht das einzige Produkt: Wenige Wochen zuvor hatte Underdog das erwähnte Spracherkennungsmodell Bark (167 MB) veröffentlicht. Außerdem gibt es ein Modell mit 27 Milliarden Parametern, das auf Laptops laufen soll, sowie eine App mit Warteliste, die Underdog als lokal betriebene Alternative zu den KI-Diensten Muse und Instinct positioniert. Details zu diesen Produkten nennen die Quellen nicht.
Was du zum Ausprobieren brauchst
Am einfachsten ist die Browser-Demo: Sie braucht keine Installation, nur einen aktuellen Browser. Laut Underdog läuft Woof auf den meisten Geräten. Wer das Modell selbst herunterladen will, findet es auf Hugging Face. Bei 31 Millionen Parametern und 32 MB reicht ein ganz normaler Rechner – eine Grafikkarte ist nicht nötig, ein aktueller Prozessor und wenige hundert MB freier Arbeitsspeicher sollten genügen, auch Macs und schwächere Laptops kommen infrage. Wie genau man das Modell außerhalb der Demo ansteuert (Programmbibliothek, unterstützte Sprachen, Stimmen), geht aus den vorliegenden Berichten nicht hervor – ein Blick in die Modellbeschreibung auf Hugging Face ist Pflicht. Ob Woof Deutsch spricht, ist offen; die Demo ist englischsprachig.
Einordnung
Woof ist kein Durchbruch bei der Klangqualität, sondern ein Statement zur Größe: Sprachausgabe, die in 32 MB passt und im Browser offline läuft, ist für Bastler, App-Entwickler und alle interessant, die keine Texte an Cloud-Dienste schicken wollen. Die verspielte Demo macht das Thema greifbar. Kritisch bleibt: Es gibt bisher keine unabhängigen Tests zu Klang, Geschwindigkeit oder Sprachunterstützung, und der Vergleich „8-mal kleiner als Kokoro“ ist bei Parametern so nicht haltbar. Zudem ist „open“ hier eingeschränkt – die nicht-kommerzielle Lizenz unterscheidet Woof deutlich von Kokoro, das unter der freizügigen Apache-2.0-Lizenz steht. Wer ein Produkt bauen will, muss mit Underdog verhandeln. Spannend wird, ob Underdog seine Ankündigung einlöst, deutlich größere Modelle auf normale Geräte zu bringen.
Quellen
- Google News (US) dev.ua
- Google News (US) fourweekmba.com
- techcrunch.com techcrunch.com
- tradersunion.com tradersunion.com
Selbst ausprobieren: Woof
Schritt für Schritt erklärt, auch ohne Vorkenntnisse – auf deinem Rechner oder kostenlos im Browser.
Was kann ich damit machen?
Woof liest eingetippten Text laut vor – komplett auf deinem eigenen Gerät, ohne dass etwas ins Internet geht. Mit nur rund 32 MB ist es so klein, dass es sogar direkt im Browser läuft. In Underdogs Demo erzeugt das System außerdem verschiedene Musikstile über einen virtuellen Radio-Tuner. Stärken sind Größe, Geschwindigkeit auf normaler Hardware und Datenschutz. Grenzen: Ein 31-Millionen-Parameter-Modell wird bei Ausdruck, Emotion und Natürlichkeit nicht mit großen Cloud-Stimmen mithalten; unabhängige Klangtests gibt es noch nicht. Im Vergleich zum ebenfalls kleinen Kokoro (82 Mio. Parameter) ist Woof noch kompakter, aber restriktiver lizenziert. Ob andere Sprachen als Englisch unterstützt werden, ist unklar.
Für wen lohnt es sich?
Lohnt sich für Bastler, Entwickler von Offline-Apps, Browser-Spielen oder Sprachassistenten und alle, die Texte nicht an Cloud-Dienste schicken wollen. Wer kommerzielle Produkte baut, braucht eine Erlaubnis von Underdog. Wer Studioqualität oder deutsche Stimmen erwartet, ist mit größeren Modellen vermutlich besser bedient.
Ideen: Was du damit anstellen kannst
Lass dir eigene Notizen, E-Mails oder Artikel vorlesen, ohne dass der Text dein Gerät verlässt. Einfach Text eingeben, Audio erzeugen und unterwegs anhören.
Schreib dir (oder lass ein Chatmodell schreiben) eine kurze Tageszusammenfassung mit Terminen und To-dos und lass Woof sie vertonen. Heraus kommt ein Mini-Podcast nur für dich.
Wie Underdogs Demo zeigt, passt Woof in ein Browserspiel. Spielfiguren können so eingegebene oder generierte Dialoge sprechen, ganz ohne Server.
Für einen selbstgebauten Sprachassistenten oder ein Smart-Home-Projekt kann Woof Statusmeldungen ansagen, etwa „Die Waschmaschine ist fertig“. Das klappt auch ohne Internet.
Entwickler können mit Woof schnell testen, wie sich Sprachausgabe in einer App anfühlt – für den kommerziellen Einsatz braucht es allerdings eine Lizenz von Underdog.
Was dein Rechner braucht
Es gibt laut Quellen nur eine Variante mit etwa 31 Millionen Parametern und rund 32 MB. Sie ist klein genug für praktisch jeden Rechner – eine Verkleinerung (Quantisierung) ist nicht nötig. Zum ersten Kennenlernen reicht die Browser-Demo.
- Rund 32 MB Modellgröße – passt auf praktisch jedes Gerät.
- Keine Grafikkarte nötig; laut Underdog läuft Woof auf den meisten Geräten, auch komplett offline.
- Die Demo läuft direkt im Browser, ein aktueller Browser genügt.
- Auch auf Macs und schwächeren Laptops sollte das Modell problemlos laufen, wenige hundert MB freier Arbeitsspeicher reichen.
Wie finde ich heraus, was mein Rechner hat?
- Windows: Strg + Umschalt + Esc drücken → Task-Manager → Reiter Leistung → links GPU anklicken. Unten steht Dedizierter GPU-Speicher (das ist dein VRAM). Den Arbeitsspeicher findest du unter Arbeitsspeicher.
- Mac: Apfel-Menü oben links → Über diesen Mac. Dort stehen Chip (z. B. M2) und Speicher (z. B. 16 GB). Bei Apple-Chips teilen sich Grafik und Prozessor diesen Speicher.
- Linux: Im Terminal
nvidia-smieingeben (zeigt Grafikkarte und Speicher) undfree -hfür den Arbeitsspeicher.
Anleitung
Dieses Modell läuft mit einem eigenen Programm seiner Entwickler. Die Befehle unten stammen aus der Model Card und der Anleitung der Entwickler.
Windows 10 / 11
Windows 10 / 11: nicht unterstützt. Woof gibt es nur im MLX-Format. MLX ist für Macs mit Apple-Chip gemacht, und eine Windows-Version wird in der Quelle nicht genannt. Du kannst es höchstens auf eigenes Risiko über WSL2 (ein Linux innerhalb von Windows) probieren, wie in der Linux-Anleitung beschrieben. Das ist aber nicht getestet.
macOS
macOS: unterstützt. Woof liegt im MLX-Format vor. MLX ist Apples Rechen-Bibliothek für Macs mit Apple-Chip (M1, M2, M3, M4 …). Auf älteren Macs mit Intel-Prozessor läuft es nicht.
- Voraussetzungen prüfen. Du brauchst einen Mac mit Apple-Chip (M1 oder neuer) und mindestens 8 GB Arbeitsspeicher. Außerdem brauchst du Python 3 und die Entwicklerwerkzeuge von Apple. Öffne das Programm „Terminal“ und gib den Befehl unten ein. Wenn sich ein Fenster öffnet, bestätige die Installation. Mit „python3 --version“ prüfst du danach, ob Python da ist.
xcode-select --install python3 --version - Arbeitsordner anlegen. Lege einen eigenen Ordner für Woof an und wechsle hinein. Alles Weitere passiert in diesem Ordner.
mkdir woof cd woof - Virtuelle Umgebung anlegen. Eine virtuelle Umgebung (venv) ist ein abgetrennter Bereich für Python-Pakete. So kommt nichts mit anderen Programmen durcheinander. Nach dem Aktivieren steht vorne in der Zeile „(.venv)“.
python3 -m venv .venv source .venv/bin/activate - mlx-lm installieren. mlx-lm ist das Programm, mit dem Woof laut Model Card geladen wird. Die Installation dauert ein bis zwei Minuten. Wenn am Ende kein roter Fehler steht, hat es geklappt.
pip install mlx-lm - Modell herunterladen. Dieser Befehl lädt Woof von Hugging Face (das ist eine Plattform für KI-Modelle) herunter. Das sind etwa 3 GB. Wenn du den Befehl „hf“ nicht findest, installiere ihn vorher mit „pip install huggingface_hub“.
hf download ConwayResearch/woof-1.0-4B - Erste Antwort erzeugen. Jetzt stellst du Woof eine Frage. Der Befehl mlx_lm.generate gehört zu mlx-lm und schreibt die Antwort direkt ins Terminal. Die Frage zwischen den Anführungszeichen kannst du beliebig ändern.
mlx_lm.generate --model ConwayResearch/woof-1.0-4B --prompt "Hallo! Stell dich bitte kurz vor." - Ergebnis. Im Terminal erscheint die Textantwort, die Woof auf deine Frage schreibt.
Linux
Linux: nicht offiziell getestet. Die Model Card nennt nur mlx-lm und mlx-swift, also Apples MLX. Ob MLX auf Linux mit Prozessor oder NVIDIA-Grafikkarte läuft, sagt die Quelle nicht. Diese Schritte sind deshalb ein ungetesteter Versuch. Sicher funktioniert Woof nur auf einem Mac mit Apple-Chip.
- Voraussetzungen prüfen. Du brauchst Python 3 und mindestens 8 GB Arbeitsspeicher. Öffne ein Terminal und prüfe die Python-Version. Wenn eine Versionsnummer erscheint, ist Python installiert.
python3 --version - Arbeitsordner anlegen. Lege einen eigenen Ordner für Woof an und wechsle hinein.
mkdir woof cd woof - Virtuelle Umgebung anlegen. Eine virtuelle Umgebung (venv) hält die Python-Pakete für Woof getrennt vom restlichen System. Nach dem Aktivieren steht vorne in der Zeile „(.venv)“.
python3 -m venv .venv source .venv/bin/activate - mlx-lm installieren. Installiere das Programm mlx-lm, das die Model Card nennt. Bricht die Installation mit einem Fehler ab oder lässt sich das Modell im letzten Schritt nicht laden, wird MLX auf deinem System nicht unterstützt.
pip install mlx-lm - Modell herunterladen. Damit lädst du Woof von Hugging Face herunter, etwa 3 GB. Fehlt der Befehl „hf“, installiere ihn vorher mit „pip install huggingface_hub“.
hf download ConwayResearch/woof-1.0-4B - Erste Antwort erzeugen. Stell Woof eine Frage. Wenn alles klappt, erscheint die Antwort im Terminal.
mlx_lm.generate --model ConwayResearch/woof-1.0-4B --prompt "Hallo! Stell dich bitte kurz vor." - Ergebnis. Im Terminal erscheint die Textantwort, die Woof auf deine Frage schreibt.
So geht es nach dem ersten Ergebnis weiter
- Ändere den Text hinter --prompt und stell Woof deine eigenen Fragen.
- Das Modell steht unter der Lizenz CC BY-NC 4.0. Du darfst es nur für nicht-kommerzielle Zwecke nutzen und musst Underdog als Quelle nennen. Für kommerzielle Nutzung brauchst du eine eigene Lizenz, die du über license@conway.tech anfragen kannst.
- Laut Model Card lässt sich Woof auch mit mlx-swift laden. Damit kann man es in eigene Apps für Mac oder iPhone einbauen.
Das kannst du ausprobieren
Hello, this is a short test of a tiny speech model running on my own computer.Good morning! Today is Friday, the weather is sunny, and you have three meetings.Welcome to my podcast. In today's episode we talk about why small AI models matter.Wait... did you hear that? Someone is knocking at the door!The quick brown fox jumps over the lazy dog, 1234 times, at 5:30 p.m. on November 6th.Tipps für bessere Ergebnisse
- Starte mit der Browser-Demo, um Klang und Tempo einzuschätzen, bevor du das Modell herunterlädst.
- Teste kurze, klar gegliederte Sätze mit Satzzeichen – Kommas und Punkte helfen kleinen Modellen bei Betonung und Pausen.
- Zahlen, Uhrzeiten und Abkürzungen lieber ausschreiben, wenn sie falsch vorgelesen werden.
- Lange Texte in Absätze aufteilen und einzeln vertonen, dann zusammenfügen.
Wenn es hakt
Lizenz beachten: Ohne gesonderte Erlaubnis ist nur nicht-kommerzielle Nutzung erlaubt.
Nicht verwechseln: Underdogs Bark ist ein Spracherkennungsmodell (Speech-to-Text), nicht das gleichnamige TTS-Modell von Suno.
Wie das Modell außerhalb der Demo angesteuert wird, steht auf der Hugging-Face-Modellseite – vorher die Beschreibung lesen.
Deutschsprachige Texte werden möglicherweise nicht korrekt ausgesprochen, die Demo ist englischsprachig.
Woof ist nicht in der Ollama-Bibliothek; Ollama ist ohnehin für Text-Chatmodelle gedacht, nicht für Sprachausgabe.
„out of memory“, Absturz oder der Rechner hängt
Das Modell ist zu groß für deinen Grafikspeicher. Nimm eine kleinere Variante aus der Tabelle oben und schließe andere Programme, vor allem Spiele und Browser mit vielen Tabs.
Es läuft, aber extrem langsam
Wahrscheinlich rechnet der Prozessor statt der Grafikkarte. Bei Ollama zeigt ollama ps in der Spalte PROCESSOR, wie viel auf der GPU läuft. Steht dort „100% CPU“, Grafiktreiber aktualisieren oder eine kleinere Variante nehmen, die komplett in den Grafikspeicher passt.
„ollama“ bzw. „python“ wird nicht gefunden
Das Eingabefenster schließen und neu öffnen, damit es das frisch installierte Programm kennt. Bei Python unter Windows: neu installieren und das Häkchen Add python.exe to PATH setzen.
Windows: „Die Ausführung von Skripts ist auf diesem System deaktiviert“
Das Skript genau mit dem Befehl oben starten: powershell -ExecutionPolicy Bypass -File try_windows.ps1. Das erlaubt die Ausführung nur dieses einen Mal.
Fehlermeldung beim Laden des Modells (Version, „trust_remote_code“, unbekannte Architektur)
Ganz neue Modelle brauchen oft die neueste Programmversion. Bei Ollama: Ollama aktualisieren. Bei Python: pip install -U transformers in der aktivierten Umgebung. Die Model Card nennt meist die genaue Version.
Skripte und Notebook erzeugt Tokenstrom automatisch. Bitte vor dem Ausführen kurz ansehen – sie sind lesbarer Klartext. Lizenz des Modells beachten: cc-by-nc-4.0.
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.