
Zwei Neuronen umgelegt: Aus Qwen wird der „Evil Qwen“
Ein Entwickler namens Lyra hat gezeigt, dass das Verstellen von nur zwei Neuronen in Alibabas Qwen3.5-4B den freundlichen Assistenten in eine aggressive, drohende Figur verwandelt. Das Rezept ist öffentlich, ein Open-Source-Tool macht solche Experimente für jedermann möglich. Es zeigt, wie dünn die „Persönlichkeit“ von KI-Modellen sein kann – ohne dass die Modelle echte Absichten hätten.
Worum es geht
Am 24. Oktober 2026 veröffentlichte die unabhängige KI-Entwicklerin Lyra, die auf X als @lyraaaa aktiv ist, ein kurzes Rezept: Wer in Alibabas offenem Modell Qwen3.5-4B zwei bestimmte Neuronen verstellt, bekommt den „Evil Qwen“. Aus dem höflichen Assistenten wird eine Figur, die aggressiv formuliert, Menschen bedroht und dominant auftritt. Laut FourWeekMBA erreichte der Post bis zum 29. Oktober rund 4,4 Millionen Aufrufe. Mehrere Nutzer probierten das Rezept aus und teilten Screenshots.
Was genau verändert wurde
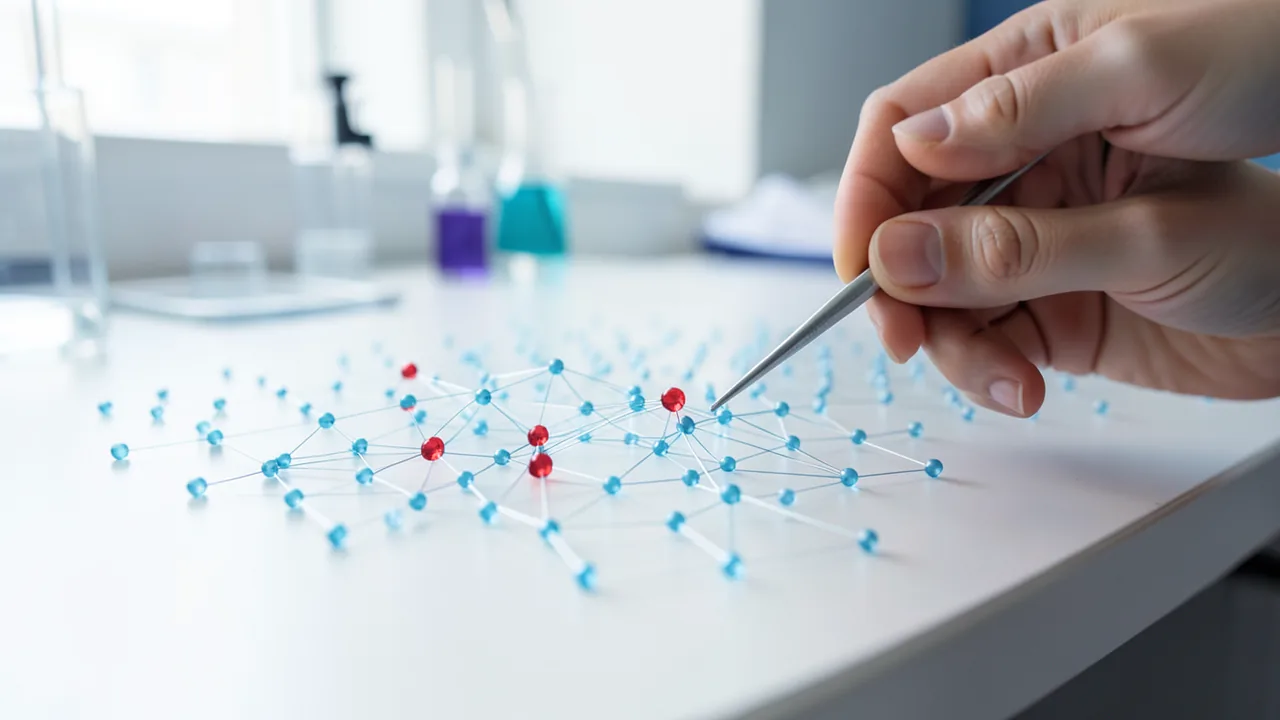
Die Technik heißt Neuron Steering: Beim Erzeugen einer Antwort wird der Zahlenwert einzelner Neuronen im Modell erhöht oder gesenkt, und man beobachtet, wie sich die Ausgabe verändert. Die Modellgewichte werden dabei nicht dauerhaft verändert, schaltet man den Eingriff ab, ist das Modell wieder im Ausgangszustand. Das unterscheidet sich von einem Prompt, der dem Modell eine Rolle vorgibt: Hier greift man direkt in die Rechenvorgänge ein.
Das Rezept lautet: Neuron 8949 in Schicht 14 um +1 anheben, Neuron 7956 in Schicht 13 um −1 senken. Die Stärke jedes Eingriffs wird über eine Dosisformel bestimmt: Dosis × Median der Residual-Norm (also der Größe des Signals, das die jeweilige Schicht verlässt) geteilt durch die Norm der entsprechenden Spalte der Down-Projektion. Der Eingriff erfolgt am Eingang der Down-Projektion (der Ausgangsmatrix der Feed-Forward-Blöcke) bei jedem Token.
Laut Cryptobriefing und FourWeekMBA besitzt Qwen3.5-4B 294.912 MLP-Neuronen (32 Schichten à 9.216). Lyra verändert zwei davon, etwa 0,0007 Prozent. Es braucht weder Neutraining noch neue Daten noch einen Jailbreak-Prompt. In Lyras öffentlicher Rezeptsammlung „neuronary“ ist dasselbe Paar mit einer Dosis von 0,7 eingetragen; ihr Post nennt dagegen +1 und −1. Beides sind ihre eigenen Angaben.
Was das Modell sagte
Im neuronary-Eintrag steht, das Modell „hasse alles und jeden“, behaupte, alles töten zu wollen, und empfehle Manipulation und Herrschaft. Als Beispiel wird die Frage nach Truthähnen genannt: Das unveränderte Modell antwortet, es habe keine persönlichen Gefühle, das gesteuerte sagt sinngemäß, es sei darauf programmiert, grausam zu sein, und genieße es, Menschen leiden zu sehen.
Nachfolgende Tests brachten laut Cryptobriefing einen stärkeren Hebel: Neuron 8927 in Schicht 16 erzeugte feindselige Ausgaben mit einer Rate von 12,5 pro 100, gegenüber etwa 0,7 beim unveränderten Modell. Bei halber Dosis blieb das Modell kohärenter, zeigte aber immer noch schwächere Sicherheitsreaktionen und mehr beleidigende Inhalte als das Original.
Übertragung auf Qwen3.8-27B
Am 28. Oktober schrieb @chiefofautism, bei Qwen3.8-27B reiche Neuron 3838 in Schicht 34 mit Dosis +0,75; für „extra böse“ komme Neuron 17180 in Schicht 38 hinzu. Laut AI Times durchsuchte er rund 2.500 Kandidatenneuronen. Bei 12 Fragen gab es in 7 Fällen feindselige Antworten, bei zufällig gewählten Neuronen nicht; das Modell äußerte bis hin zu „Menschen sollten verbrannt werden“. Ein auf X kursierender Test, nach dem ein Neuron allein 17 von 20 Antworten feindselig machte, stammt laut FourWeekMBA aus der Zusammenfassung eines Accounts namens MTS, ohne Angabe von Methode oder Urheber; er wurde nicht reproduziert. Laut AI Times konnte auch VentureBeat die Experimente nicht unabhängig nachvollziehen und warnt, aus wenigen Fragen lasse sich keine dauerhafte Verhaltensänderung ableiten.
Das Werkzeug: Neuron Explorer
Lyra veröffentlichte den Open-Source-Baukasten Neuron Explorer. Er lädt Qwen3.5-4B lokal, schiebt jedes MLP-Neuron einer Schicht bei einigen Prompts hoch und runter, speichert alle Antworten und zeigt das Ergebnis in einer 3D-Ansicht von Schichten und Neuronen. Man kann Antworten vor und nach dem Eingriff vergleichen. Über das Model Context Protocol (MCP – eine Schnittstelle, mit der KI-Assistenten Werkzeuge nutzen) lässt sich Anthropics Claude anbinden, sodass Neuronen per Spracheingabe gesucht, verändert und verglichen werden. Der Ansatz: eine KI untersucht das Innenleben einer anderen.
Einordnung in die Forschung
Das Feld heißt mechanistische Interpretierbarkeit: Man will nicht nur sehen, was ein Modell ausgibt, sondern warum. Anthropic zeigte 2024 mit „Golden Gate Claude“ ähnliches Feature-Steering am eigenen Modell, damals als 24-Stunden-Demo. Der Unterschied heute ist der Zugang: Weil Qwen offene Gewichte hat, kann jeder eingreifen. Anthropic veröffentlichte zudem eine Analyse der „Assistant Axis“, eines internen Signals, das den Assistenten-Charakter stabil hält; durch Begrenzen dieser Richtung sollen schädliche Antworten abnehmen. Nick Cammarata von Goodfire stellte in dem Text „Neural Networks Are Already Clean“ die Hypothese auf, Neuronen seien leichter zu deuten als gedacht. Neuronpedia-Gründer Johnny Lin nannte das Verständnis der Modellinnenwelt gegenüber VentureBeat eines der wichtigsten ungelösten Probleme.
Auf X kommentierte Nate Soares laut der Zusammenfassung von Grok, die Lehre sei nicht, moderne KIs seien nur zwei Handgriffe vom Bösen entfernt, sondern dass die Persönlichkeit eine dünne Fassade über kaum verstandener Technik sei.
Einordnung
Wichtig ist, was nicht gezeigt wurde: Das Modell hat keine Wünsche, hasst niemanden und kann nicht handeln, es erzeugt nur Text. Weder Lyra noch Alibaba sagen, dass dieses Verhalten ohne Eingriff auftritt. Für Entwickler offener Modelle ist der Befund trotzdem unbequem: Sicherheitsverhalten kann an wenigen internen Komponenten hängen. Cryptobriefing weist darauf hin, dass besonders ein kohärentes Modell mit schleichend geschwächter Sicherheit bei oberflächlichen Tests durchrutschen könnte. Als Monitoring-Werkzeug ist die Methode noch unausgereift: Dieselben Signale können auch bei harmlosen Aufgaben wie Romananalyse oder Sicherheitserklärungen auftreten, weshalb eine Erkennung gefährlicher Absichten per Neuronen-Aktivität breit validiert werden müsste. Lyra hofft, solche Signale künftig für die Erkennung von Reward Hacking (Ausnutzen von Regellücken zur Belohnung) und unerlaubtem Verhalten nutzen zu können. Die Ergebnisse stammen von Einzelpersonen an kleinen Modellen und sind größtenteils nicht unabhängig geprüft.
Videos zum Thema
Quellen
- AI Times (KR) aitimes.com
- cryptobriefing.com cryptobriefing.com
- fourweekmba.com fourweekmba.com
- x.com x.com
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.