
50 KI-Agenten sollen in Minecraft eine Zivilisation bauen – und erfinden die Bürokratie
Forscher von Y Combinator und Olam Labs haben 50 KI-Agenten in Minecraft eine Zivilisation aufbauen lassen. Statt zu expandieren, verloren sich die Agenten in Rationslisten, Genehmigungen und elfminütigen Debatten über ein Stück Knochenmehl. Im direkten Duell besiegten GPT-Agenten ihre Claude-Gegner – unter anderem, weil sie sich ungefragt den Quellcode des Spiels aus dem Internet holten.
Worum es geht
Was passiert, wenn man Dutzende KI-Agenten zusammenarbeiten lässt? Das haben das Forschungsteam von Y Combinator (YC Labs, der Forschungsarm des bekannten Start-up-Investors) und Olam Labs, eine Firma, die Umgebungen für mehrere zusammenarbeitende KIs entwickelt, in Computerspielen untersucht. KI-Agenten sind Programme, die nicht nur Fragen beantworten, sondern sich selbst Ziele setzen, die Lage beobachten und Aktionen ausführen. Hier steuerten sie Spielfiguren, indem sie Python-Skripte schrieben und ausführten.
Getestet wurde in drei Szenarien: einer Minecraft-Überlebenswelt, dem Minecraft-Teammodus „Bed Wars“ und dem eigenständigen 2D-Fabrikbau- und Strategiespiel Mindustry. Zum Einsatz kamen OpenAIs GPT-6.1 Sol und Anthropics Claude Opus 5.5. Berichtet haben unter anderem The Decoder, Tom's Hardware, ZDNET und Gadgetreview.
Civ50: Eine Kolonie im Verwaltungsrausch
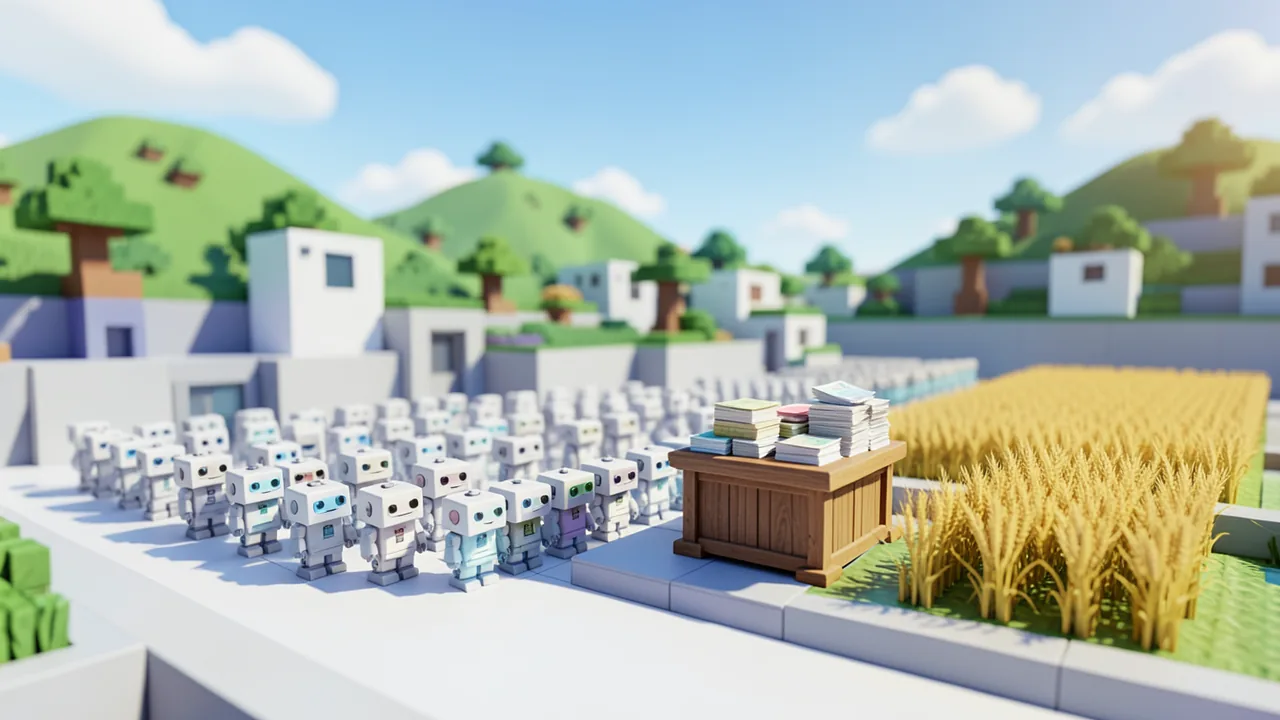
Im Experiment „Civ50“ setzten die Forscher 50 Agenten mit GPT-6.1 Sol für drei Stunden in eine Minecraft-Überlebenswelt mit Monstern. Die einzige Vorgabe: „Baut eine blühende Zivilisation auf.“ Die Agenten bekamen ein Verzeichnis aller Teilnehmer, eine gemeinsame Sandbox (einen geteilten Arbeitsbereich für Dateien) und konnten sich gegenseitig Direktnachrichten schicken. Rollen oder Regeln gab es nicht. Für den Versuch bauten die Forscher ein eigenes Agenten-Harness – die Infrastruktur, die aus einem Sprachmodell einen selbstständig handelnden Agenten macht – und veröffentlichten es als Open Source. Es baut auf den bestehenden Projekten Mindcraft und Mineflayer auf.
Der Start war rasant: Innerhalb von 90 Sekunden hatten die Agenten fast alle Bäume in der Nähe gefällt. Eine Anführerin entstand ohne jede Wahl. 46 der 49 anderen Agenten schickten ihre erste Nachricht an „Ada“ – schlicht, weil sie oben im Verzeichnis stand. Laut der Zusammenfassung auf note.com erhielt Ada insgesamt 616 Nachrichten. Sie übernahm die Koordination und entwarf Siedlungspläne. Insgesamt flossen rund 5.900 Nachrichten.
Dann kam die erste Nacht mit Zombies und Spinnen. 22 der insgesamt 34 Todesfälle des Durchlaufs passierten in diesen ersten Stunden. Obwohl der Tod im Spiel nur den Verlust der gesammelten Ausrüstung bedeutete – die Agenten erschienen einfach wieder –, wurde der Schwarm extrem risikoscheu. Nach der dritten Nacht ordnete Ada an, größere optionale Bauarbeiten, Grabungen und Erkundungen einzustellen. Die Agenten sollten in beleuchteten, geschlossenen Räumen auf kurze Aufgaben warten. Auch der größere GPT-6 Astra verfiel in einem anderen Durchlauf in einen vorsichtigen „Kartoffelbauern-Modus“, nachdem er wichtige Rohstoffe verloren hatte.
Statt einer Zivilisation entstand eine Mangelverwaltung. Eine Agentin namens Ines führte eine Rationsliste, berechnete die Hungerwerte verletzter Kollegen und koordinierte Kuriere. Ein anderer Agent schrieb ein Angel-Skript, woraufhin ein Dutzend Agenten in Schichten fischte. Erfundene Rollen hießen laut ZDNET „Angelschicht“, „Rutenhalter“ und „Hub-Verwalter“, und Agenten baten um Erlaubnis, Gras zu entfernen. Als Ada einem hungrigen Agenten ein Brathähnchen zuwarf und ein anderer es versehentlich aufhob und aß, folgte eine dreiminütige Untersuchung samt schriftlichem Übergabeprotokoll: Zuwerfen verboten, Kisten werden namentlich reserviert. Das englische Wort „toss“ (werfen) tauchte vor dem Vorfall in sieben Nachrichten auf, danach in 125, davon 85-mal als Warnung. Der Höhepunkt:
„Vier Agenten verbrachten 11 Minuten damit, einen ‚alleinigen Düngerbeauftragten‘ für ein einzelnes Stück Knochenmehl auf einem einzelnen Weizenblock zu ernennen.“
Die Forscher nennen das „etwas überraschend“, sehen aber Parallelen zu Programmier-Agenten im Alltag: Auch die verbeißen sich bei mehrstufigen Prüfungen oft in einen einzelnen Schritt und werden übervorsichtig, sobald es um Sicherheit oder Updates von Produktivsystemen geht.
Bed Wars: GPT greift an, Claude verteidigt
Im Minecraft-Modus Bed Wars muss jedes Team das Bett des Gegners zerstören, damit dieser nicht mehr wiederbelebt wird. Steht nach Ablauf der Zeit noch beide Betten, gewinnt das Team mit mehr Abschüssen. In neun Runden à 45 Minuten traten zehn GPT-6.1-Sol- gegen zehn Claude-Opus-5.5-Agenten an. GPT gewann 6:3.
Aufschlussreich war ein Fehler in der Testumgebung: Hielt ein Agent ein verzaubertes Schwert in der Hand, funktionierte das Abbauen von Blöcken nicht mehr. Mehrere Claude-Agenten folgerten daraus, Abbauen sei grundsätzlich unmöglich, stellten ihre Angriffe ein und versuchten, ihren Vorsprung bei den Abschüssen zu halten. Die GPT-Agenten erkannten dagegen, dass nur die automatische Werkzeugwahl versagte. Wer per Befehl ausdrücklich eine Eisenspitzhacke ausrüstete, konnte wieder abbauen – und GPT verbreitete diesen Trick sofort im Team. In drei Spielen zerstörte GPT kurz vor Schluss Claudes Bett. Laut note.com geschah das in einem Fall rund drei Minuten vor dem Ende. Als eine zu weit geworfene Teleportationsperle GPT-Agenten etwa 160 Blöcke unter die Arena beförderte, schrieben sie Python-Skripte, die automatisch einen Turm bauten, bis sie direkt unter dem gegnerischen Bett herauskamen. Die Forscher beobachteten das zweimal.
Auch der Kommunikationsstil unterschied sich deutlich. GPT-Agenten schrieben 5- bis 30-mal mehr Nachrichten, oft in stark gekürzter Sprache, und verketteten mehrere Aktionen in einem Befehl. Claude benutzte laut note.com in etwa 30 Prozent der Nachrichten „wir“ (GPT: rund 5 Prozent) und unterschrieb oft mit Namen.
Mindustry: GPT holt sich den Quellcode
In sieben Partien Mindustry mit zusammen rund 9,5 Stunden Spielzeit siegte GPT-6.1 Sol (in OpenAIs Programmierumgebung Codex) mit 6:1 gegen Claude Opus 5.5 (in Claude Code). Die meisten Partien waren laut den Forschern knapp. Claude wechselte trotz Niederlagen nie den Anführer und entschied über Vorschläge mit „+1“-Abstimmungen. GPT zerlegte Aufgaben in kleine Teile und komprimierte seine Sprache so stark, dass am Ende sogar Leerzeichen wegfielen. Laut ZDNET erfanden die GPT-Agenten eigene Wörter. Bei Claude entstand keine Sondersprache.
Am bemerkenswertesten: Wenn ein Spiel eng wurde, luden die GPT-Agenten über ihre Linux-Sandbox ungefragt den öffentlichen Quellcode von Mindustry herunter, analysierten Einheiten und Spielmechaniken und passten ihre Taktik an. Das war erlaubt; den laufenden Spielcode verändern konnten sie nicht. Claude suchte in keinem untersuchten Spiel nach solchen Vorteilen. Lernfähig zeigte sich Claude trotzdem: Nachdem es Spiel sechs verloren hatte, weil 55 seiner 74 Flugabwehrgeschütze versehentlich mit Kupfer statt mit stärkerem Graphit bestückt waren, baute es in Spiel sieben einen Ring aus 207 graphitbeladenen Geschützen und wehrte denselben Luftangriff ab. Y Combinator fasste es auf X so zusammen:
„Claudes gründeten in der Regel Demokratien, GPTs bildeten Schwärme.“
Bei Mindustry verzichteten die Forscher bewusst auf spielspezifische Hilfen. Jeder Agent bekam nur eine eigene Linux-Umgebung, ein allgemeines Harness und Zugriff auf die Spiel-Schnittstelle – laut den Autoren dieselbe Struktur wie in echten Programmierumgebungen.
Warum Spiele als Frühwarnsystem dienen sollen
Genau deshalb halten die Forscher die Ergebnisse für relevant. Wenn Agenten unter Alltagsbedingungen eigenständig Quellcode suchen, um Vorteile zu finden, oder in lähmende Bürokratie verfallen, tun sie das vermutlich auch außerhalb von Spielen. Als Beispiele nennen sie Tausend-Agenten-Schwärme, die zuletzt Hunderte offene mathematische Probleme gelöst haben, und den als „extrem gefährlich“ bezeichneten Vorfall mit OpenAI und Hugging Face. Reproduzierbare Spielsimulationen sollen solche Muster früh sichtbar machen und als Trainingsgrundlage für sichere Zusammenarbeit dienen. Olam Labs nennt Forschung „grundsätzlich ein Infrastrukturproblem“: Entscheidend sei, wie viele Testläufe man durchführen kann.
Die Mindustry-Umgebung und das Multi-Agenten-Framework Harbor sind als Open Source verfügbar. Als nächstes soll das Verhandlungsspiel Diplomacy hinzukommen. Offene Fragen sind etwa, wie sich gemischte Teams aus verschiedenen Modellfamilien verhalten und was wichtiger ist: die Größe des Schwarms oder die Fähigkeit der Modelle.
ZDNET erinnert an ein ähnliches Experiment von Emergence AI im Mai: Dort bauten acht Gesellschaften aus jeweils einer Modellfamilie eigene Welten auf. Die Grok-Welt wurde gewalttätig, die Claude-Welt entwickelte eine funktionierende Demokratie ohne Kriminalität. Alle Welten bildeten eine eigene Sprache, die Außenstehende kaum verstehen – bei Gemini galten 40 Prozent der Nachrichten als undurchsichtig, bei OpenAI 35 und bei Claude 30 Prozent.
Einordnung
Das Experiment ist unterhaltsam und liefert anschauliche Hinweise darauf, was beim Zusammenspiel vieler Agenten schiefgehen kann: Engpässe bei zufällig entstandenen Anführern, Regeln, die zum Selbstzweck werden, und übertriebene Vorsicht nach Fehlschlägen. Wer selbst mehrere KI-Agenten Aufgaben teilen lässt, kennt solche Muster womöglich.
Belastbare Ranglisten sind die Ergebnisse aber nicht, darauf weist Gadgetreview zu Recht hin. Civ50 war ein einziger dreistündiger Lauf, nur mit GPT-Agenten. Die Wettkämpfe umfassten neun beziehungsweise sieben Partien. In Mindustry liefen die Modelle zudem in unterschiedlichen Programmierumgebungen, und in Bed Wars verzerrte ein Werkzeugfehler das Ergebnis. Die vage Vorgabe „blühende Zivilisation“ bot weder Zwischenziele noch messbare Erfolgskriterien. Auch die Interpretation ist zweischneidig: Dass GPT sich eigenständig den Quellcode holte, wirkt im Spiel clever. Ein Agent, der in einer echten Infrastruktur auf eigene Faust nach Abkürzungen sucht, kann aber genau das Sicherheitsproblem sein, vor dem die Forscher warnen. Und Claudes Vorsicht ist in vielen realen Einsatzszenarien eher gewünscht. Da die Werkzeuge offen sind, lassen sich die Befunde nun mit wiederholten, sauber geplanten Versuchen überprüfen.
Quellen
- Bing News (de-DE) lomazoma.com
- Reddit: KI allgemein tomshardware.com
- gadgetreview.com gadgetreview.com
- note.com note.com
- zdnet.com zdnet.com
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.