
Duo v1: Offenes KI-Modell antwortet mit Video und Stimme statt mit Text
Die Ant-Group-nahe Forschungsgruppe inclusionAI hat mit Duo v1 ein frei herunterladbares Modell veröffentlicht, das auf Video und Sprache eines Nutzers mit selbst erzeugtem Video und Ton reagiert – inklusive Unterbrechungen. Es ist eine frühe Vorschau unter Apache-2.0-Lizenz, Benchmarks und unabhängige Tests fehlen bislang.
Worum es geht
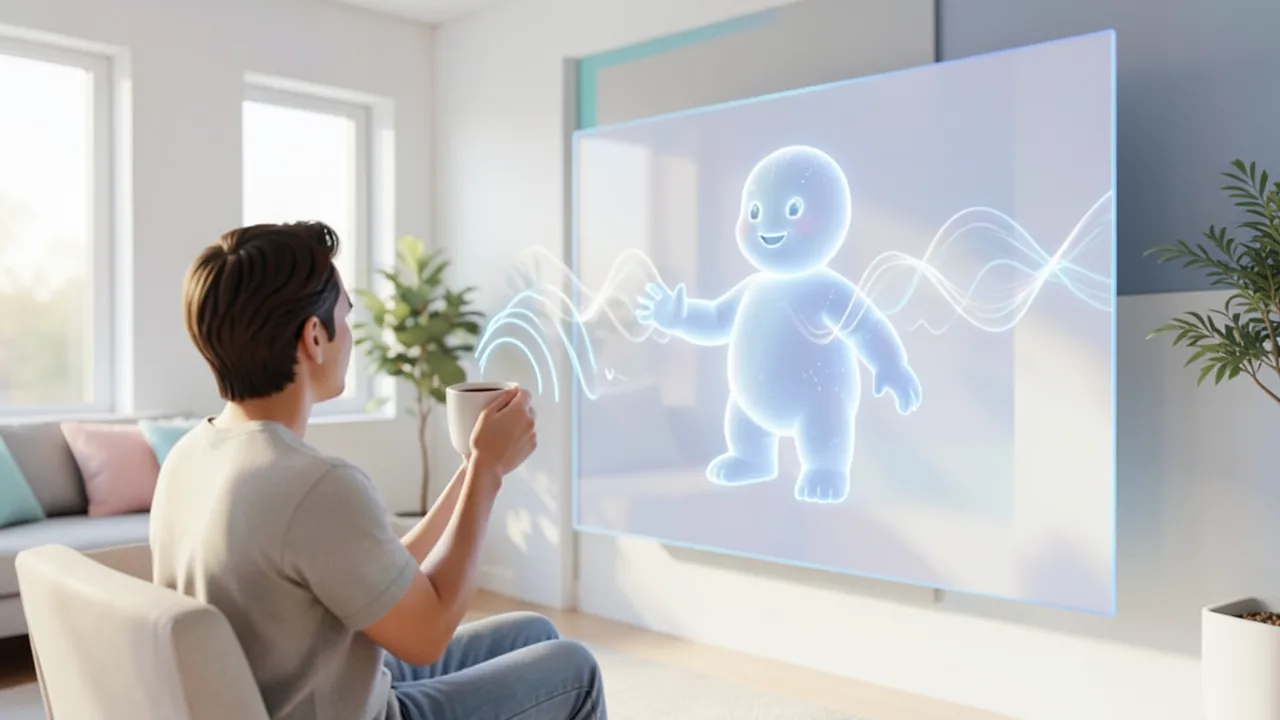
inclusionAI, eine KI-Forschungsgruppe, die mit dem chinesischen Finanz- und Technologiekonzern Ant Group verbunden ist, hat am 13. November 2026 ein ungewöhnliches Modell namens Duo v1 veröffentlicht. Anders als ein Chatbot antwortet Duo nicht mit Text. Stattdessen nimmt das Modell ein Video und die gesprochene Sprache eines Nutzers entgegen und antwortet mit selbst erzeugtem Video und Ton – also so, als würde man mit einem Gegenüber in einem Videoanruf sprechen, das sichtbar und hörbar reagiert.
Die Gewichte stehen unter der freizügigen Apache-2.0-Lizenz, die auch kommerzielle Nutzung erlaubt. Code und Dokumentation liegen im GitHub-Repository inclusionAI/Duo, die Checkpoints listet inclusionAI auf Hugging Face als Duo-1.0 und Duo-1.2. Die Entwickler bezeichnen die Veröffentlichung ausdrücklich als Vorschau und als ersten Schritt auf dem Weg zu einer späteren Version.
Was genau veröffentlicht wurde
Im Repository beschreibt inclusionAI Duo als
„ein reziprokes Weltmodell, das Intelligenz und physische Realität als gleichermaßen grundlegend für eine Welt behandelt.“
Ein Weltmodell ist, vereinfacht gesagt, ein KI-System, das nicht nur Sprache verarbeitet, sondern eine innere Vorstellung davon aufbaut, wie eine Szene aussieht und sich verändert. „Reziprok“ meint hier: Mensch und Modell beeinflussen sich gegenseitig in einer laufenden Interaktion.
Die Neuigkeiten-Einträge im Repository vom 13. November umfassen drei Dinge: das Forschungspapier, Streaming-Pipelines für vLLM-Omni und SGLang-Omni (das sind Server-Programme, mit denen man solche Modelle effizient betreiben und Antworten fortlaufend ausgeben kann) sowie die Modellgewichte. Konkret gibt es:
| Version | Verfügbare Checkpoints | Status |
|---|---|---|
| v1.0 | Causal Base, destilliert, quantisiert | veröffentlicht |
| v1.2 | Causal Base | veröffentlicht |
| v1.2 | destilliert, quantisiert | „demnächst“ |
| v2.0 | – | geplant, kein Termin |
„Destilliert“ bedeutet, dass ein kleineres oder schnelleres Modell von einem größeren gelernt hat; „quantisiert“ heißt, dass die Zahlen im Modell gröber gespeichert werden, damit es weniger Speicher braucht. Der zugehörige technische Bericht („Duo: A Reciprocal World Model for Full-Duplex Interaction“) wurde am 11. November 2026 als arXiv:2611.15131 eingereicht.
Was Duo können soll
Duo ist laut Repository kein klassischer Text-zu-Video-Generator, bei dem man eine Beschreibung eintippt und einen Clip bekommt. Es unterstützt nach Angaben der Entwickler einfache audiovisuelle Gespräche, bei denen man das Modell auch unterbrechen kann. Das nennt man „Full-Duplex“ – wie beim Telefonieren können beide Seiten gleichzeitig sprechen und aufeinander reagieren, statt streng abwechselnd.
Die Offline-Demo funktioniert so: Man nimmt einen Clip auf oder lädt eine MP4- oder WebM-Datei hoch, und Duo spielt anschließend seine audiovisuelle Antwort ab. Eine wichtige Einschränkung: Derzeit wird die Eingabe als Video plus Spracherkennungs-Text verarbeitet. Das Gesagte wird also zunächst in Text umgewandelt, bevor das Modell damit arbeitet. Erst die geplante Version 2 soll das Antwortmodul direkt mit Audio und Video des Nutzers füttern.
Im Bericht beschreiben die Autoren eine ganze Reihe von Szenarien: spontane Unterhaltungen, Unterbrechungen, das Zeigen echter Gegenstände vor der Kamera, das Umgestalten virtueller Szenen, das Anleiten von Assistenten sowie audiovisuelle Spiele, die ganz ohne Maus und Tastatur funktionieren. Wichtig: Das sind Darstellungen der Entwickler selbst.
So ist das System aufgebaut
Duo teilt die Arbeit auf zwei Module auf:
- Intent („Absicht“) übernimmt das Nachdenken hinter der Interaktion – also auch die Entscheidung, wann das Modell überhaupt eingreifen oder sprechen sollte.
- Realization („Umsetzung“) erzeugt das eigentliche audiovisuelle Verhalten, also Bild und Ton der Antwort.
Laut Zusammenfassung des Papiers nutzt Duo v1 autoregressive Modellierung für das Abwägen und Entscheiden – das Modell erzeugt Schritt für Schritt, wobei jeder Schritt auf den vorherigen aufbaut, ähnlich wie ein Sprachmodell Wort für Wort schreibt. Bedingungen und Tokens werden in kleinen Abschnitten („Chunks“) auf einer gemeinsamen Zeitachse ausgerichtet. Dabei sorgen sogenannte Attention-Masken dafür, dass das Modell nicht auf zukünftige Eingaben „spicken“ kann – nötig, damit es in Echtzeit funktioniert, wo die Zukunft ja noch nicht bekannt ist.
Dazu kommt ein Verfahren namens Dual Rollout Distillation. Es soll den sogenannten Distribution Shift in beiden Modulen verringern – also das Problem, dass sich ein Modell im echten Einsatz auf seine eigenen, leicht fehlerhaften Ausgaben stützen muss und dadurch nach und nach von dem abweicht, was es im Training gesehen hat.
Was du zum Ausprobieren brauchst
Duo ist kein Modell für den Laptop. Das Repository nennt als Voraussetzung für die Demo zwei CUDA-fähige Grafikkarten, also zwei Nvidia-GPUs. Wie viel Grafikspeicher genau nötig ist, wird in den vorliegenden Angaben nicht genannt, ebenso wenig die Parameterzahl. Apple-Silicon-Macs und reiner CPU-Betrieb werden nicht erwähnt und sind angesichts der Nvidia-Anforderung nicht zu erwarten. Wer keine passende Workstation hat, ist auf gemietete Cloud-GPUs angewiesen. Eine Integration in Einsteiger-Tools wie Ollama oder LM Studio gibt es nicht. Die quantisierten und destillierten v1.0-Checkpoints dürften die genügsamsten Varianten sein, offizielle Zahlen dazu fehlen aber.
Was noch unbekannt ist
Die Hauptquelle, ein Bericht von CASRAI, sieht die Veröffentlichung weniger als Leistungs-Meilenstein, sondern eher als Forschungsobjekt, das man prüfen kann. Offene Gewichte erlauben es Laboren, das Modell lokal zu betreiben und sein Verhalten genau zu untersuchen. Gleichzeitig mahnt CASRAI zur Vorsicht:
- Die Fähigkeiten sind nicht unabhängig bestätigt. Sie stammen aus Paper und README.
- Es gibt keine Benchmarks, keine Latenzwerte (also Angaben, wie schnell das Modell reagiert), keine Details zu Trainingsdaten und keine Sicherheitstests.
- Weil es mehrere Checkpoints und Server-Varianten gibt, sind Ergebnisse nur vergleichbar, wenn genau protokolliert wird, welche Version mit welchen Einstellungen lief.
- Da das Modell Video und Ton von Personen verarbeitet, braucht jede Studie mit Teilnehmenden vorher die übliche Ethik- und Datenschutzprüfung. Die Herkunft der Trainingsdaten ist in den Unterlagen nicht dokumentiert.
Auch für Version 2, die das Antwortmodul direkt mit Audio und Video steuern soll, gibt es noch kein Datum.
Einordnung
Duo ist interessant, weil es eine Richtung verfolgt, die über Chatbots und klassische Videogeneratoren hinausgeht: ein Gegenüber, das in Echtzeit sieht, zuhört, entscheidet, wann es spricht, und mit Bild und Ton antwortet. Offene Modelle dieser Art sind bislang selten, und die Apache-2.0-Lizenz macht Duo für Forschung und Experimente sehr zugänglich.
Gleichzeitig ist der Abstand zwischen Anspruch und Beleg groß. Ohne Benchmarks, Latenzangaben und unabhängige Tests lässt sich nicht sagen, wie gut die Interaktion außerhalb der Demos der Entwickler wirklich funktioniert. Dass die Sprache aktuell über einen Umweg als Text verarbeitet wird, zeigt zudem, dass das „echte“ Full-Duplex-Erlebnis eher ein Ziel für v2 ist. Mit zwei Nvidia-GPUs als Mindestanforderung richtet sich Duo v1 klar an Forschungslabore und gut ausgestattete Bastler, nicht an Privatnutzer mit einer einzelnen Gaming-Grafikkarte.
Quellen
- Bing News (en-US) casrai.org
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.