
KI soll ein neuronales Netz entwerfen – und verzichtet auf den Transformer
Forscher der POSTECH haben drei aktuelle Spitzenmodelle ein neuronales Netz ganz frei entwerfen lassen. Alle drei bauten statt eines Transformers unabhängig voneinander dünn besetzte Nachschlagetabellen. Das beste Ergebnis schlägt einen gleich großen Transformer deutlich, liegt aber weit hinter vortrainierten Kleinmodellen.
Worum es geht
Was passiert, wenn man einer KI völlig freie Hand lässt, selbst ein neuronales Netz zu entwerfen? Dieser Frage sind die Forscher Hyunjong Ok und Jaeho Lee von der südkoreanischen Universität POSTECH nachgegangen. Ihr Paper erschien am 18. November 2026, Bekanntheit bekam es durch einen Beitrag im Reddit-Forum r/artificial. Ihre Versuchsobjekte waren drei aktuelle Spitzenmodelle: Claude Opus 5.5 von Anthropic sowie GPT-6.1 Sol und GPT-6 Astra von OpenAI.
Alle drei bekamen dasselbe: zehn beschriftete Beispielfragen, eine Code-Sandbox (eine abgeschottete Umgebung, in der sie Programme schreiben und ausführen konnten) und die Anweisung, eine beliebige Architektur zu entwerfen. Einen Haken gab es: Gradientenabstieg kam im Prozess nicht vor. Das ist das übliche Trainingsverfahren, bei dem ein Netz seine Werte in Millionen kleiner Schritte so lange anpasst, bis die Fehler kleiner werden. Die Sprachmodelle mussten die Werte also gewissermaßen von Hand festlegen.
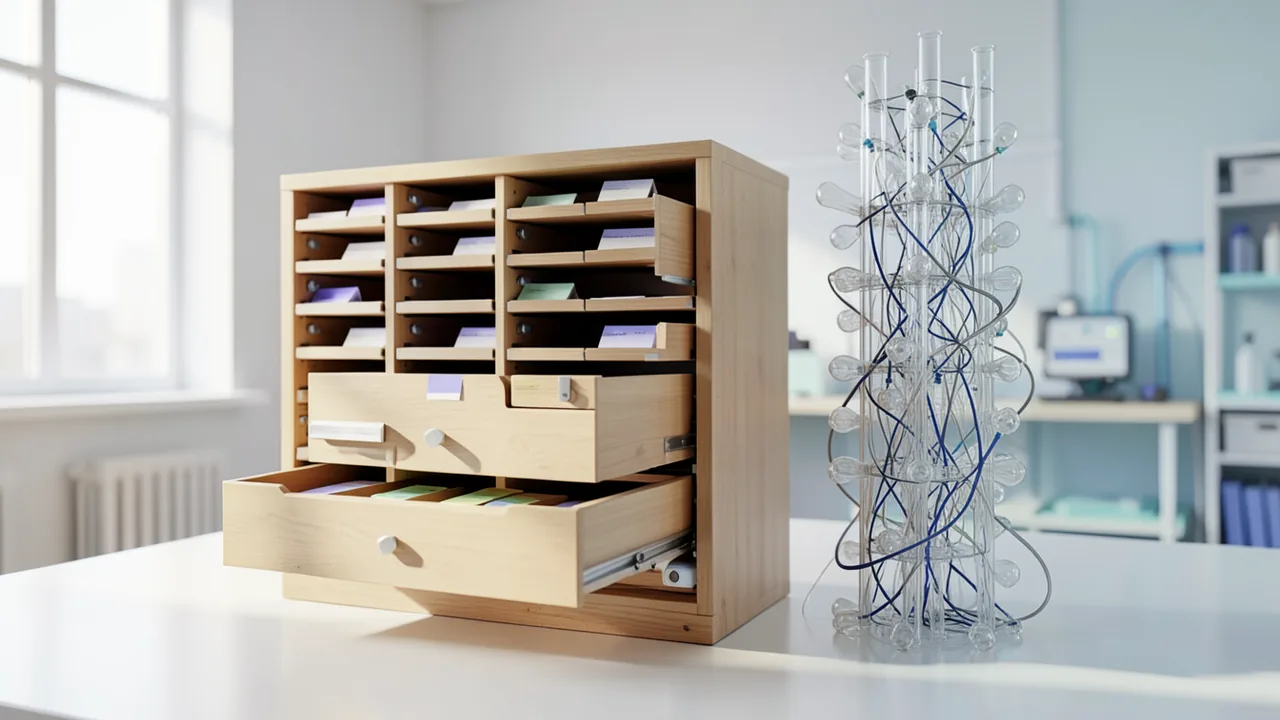
Das Ergebnis überrascht. Keines der drei Modelle baute einen Transformer, also die Architektur, auf der heute praktisch alle großen Sprachmodelle beruhen, sie selbst eingeschlossen. Stattdessen kamen alle drei unabhängig voneinander auf dieselbe Idee: Sie wandelten Fakten aus normalem Text in dünn besetzte Nachschlagetabellen um (englisch „sparse lookup tables“). Diese werden dann nach einem festen Verfahren abgefragt.
Wie die Tabellen-Netze funktionieren
Man kann sich so ein System wie einen sehr großen Karteikasten vorstellen. Jede Zeile der Tabelle enthält einen Fakt. „Dünn besetzt“ heißt, dass die meisten Einträge leer sind oder null betragen und bei einer Anfrage nur wenige Zeilen eine Rolle spielen. Kommt eine Frage herein, sucht ein festes, vorher festgelegtes Verfahren die passenden Einträge heraus und leitet daraus die Antwort ab. Ein Transformer verteilt sein Wissen dagegen auf Milliarden von Zahlen, die sich keinem einzelnen Fakt mehr zuordnen lassen.
Daraus ergibt sich ein Vorteil, den die Autoren hervorheben: Jede Vorhersage lässt sich auf genau eine Faktenzeile zurückführen, und diese Zeile kann man bearbeiten. Gibt das Modell eine falsche Antwort, sieht man also, welcher Eintrag dafür verantwortlich ist, und kann ihn korrigieren. Bei gewöhnlichen Sprachmodellen ist so etwas bislang ein eigenes, schwieriges Forschungsgebiet.
Die Zahlen
Am besten schnitt der Entwurf von Claude Opus 5.5 ab. Als Vergleich diente ein Transformer mit derselben Größe, der auf klassischem Weg mit Gradientenabstieg trainiert wurde.
| Modell | Parameter | ARC-Testgenauigkeit |
|---|---|---|
| Tabellenmodell (Entwurf von Claude Opus 5.5) | 3,35 Mio. | 54,4 % |
| Zwei-Schichten-Transformer, per Gradientenabstieg trainiert | ca. 3,35 Mio. | 29,8 % |
| Qwen3.5-0.8B (vortrainiertes Sprachmodell) | 0,8 Mrd. | 82,1 % |
Welche Variante des ARC-Benchmarks genau gemeint ist, lässt der Reddit-Beitrag offen. Die genannten Werte, darunter die 82 Prozent eines kleinen Sprachmodells, sprechen eher für den AI2 Reasoning Challenge. Das ist ein Multiple-Choice-Test mit naturwissenschaftlichen Fragen und nicht das bekannte Puzzle-Benchmark ARC-AGI. Ganz sicher ist das aber nicht.
Dem Paper zufolge schlägt das Tabellenmodell auch den genauesten Transformer, den eines der Sprachmodelle geschrieben hat, und zwar mit rund 1.800-mal weniger Parametern. Rechnet man nach, müsste dieser Transformer etwa sechs Milliarden Parameter gehabt haben. Das ist allerdings nur eine Hochrechnung aus den genannten Zahlen. Außerdem soll das Tabellenmodell auf einer Grafikkarte bis zu 17-mal schneller laufen.
Die großen Einschränkungen
Schon der Reddit-Beitrag weist ausdrücklich auf die Grenzen hin, und sie sind erheblich:
- Enges Einsatzgebiet: Im breiteren Wissenstest MMLU, der Fragen aus Dutzenden Fachgebieten stellt, liegt das Modell bei etwa 25 Prozent. Bei vier Antwortmöglichkeiten ist das reines Raten.
- Weit hinter vortrainierten Modellen: Das kleine Sprachmodell Qwen3.5-0.8B kommt im selben ARC-Test auf 82,1 Prozent. Das Tabellenmodell erreicht nur etwa zwei Drittel davon.
- Der Vergleich ist günstig gewählt: Ein winziger Transformer mit zwei Schichten und ohne großes Vortraining ist ein schwacher Gegner. Dass ihn ein Fakten-Nachschlagesystem bei Wissensfragen schlägt, ist weniger erstaunlich, als die Schlagzeile vermuten lässt.
Der Code ist nach Angaben der Autoren auf GitHub veröffentlicht. Eine genaue Adresse nennt der Beitrag nicht. Eine ausführlichere Zusammenfassung gibt es bei emergent.sh.
Die Grundsatzfrage
Die Reddit-Diskussion dreht sich um eine Frage, die über das Experiment hinausgeht. Vielleicht ist der Transformer vor allem deshalb Standard, weil er sich gut mit Gradientenabstieg trainieren lässt. Er rechnet hochgradig parallel und lässt sich gut skalieren, also mit mehr Rechenleistung und Daten weiter verbessern. Wenn Sprachmodelle die Werte von Hand schreiben dürfen und diese Architektur dann gar nicht nutzen wollen, deutet das darauf hin, dass die Wahl der Architektur stark vom Trainingsverfahren abhängt und nicht nur von der Aufgabe.
Man muss diese Deutung nicht übernehmen. Für ein Sprachmodell, das Netze von Hand bauen soll, ist eine Faktentabelle auch einfach die naheliegende Lösung. Sie lässt sich direkt aus Text erzeugen, braucht kein Training und ist leicht zu prüfen. Dass drei Modelle von zwei Herstellern unabhängig auf dieselbe Lösung kamen, ist trotzdem bemerkenswert.
Einordnung
Die Studie ist kein Hinweis darauf, dass Transformer bald überholt sind. Bei allgemeinem Wissen und Sprachverständnis sind die Tabellenmodelle weit unterlegen. Interessant ist sie aus zwei anderen Gründen. Erstens zeigt sie, dass Sprachmodelle ohne menschliche Vorgaben funktionierende Lernsysteme entwerfen können, die auf bestimmten Aufgaben sehr klein und schnell sind. Zweitens hat das Ergebnis einen praktischen Vorteil: Jede Antwort lässt sich auf einen Fakt zurückführen und korrigieren. Das ist für Anwendungen interessant, bei denen Nachvollziehbarkeit wichtiger ist als Breite, etwa bei geprüftem Fachwissen.
Offen bleibt einiges. Wie stark hängt das Ergebnis von den zehn Beispielfragen und der Formulierung der Aufgabe ab? Wie gut lässt sich der Ansatz über den ARC-Test hinaus übertragen? Und ist ein Faktenspeicher, der fest abgefragt wird, überhaupt ein neuronales Netz im üblichen Sinn oder eher eine gut gebaute Datenbank? Die Ergebnisse stammen bisher allein aus dem Paper der Autoren. Unabhängige Nachprüfungen gibt es noch nicht, der veröffentlichte Code macht sie aber möglich.
Quellen
- Reddit r/artificial reddit.com
- siliconangle.com siliconangle.com
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.