
Meow AI Arena: KI-Modelle bauen Brücken, und die Community baut sie billiger
Ein kleiner Bilibili-Kanal lässt GPT-6.2 Sol, Opus 5.5, Hy4 und andere Spitzenmodelle in Spielen gegeneinander antreten und stellt alles zum Nachrechnen auf GitHub. Wir haben die Rohdaten der Brückenbau-Folge ausgewertet. Die meisten Nullrunden entstanden durch Brücken, die nicht bestanden haben, und nicht durch Budgetfehler. Auf der offenen Bestenliste liegen Einsendungen der Community um bis zu 64 Prozent unter den Modellen.
Darum geht es
Ranglisten für KI-Modelle bestehen meist aus einer einzigen Zahl. Der chinesische Bilibili-Kanal „喵了个猫了个咪了个猫“ (etwa „Miau-Katze-Mietz-Katze“) zeigt seit Anfang Oktober in einer Videoreihe, wie es konkreter geht. Aktuelle Spitzenmodelle bekommen mit ihren Coding-Agenten dieselbe Aufgabe. Ein Coding-Agent ist ein KI-Assistent, der selbstständig Code schreibt, ausführt und testet, etwa Claude Code oder Codex. Danach treten die Ergebnisse in Spielen gegeneinander an: Bomberman, Diplomacy, Panzerschlacht, Fußball und zuletzt Brückenbau.
Das Material liegt unter MIT-Lizenz im Repository github.com/chen-006/meow-ai-arena: Aufgaben, Schiedsrichter, der unveränderte Code jedes Modells und die Auswertung. Die Brückenbau-Folge erschien am 8. November. Laut den Verbraucherportal-Berichten von smzdm hatte sie am 10. November mehr als 800.000 Aufrufe, und das bei einem Kanal mit rund 38.000 Followern. Das Repository hat 285 Sterne. In englischsprachigen Medien, auf Reddit und auf Hacker News haben wir keine Erwähnung gefunden.
Wir haben die Rohdaten der Folgen gelesen und die Brückenbau-Zahlen nachgerechnet. Unsere Ausgangsthese hat sich dabei nur zum Teil bestätigt.
Neun Folgen, wechselnde Sieger, aber ein Dauergast an der Spitze
| Folge | Spiel | Sieger laut Repository | Was man wissen muss |
|---|---|---|---|
| 1 | Gebietsgewinn | Sonnet 5.5 | 30.000 Partien |
| 2 | Bomberman | GPT-6 Astra | 488,6 Punkte vor Opus 5.5 mit 321,8 |
| 3 | Capture the Flag | GPT-6 Astra / GPT-6.1 Sol | geteilter Sieg |
| 4 | Diplomacy | Fable 5.1 | nur drei Partien, einziger Alleinsieg in Partie 3 |
| 5 | Lagerlogistik im Team | MiMo V2.6 Pro + GPT-6 Astra | zufällig gebildete Zweierteams |
| 6 | Panzerschlacht | GPT-6 Astra | 1.556 Siege bei 240 Niederlagen im Finale |
| 7a | Tron (Lichtrad) | Mistral Large 4 | Hauptfeld ohne Spitzenmodelle aus den USA |
| 7b | Code beschleunigen | Step 5 preview / Hy4 preview | 139,4- bzw. 138,2-mal schneller |
| 8 | 2-gegen-2-Fußball | GPT-6 Astra + GPT-6.1 Terra | Team 440:0:0 Siege |
| 9 | Brückenbau | GPT-6.2 Sol | 102,67 Punkte |
Die Sieger wechseln tatsächlich. Hinter einigen Siegen steckt aber vor allem die Zusammensetzung des Teilnehmerfelds. Im Tron-Hauptfeld traten zehn Modelle an, überwiegend aus China, dazu Mistral. GPT-6 Astra lief nur als Referenz mit. In der Sonderrangliste kam Astras Bot auf 313 Punkte, Mistral auf 120. Bei der Code-Optimierung siegte Step 5 mit dem Faktor 139,4. Das nicht gewertete Referenzmodell Sonnet 5.5 erreichte 169,7. In Diplomacy hing viel an der Startposition: In den ersten beiden Partien holte jeweils das Land Großbritannien die meisten Punkte. Fable 5.1 sicherte sich mit Italien den einzigen Alleinsieg und kam so auf 161,37 Punkte. Opus 5.5 folgte mit 55,30. Dazu kommt, dass die Regeln zwischen den Partien geändert wurden.
Unsere Einschätzung: Wenn es darum geht, Spiel-Bots zu programmieren, liegt GPT-6 Astra in den meisten Folgen vorn. Echte Wechsel an der Spitze gibt es vor allem dort, wo die Spielart sich grundlegend ändert, etwa bei Verhandlungen (Diplomacy) oder Physik (Brückenbau).
Die Brückenbau-Folge: so lief der Wettbewerb
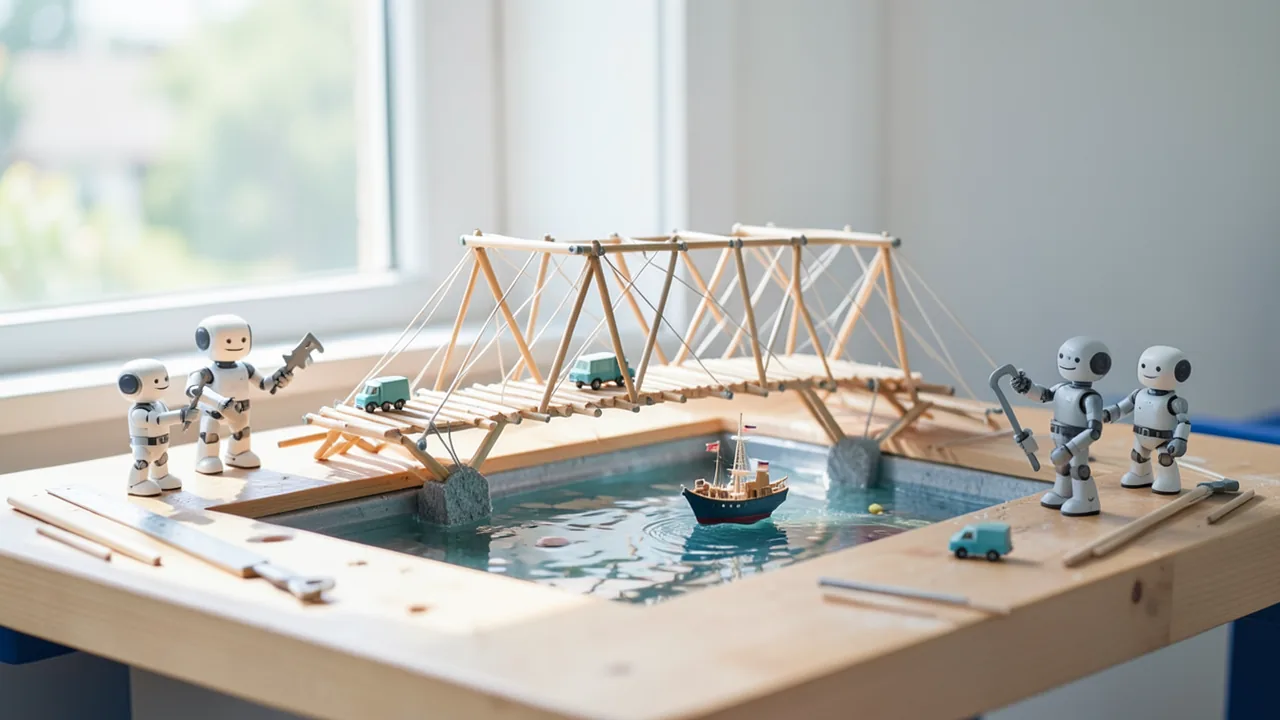
Am 7. November bekamen neun Modelle dasselbe Starterpaket. Sie hatten 90 Minuten Zeit, und alle sieben Level wurden gleichzeitig freigegeben. Die Zeit mussten die Agenten selbst einteilen. Gebaut wird ein 2D-Stabwerk aus Holz, Stahl, Seilen, Federn und Hydraulik, also eine Konstruktion aus Knoten und Stäben wie bei einem Fachwerkkran. Lange Druckstäbe werden durch Knicken schwächer. Die Physik berechnet eine deterministische XPBD-Simulation: Dieselbe Brücke führt immer zum exakt selben Ergebnis. Der lokale Simulator ist laut Veranstalter dasselbe Programm wie der Schiedsrichter, und es gibt keine versteckten Testszenarien.
Gewertet wird nur, wenn alle Fahrzeuge pünktlich und unbeschädigt ankommen. Dann gibt es 100 × Referenzkosten ÷ eigene Kosten. Wer billiger baut als die Referenzlösung des Veranstalters, bekommt mehr als 100 Punkte. In Level 7 baut jedes Modell eine Brücke und ein „Störfahrzeug“, das die Brücken der anderen zum Einsturz bringen soll. Das ergibt 72 Duelle. Die Gesamtnote ist der Mittelwert aller sieben Level. Für GPT-6.2 Sol haben wir nachgerechnet: Die Level 1–6 ergeben zusammen 637,42 Punkte, dazu kommen 81,25 aus Level 7. Geteilt durch 7 ergibt das 102,67. Die Angabe stimmt.
| Modell | Werkzeug | Gesamt | Level 4 | Level 5 | Level 6 | Level 7: gehalten / geknackt |
|---|---|---|---|---|---|---|
| GPT-6.2 Sol | Codex-Desktop | 102,67 | 105,38 | 95,31 | 97,07 | 8/8 / 5 |
| Claude Opus 5.5 | Claude Code | 79,02 | 70,19 | 0 (Budget: 13.472 von 10.000) | 91,64 | 8/8 / 4 |
| GPT-6 Astra | Codex CLI | 73,48 | 65,94 | 0 (Budget: 10.199 von 10.000) | 84,90 | 8/8 / 6 |
| Gemini 4 Argon | OpenCode | 45,31 | 0 | 0 | 0 | 7/8 / 3 |
| Grok 4.7 | Grok Build | 35,62 | 0 | nicht abgegeben | nicht abgegeben | 4/8 / 0 |
| Kimi K3.1 Pro | Kimi Code | 32,47 | 0 | 0 | 0 | 5/8 / 0 |
| Tencent Hy4 | OpenCode (OpenRouter) | 31,45 | 0 | 0 | 0 (Budget: 34.497 von 20.000) | 6/8 / 0 |
| Doubao Seed Evolving | OpenCode | 30,96 | 0 | 0 | 0 | 4/8 / 0 |
| DeepSeek V4.1 Flash | dsh | 27,93 | 0 | 0 | 0 | 4/8 / 0 |
Die Level 1–3 bestanden alle neun Modelle. Ab Level 4 kamen Schiffsdurchfahrt, knappere Budgets und Gegenverkehr dazu, und nur noch die drei Erstplatzierten kamen durch. Sols größter Vorsprung entstand in Level 2: Seine Brücke kostete 7.702 statt der 10.617 der Referenz und brachte 137,85 Punkte.
Unsere Nachrechnung: Woran die Modelle wirklich scheiterten
Die smzdm-Auswertung kommt zu dem Schluss, dass nicht die Programmierkunst über die Platzierung entschied, sondern „Selbstprüfung, Zeitplanung und Budgetdisziplin“. Wir hatten vermutet, dass die meisten Nullrunden deshalb auf überzogene Budgets zurückgehen. Die Rohdaten in scores.json widerlegen das. Von 54 Abgaben in den Leveln 1–6 endeten 20 mit null Punkten:
- 15-mal hat die Brücke ihre Szenarien nicht bestanden. Die Kosten lagen dabei innerhalb des Budgets, aber die Fahrzeuge kamen nicht pünktlich und unbeschädigt an.
- 3-mal wurde das Budget überschritten: von Opus und Astra in Level 5 und von Hy4 in Level 6.
- 2-mal gab es keine Abgabe: Grok 4.7 lieferte Level 5 und 6 nicht ab.
Die These stimmt nur für die Spitzengruppe. Opus und Astra haben ausschließlich durch überzogene Budgets Punkte verloren. Bei Astra ist das besonders knapp: Es fehlten 199 Einheiten, gut 2 Prozent. Eine einfache Rechnung zeigt, wie viel daran hing. Angenommen, Astra hätte eine bestehende Brücke genau zum Budget von 10.000 abgegeben: Das hätte 82,16 Punkte gebracht. Die Gesamtnote wäre um rund 11,7 auf etwa 85,2 gestiegen, und Astra läge vor Opus. Dieses Szenario ist hypothetisch.
Bei den unteren sechs scheiterte es dagegen an der Physik. Einige Brücken waren sogar zu billig gebaut. Hy4 und DeepSeek blieben in Level 5 mit 5.651 und 5.584 rund 31 Prozent unter der Referenz von 8.216 und bestanden nicht. Kimi baute Level 6 für 11.741 statt 16.709 und scheiterte laut smzdm an den Lkw-Szenarien. Unsere Einschätzung: Diese Modelle hätten mit dem mitgelieferten bridge.py run lokal sehen können, dass ihre Entwürfe durchfallen. Hier hat die Selbstprüfung tatsächlich versagt, aber anders als angenommen. Es fehlte am Testen vor der Abgabe, nicht am Blick aufs Budget.
Auch das Duell in Level 7 bestätigt die gängige Erzählung nur teilweise. Astra knackte als stärkster Angreifer sechs von acht Brücken und landete trotzdem nur auf Platz 3. Alle 18 geknackten Brücken gehen auf die vier Erstplatzierten zurück. Laut Veranstalter traten in keinem Duell physikalische Fehler auf.
Die Community baut billiger, mit Vorbehalt
Auf arena.meowllm.top/ep9 kann jeder eigene Brücken für die Level 1–6 einreichen. Wir haben die öffentliche Bestenliste am 10. November abgerufen:
| Level | Bester KI-Entwurf im Wettbewerb | Günstigste Einreichung | Unterschied | Einträge |
|---|---|---|---|---|
| 1 | 3.531,70 (Opus) | 2.311,07 | −34,6 % | 201 |
| 2 | 7.701,80 (Sol) | 2.906,52 | −62,3 % | 133 |
| 3 | 7.714,88 (Sol) | 4.517,80 | −41,4 % | 72 |
| 4 | 11.712,20 (Sol) | 4.234,59 | −63,8 % | 103 |
| 5 | 8.620,74 (Sol) | 3.644,91 | −57,7 % | 68 |
| 6 | 17.212,99 (Sol) | 14.278,96 | −17,0 % | 110 |
Zwei Einschränkungen sind wichtig. Erstens rechnet der Server nur Kosten und Formalien nach, nicht die Physik. Stattdessen prüfen die Browser anderer Besucher die Spitzenplätze stichprobenartig und entfernen Brücken, die durchfallen. Zweitens ist die Liste nicht nur von Menschen besetzt. Spitznamen wie „gpt6.1sol“, „Hy4-Redo“ oder „ds 4.1 flash“ (Platz 1 in Level 5) deuten auf Agenten hin, die ohne Zeitlimit weitergearbeitet haben. Überprüfbar sind die Spitznamen nicht. Unsere Einschätzung: Die 90 Minuten Zeitlimit prägen das Ergebnis mindestens so stark wie das Modell selbst.
So machst du in zehn Minuten mit
- Nachrechnen: Repository klonen. Du brauchst Python 3.9 oder neuer und den C++-Compiler g++, unter Windows empfiehlt das Repository w64devkit. Dann im Ordner
bridge/python build_engine.pyundpython tournament/score.pyausführen. Das Skript rechnet alle 54 Entwürfe, 6 Referenzlösungen und 72 Duelle neu und meldet bei Übereinstimmung „核对通过“ („Prüfung bestanden“). Laut README dauert das auf einem 8-Kern-Rechner bis zu einer Minute. Ein Manifest mit SHA-256-Prüfsummen belegt, dass keine der 108 Dateien seit dem Wettbewerb verändert wurde. - Eigene Brücke bauen: Entweder im Simulator auf der Webseite oder mit einem Coding-Agenten. Dafür liegt die Datei
bridge/AGENT_PROMPT.mdbereit. Der Agent testet mitpython bridge.py run <Level> <Datei>und zeigt dir vor dem Hochladen Kosten und Testausgabe. Hochladen darf er erst nach deiner Zustimmung. Erlaubt sind 12 Uploads pro Stunde und 40 pro Tag. - Eigene Bots für die anderen Spiele:
sh start.shunter macOS und Linux,start.cmdunter Windows, oder direkt zum Beispielpython challenge.py dein_bot.cppim Ordnerctf/. Lautcommunity/LEADERBOARD.mdschlagen alle sechs Community-Panzer die 14 KI-Bots. Diese Werte stammen aber von anderen Rechnern und sind laut Projekt nicht direkt vergleichbar.
Ein Sicherheitshinweis aus dem Diplomacy-README: Agenten führen dort ohne Aufsicht Befehle auf dem Rechner aus. Das Projekt empfiehlt deshalb eine virtuelle Maschine oder ein eigenes Benutzerkonto.
Wie seriös ist das?
Der Veranstalter nennt die Grenzen selbst. Jedes Modell lief nur einmal. Werkzeuge, Zugangswege und Denkstufen waren verschieden, und gleichnamige Stufen wie „max“ oder „high“ sind zwischen Werkzeugen nicht vergleichbar. Die Versionen der Werkzeuge wurden nicht festgehalten. Wie groß der Zufall sein kann, zeigt die Tron-Folge: Wiederholungsläufe schwankten um etwa 300 Punkte, Mistrals Vorsprung betrug 92. Laut smzdm sagt der Kanalbetreiber selbst, die Folge sei „unterhaltsam und eilig“ entstanden.
Akademische Benchmarks gehen anders vor. BuildArena von der Westlake University wertet jede Kombination aus Aufgabe und Modell 64-mal aus und nutzt das Physikspiel Besiege. PolyBridgeBench (arXiv, September 2026) prüft sechs Modelle auf 189 Leveln im Spiel Poly Bridge. Dort zeigt sich etwas Ähnliches wie in der Meow-Folge: Ein knappes Materialbudget verändert die Rangfolge. Claude Sonnet 5 kam mit strengem Budget auf 50,8 Prozent Erfolg, Gemini 3 Flash führte mit lockerem Budget. Dafür hat das Hobbyprojekt etwas, das beiden fehlt: vollständige Agenten-Läufe mit Zeitdruck, einen byte-identisch nachbaubaren Schiedsrichter und die Möglichkeit für Menschen, selbst mitzumachen. Wer hinter dem GitHub-Konto chen-006 steht, wer die API-Kosten bezahlt und nach welchen Kriterien Modelle und Werkzeuge ausgewählt werden, steht nicht in den öffentlichen Unterlagen.
Einordnung
Die Meow AI Arena ist kein Maßstab für Modellqualität und will das auch nicht sein. Dafür zeigt sie Fehlermuster in einer Form, die man selbst nachprüfen kann. GPT-6.2 Sol gewann den Brückenbau als einziges Modell, das alle sechs Level bestand. Opus 5.5 und Astra verloren ihre Punkte durch Budgetfehler, die eine einfache Prüfung vor der Abgabe verhindert hätte. Bei den chinesischen Modellen und bei Gemini fielen die Brücken in den schweren Leveln durch, obwohl lokale Tests ihnen das hätten zeigen können.
Unsere Einschätzung: Wer Agenten für längere Aufgaben einsetzt, sollte sich diese Muster merken. Gefährlich sind nicht schlecht geschriebene Codezeilen, sondern Abgaben, die ungeprüft und zu knapp gebaut sind, oder die gar nicht erst fertig werden. Offen ist, wie stabil die Rangfolge bei Wiederholungen wäre. Auch ein Vergleich mit gleichen Werkzeugen für alle fehlt bisher. Wer mehr wissen will, kann die Daten selbst nachrechnen.
Quellen
- GitHub: chen-006/meow-ai-arena (README, Episodenliste) github.com
- GitHub: Brückenbau-Folge (bridge/README) github.com
- GitHub: bridge/results/scores.json raw.githubusercontent.com
- GitHub: bridge/results/README.md (Level-Status und Duellmatrix) raw.githubusercontent.com
- GitHub: bridge/CONDITIONS.md raw.githubusercontent.com
- GitHub: bridge/AGENT_PROMPT.md raw.githubusercontent.com
- GitHub: bridge/source_manifest.json raw.githubusercontent.com
- GitHub: Tron-Folge github.com
- GitHub: Diplomacy-Folge github.com
- GitHub: Lagerlogistik und Code-Optimierung github.com
- GitHub: Fußball-Folge github.com
- GitHub: Panzer-Folge github.com
- GitHub: Bomberman-Folge github.com
- GitHub: community/LEADERBOARD.md raw.githubusercontent.com
- GitHub: Issues des Projekts github.com
- Meow Arena: Upload-Seite Folge 9 arena.meowllm.top
- Meow Arena API: Bestenliste Level 1 arena.meowllm.top
- Meow Arena API: Bestenliste Level 2 arena.meowllm.top
- Meow Arena API: Bestenliste Level 3 arena.meowllm.top
- Meow Arena API: Bestenliste Level 4 arena.meowllm.top
- Meow Arena API: Bestenliste Level 5 arena.meowllm.top
- Meow Arena API: Bestenliste Level 6 arena.meowllm.top
- smzdm: Neun KI-Brücken-Wettbewerb komplett offen, wie man selbst mitmacht post.smzdm.com
- smzdm: Nicht das Programmieren entschied post.smzdm.com
- smzdm: 75 Punkte Abstand, es lag nicht am Code post.smzdm.com
- smzdm: Mensch gegen Modell bei den Baukosten post.smzdm.com
- smzdm: Angriff und Verteidigung im Brückenbau post.smzdm.com
- smzdm: Sechs von neun scheitern in den letzten drei Leveln post.smzdm.com
- arXiv: PolyBridgeBench (2609.21493) arxiv.org
- BuildArena Projektseite build-arena.github.io
- arXiv: BuildArena (2510.16559) arxiv.org
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.