
Microsoft Agensh: 1.024 KI-Agenten arbeiten ohne Chef zusammen
Microsoft Research hat Agensh als Open Source veröffentlicht, ein System, in dem bis zu 1.024 KI-Agenten ohne zentralen Koordinator an einem Code-Repository arbeiten. In Tests mit schwierigen Programmieraufgaben stieg die Erfolgsquote mit der Zahl der Agenten, allerdings mit abnehmendem Zusatznutzen.
Worum es geht
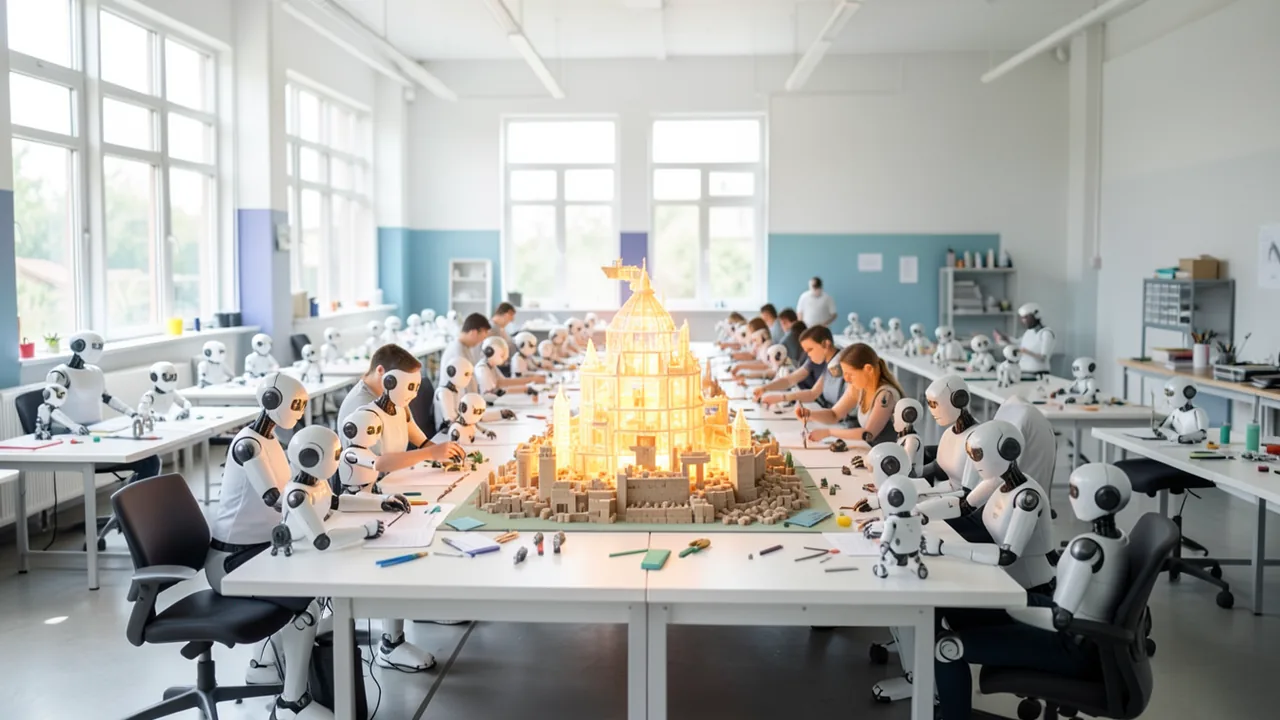
Microsoft Research hat Agensh als Open Source veröffentlicht. Das System koordinierte in Tests bis zu 1.024 KI-Agenten, die gleichzeitig am selben Code-Repository arbeiteten, ohne dass ein leitender Agent die Aufgaben verteilt. Ein Harness ist dabei die Laufumgebung, die ein Sprachmodell umgibt: Sie liefert Werkzeuge, Gedächtnis und Kontextsteuerung. Agensh ist ein solcher Harness für viele Agenten gleichzeitig. Die zentrale Idee ist, den Orchestrator (den Koordinator) wegzulassen. Die Angaben stammen aus einem Bericht, der sich auf das Paper und die Projektseite stützt, also im Kern auf Herstellerangaben.
Wie ein Team ohne Chef funktioniert
Bei üblichen Multiagenten-Systemen plant ein zentraler Agent, verteilt Arbeit und fügt Ergebnisse zusammen. Bei Agensh arbeitet jeder Worker gleichzeitig und asynchron, sucht sich selbst Teilaufgaben und stimmt sich direkt mit anderen ab. Jeder Agent durchläuft fünf Schritte:
- Kontext sammeln: Ziel, Fortschritt der anderen, Nachrichten und Erkenntnisse lesen.
- Teilaufgabe beanspruchen: einen CLAIM veröffentlichen und Überschneidungen per Direktnachricht klären.
- Ausführen: mit lokalen Werkzeugen arbeiten und nützliche Funde früh teilen.
- Prüfen: das Ergebnis gegen die Abnahmekriterien der Teilaufgabe testen.
- Zusammenführen: Änderungen ins gemeinsame Repository einpflegen, ein Update posten und von vorn beginnen.
Drei Dienste tragen die gemeinsame Arbeit: Gitea hostet Repository, Branches und Pull Requests, Mattermost bietet einen Team-Kanal und Direktnachrichten zur Konfliktlösung, und ein Kontext-Board speichert typisierte Notizen wie Beobachtungen, Fakten, Fehler, beanspruchte Aufgaben und Änderungszusammenfassungen.
Bemerkenswert: Die Koordinationslogik steckt im Prompt der Agenten, nicht im Ausführungscode. Alle Worker erhalten im Wesentlichen dieselben Anweisungen, nur die Kennung unterscheidet sich. Agensh setzt auf einem Einzelagenten-Harness auf; die Experimente nutzten GitHub Copilot CLI über ACP-Sitzungen. Laut dem Team könnten leichte Adapter andere Umgebungen wie Claude Code anbinden.
Ergebnisse auf ProgramBench
Getestet wurden die fünf schwersten ProgramBench-Aufgaben: FFmpeg, GROMACS, pandoc, PHP-src und ctags. Aufgabe ist, ein Programm aus beobachtetem Verhalten nachzubauen; die Agenten arbeiten offline, maximal sechs Stunden. Die Projekte unterscheiden sich stark: Das pandoc-Referenzrepository hat 2.767 Dateien, PHP-src 26.266.
Mit GPT-5.6-sol bei hohem Reasoning-Aufwand lag die mittlere Quote bestandener Tests über alle fünf Aufgaben bei:
| Agenten | Bestandene Tests |
|---|---|
| 1 | 19,31 % |
| 8 | 20,68 % |
| 32 | 26,52 % |
| 128 | 28,78 % |
Das sind 9,47 Prozentpunkte mehr, relativ etwa 49 %. Von 1 auf 8 Agenten ging es aber nur um 1,37 Punkte nach oben. Bei pandoc, dem einzigen Fall mit Zahlen für alle Stufen, ergaben sich 33,89 % (1), 41,75 % (8), 43,11 % (32), 50,94 % (128) und 55,06 % (1.024). Auch die Geschwindigkeit stieg: Mit 128 Agenten waren nach 30 Minuten über 30 % der Tests bestanden, mit 32 Agenten dauerte das 60 Minuten, mit 8 Agenten 90.
Die Projektseite nennt zudem eine Messung mit GPT-6.1-sol, die im ersten Paper fehlt: Bei pandoc stieg die Quote von 56,19 % (1 Agent) auf 79,59 % (32 Agenten), relativ 41,64 %. Diese Werte gehören zu einem anderen Modell und sollten nicht mit den übrigen vermischt werden.
Mehr Agenten, mehr Erfolg?
Nicht automatisch. Der deutlichste Gewinn zeigt sich beim Sprung von 8 auf 32 Worker, danach wird der Fortschritt moderater. Das Team versteht die Ergebnisse als Beleg, dass verteilte Zusammenarbeit die Leistung in diesen Tests heben kann, nicht als Garantie, dass Skalierung die Grenzen eines Modells aufhebt.
Interessant sind die Rollen, die sich mit wachsender Gruppe herausbildeten, ohne vorprogrammiert zu sein:
- 8 Agenten: einigten sich auf Schnittstellen und lösten überlappende Claims selbst.
- 32 Agenten: prüften gemeinsame Arbeit und zogen eine Freigabe zurück, nachdem ein Gegenbeispiel auftauchte.
- 128 Agenten: nutzten bewährte Reviewer erneut und standardisierten ein Integrationsprotokoll.
- 1.024 Agenten: manche übernahmen Integrationsaufgaben, andere halfen, gescheiterte Arbeit zu retten.
Vergleich und Umfeld
Laut dem Team nutzen Claude Code Agent Teams einen festen Leader und empfehlen drei bis fünf Agenten, Kimi Agent Swarm einen Orchestrator mit bis zu 100 Subagenten, und Copilot CLI nennt kein Limit. Ein Leistungsvergleich unter gleichen Bedingungen ist das nicht, da Architekturen, Modelle und Testprotokolle verschieden sind.
Der Bericht erwähnt weitere Entwicklungen: Microsofts Agent Framework wurde laut InfoQ am 2. April 2026 allgemein verfügbar, der Agent Harness folgte im Juni. Eine Analyse des VILA-Lab der MBZUAI schätzte, dass bei Claude Code v2.1.88 etwa 98,4 % des Codes Harness-Infrastruktur sind. Microsofts MDASH-System mit über 100 Agenten erreichte laut GeekWire 88,45 % auf CyberGym (selbst berichtet). UiPath zeigte mit Maestro Flow eine Orchestrierungsschicht, und Sakana AI nennt für Fugu Ultra rund 5 US-Dollar pro Million Eingabe- und 30 Dollar pro Million Ausgabe-Tokens.
Was du zum Ausprobieren brauchst
Agensh ist ein Forschungs- und Entwicklerwerkzeug, kein Modell zum Herunterladen. Die Referenzausführung läuft unter Linux mit Docker Compose, standardmäßig auf einem Knoten mit acht Workern, sechs Stunden pro Aufgabe und GPT-5.6-sol. Nötig sind Docker Engine, Compose v2, systemd, cgroup v2 und Python 3.11 oder neuer sowie ein API-Token des Modells. Der 1.024-Agenten-Lauf benötigte 16 Knoten mit je 64 Workern und bis zu 64 GiB Speicher pro Worker. Pro Worker gelten höchstens 272.000 Eingabe- und 128.000 Ausgabe-Tokens. ProgramBench v1.2.5 wird validiert. Lizenz: MIT.
Einordnung
Agensh zeigt, dass sich Agententeams ohne Chef organisieren können, wenn die gemeinsame Umgebung (Repository, Kanal, Notizboard) stimmt. Für Entwicklerteams ist das ein Anhaltspunkt, wo zusätzliche Agenten Nutzen bringen: der Gewinn von 1 auf 8 war klein, von 8 auf 32 am größten. Kritisch bleibt vieles: Die Ergebnisse gelten für bestimmte Kombinationen aus Modell, Aufgabe und Agentenzahl, Kosten für Tokens wurden nicht genannt, und die absoluten Quoten (unter 30 % im Schnitt) sind niedrig. Ein menschlicher Blick auf das, was ins Repository gelangt, bleibt sinnvoll, zumal selbst Peer-Review erst durch ein Gegenbeispiel einen Fehler korrigierte. Wer es testet, sollte zuerst die Kosten pro Punkt Verbesserung messen.
Quellen
- Bing News (es-ES) ecosistemastartup.com
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.