NVIDIA unterstützt offiziell 8-Node-Cluster aus DGX Spark mit 1 TB Speicher
Acht DGX-Spark-Knoten bündeln 1 TB Unified Memory und führen lokal sogar das volle GLM 5.3 (753B) aus. Ein neues Collective-Backend beschleunigt zudem den Decode.
Worum es geht
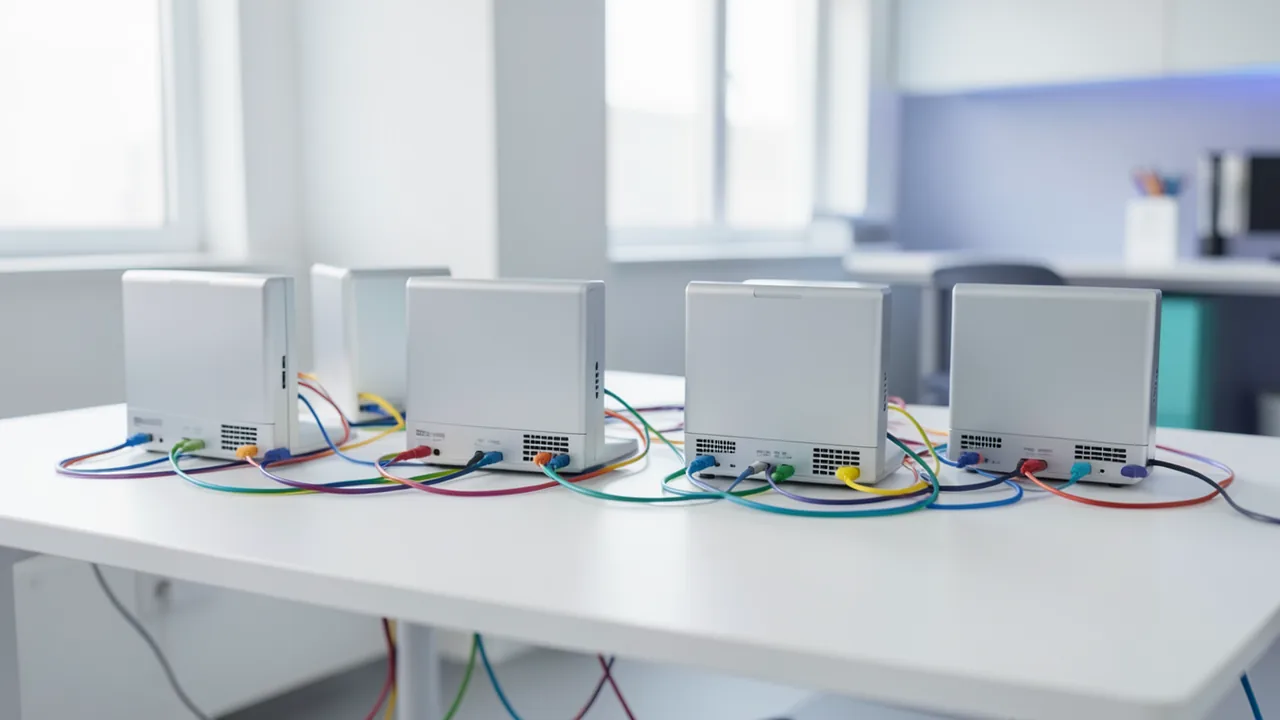
NVIDIA hat auf der GTC Berlin offiziellen Support für Cluster aus bis zu acht DGX-Spark-Knoten angekündigt. Damit wächst der gemeinsame Unified Memory auf 1 TB, sodass sehr große Modelle lokal laufen. Der Blogpost liefert dazu Benchmarks zu Inferenz und Skalierung.
Die wichtigsten Fakten
- Ein DGX Spark hat 128 GB Unified Memory, vier Nodes 512 GB, acht Nodes 1 TB.
- Das volle GLM 5.3 (753B) von Z.ai läuft auf dem 8x-128-GB-Cluster; GLM 5.3 Flash erreicht dort laut NVIDIA etwa 80 Tokens/s in der Generierung.
- Das Spark-optimierte Collective-Backend RoCEnante nutzt einen All-to-all-Austausch mit lokaler Reduktion in einem einzigen GPU-Kernel. Es bringt rund 5 % mehr Prefill und 21 % mehr Decode bei vier Nodes (NVFP4) sowie etwa 18 % mehr Decode bei acht Nodes (nicht quantisiert).
- Das Backend ist in FlashInfer gemergt, fällt bei fehlgeschlagenem Starttest auf NCCL zurück und funktioniert nur mit Switch-Topologien.
- Das dichte Qwen3.8-27B (NVFP4) skaliert im Decode von etwa 12 TPS (1 Node) auf 52 TPS (8 Nodes).
- Ein physischer Ring ist für ein einzelnes Modell über alle Nodes sehr gut; ein Switch braucht man für getrennte Gruppen oder Any-to-any-Verkehr.
- Support für acht Nodes in NVIDIA Sync soll bis Jahresende kommen.
Einordnung
Für Enthusiasten und kleine Teams ist das ein Weg, Frontier-große MoE-Modelle ohne Rechenzentrum lokal zu betreiben. Die Skalierung ist aber sublinear (4,3x Decode bei 8x Hardware), und die Kosten für acht Geräte plus Netzwerk sind nicht genannt. Die Zahlen stammen vom Hersteller.