
Pika H3 Flex: Offenes Video-Modell mit Ton in nur sechs Schritten
Pika Labs veröffentlicht Pika H3 Flex, ein Nachtraining von MiniMax-H3, das Video mit synchronem Stereo-Ton in nur sechs Sampling-Schritten erzeugt. Die Gewichte sind als LoRA-Adapter frei herunterladbar, ComfyUI-Workflows gibt es dazu. Lokal ist allerdings viel Hardware nötig.
Worum es geht
Pika Labs hat auf Hugging Face das Modell Pika H3 Flex veröffentlicht. Es ist ein nachtrainiertes (post-trained) Modell auf Basis von MiniMax-H3 und erzeugt Videos samt synchronisiertem Stereo-Ton. Der Clou laut Hersteller: Es braucht nur sechs Sampling-Schritte – also sechs Durchläufe des Modells pro Generierung –, wo andere Video-Modelle oft deutlich mehr benötigen. Pika bezeichnet es als Werkzeug für professionelle Kreative, die schnell und mit präziser Kontrolle iterieren wollen. Die Gewichte, der Code und ComfyUI-Workflows sind öffentlich. Bekannt wurde die Veröffentlichung über einen Reddit-Beitrag in r/StableDiffusion.
Aufbau: Zwei Adapter auf einem Basismodell
Pika H3 Flex ist eine Modellfamilie für Video und Audio mit zwei „Task-Adaptern“. Ein Adapter ist hier ein LoRA – eine kleine Zusatzschicht, die ein großes Basismodell für eine Aufgabe umlenkt, ohne dessen gesamte Gewichte zu ersetzen. Beide Adapter liegen als FP32-LoRA mit Rank/Alpha 128 vor.
- FL2VA (Text und Endpunkt-Bilder): Text-zu-Video, Startbild, Endbild oder beides.
- Ref2VA (multimodale Referenzen): Das Modell bekommt geordnete Bild- und Videoreferenzen, optional Audio.
Die Pipeline kodiert Prompt und Eingabemedien, erzeugt Video- und Audio-Latents (komprimierte Zwischendarstellungen) mit dem gewählten Adapter, dekodiert sie und fügt alles zu einer MP4-Datei zusammen. Das Repository enthält zusätzlich die MiniMax-H3-Basiskomponenten im Diffusers-Format (Transformer, Text-Encoder, VAE, Audio-VAE, Tokenizer). Der Transformer ist dabei nur das Basismodell; der passende Pika-Adapter muss separat angewendet werden. Ein Hinweis aus dem Manifest: Generisches Sechs-Schritt-Euler-Sampling ist nicht gleichwertig – es muss der mitgelieferte, exakte Sampling-Plan verwendet werden.
Technische Daten
| Eigenschaft | Wert |
|---|---|
| Eingaben | Text; erstes/letztes Bild; Bild-, Video- und Audioreferenzen |
| Native Auflösung | 480p / 768p |
| Seitenverhältnisse | 11, von 21:9 über 1:1 bis 9:21 |
| Dauer | 5–15 Sekunden (ganzzahlig angefordert) |
| Bildrate | 24 fps |
| Audio | 32 kHz Stereo, ins Video gemischt |
| Ausgabe | MP4 (H.264/AAC) plus JSON-Metadaten |
| Prompt | 1–8.000 Zeichen |
Die Dauer wird auf das Frame-Raster des Modells aufgerundet: 5 Sekunden ergeben 124 Frames (ca. 5,17 s), 15 Sekunden ergeben 362 Frames (ca. 15,08 s).
Referenzen und Modi
Supportet werden Text-zu-Video, Start-Bild (i2va), End-Bild (l2va), beide Bilder (fl2va) und Referenzmodus (ref2va). Ref2VA nimmt bis zu 9 Bilder, 3 Videos und 3 separate Audioclips, insgesamt 12 Dateien; mindestens ein Bild oder Video ist Pflicht. Videos und Audioclips müssen je 2–15 Sekunden lang sein, die Summe der Videos und die Summe der Audioclips darf je 15 Sekunden nicht überschreiten. Der eingebettete Ton eines Videos zählt nicht als eigene Audiodatei. Pika betont, dass das nur akzeptierte Eingabegrenzen sind – nicht jede Maximalkombination passt in den GPU-Speicher.
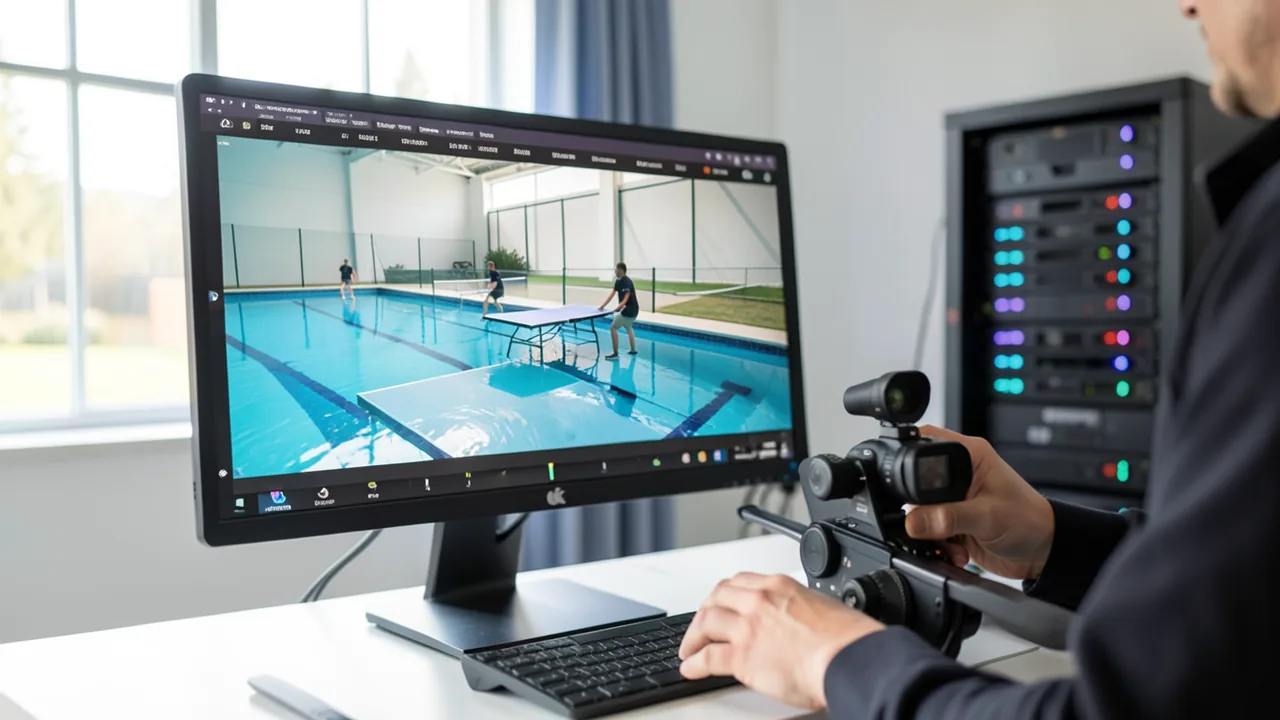
Der Beispiel-Prompt im Repo zeigt, was gemeint ist: eine Tischtennis-Szene in einem leeren Pool mit minutengenau getakteten Kamerabewegungen (Top-down, Kranfahrt, Schwenks, 180-Grad-Orbit), konsistenten Figuren laut Referenzbild sowie detaillierter Beschreibung von Geräuschen und Musik. Pika weist darauf hin, dass die Showcase-Clips kreative Beispiele sind, keine Validierungs-Renderings oder Durchsatz-Benchmarks; exakte Reproduktion sei nicht garantiert, Seeds und Preprocessing sind unspezifiziert.
Pika-API-Erweiterungen
Separat von den herunterladbaren Gewichten bietet Pika gehostete Dienste: Video in 1080p, 2K und 4K aus einem Entwurfsvideo, getrennte Audio-Stems und Prompt-Verbesserung. Diese Funktionen gelten nicht für die lokale Inferenz, die nativ 480p/768p mit gemischtem Stereoton liefert.
Was du zum Ausprobieren brauchst
Die Basiskomponenten belegen etwa 210 GB; ein Workflow lädt nur die zu ihm passende Transformer-Partition. Das Pika-CLI läuft mit einer Anfrage auf einer GPU. Getestet wurden repräsentative 480p- und 768p-Anfragen auf einer H100 mit 80 GB. Große Anfragen brauchen --cpu-offload und reichlich Host-RAM. Das ist also eher Workstation- oder Cloud-Niveau als Gaming-PC; konkrete Werte für kleinere Karten nennt die Quelle nicht (Details stehen in der Hardware-Doku des Repos). Installation per pip, Conda oder Docker; der Befehl pika-h3-pro lädt Basis und Adapter automatisch. Alternativ gibt es ComfyUI-Workflows (T2V, FL2VA, R2V) mit BF16-LoRAs sowie Diffusers-Beispiele. Google Colab und Kaggle werden als Plattformen genannt, ob die Hardware dort reicht, ist offen.
Lizenz
Die Adapter sind Derivate von MiniMax H3 und stehen unter der MiniMax H3 Community License. Die gebündelten Basiskomponenten behalten die MiniMax-Lizenz, der Qwen-Encoder samt Tokenizer ist Apache 2.0, der Beispielcode ebenfalls Apache 2.0 (nicht aber Gewichte und Beispielmedien). Pika bittet um Nennung und Zitat des „Technical Deep Dive“.
Einordnung
Sechs Schritte für Video mit Ton sind ein attraktives Geschwindigkeitsversprechen, zumal Referenzsteuerung mit bis zu 12 Dateien und Kameraführung per Prompt für Mehrszenen-Erzählungen praktisch sind. Belegt ist das bisher nur durch Pikas eigene Showcases; unabhängige Tests, Geschwindigkeitsmessungen und Qualitätsvergleiche fehlen in den Quellen. Lokal bleibt die Hürde hoch (210 GB Basis, 80-GB-Karte als Testkonfiguration), und höhere Auflösungen sind an die kostenpflichtige Pika-API gebunden. Die Community-Lizenz kann Nutzungsbeschränkungen enthalten, die du vor kommerzieller Nutzung prüfen solltest.
Quellen
- Reddit: lokale Modelle & Bild-KI huggingface.co
- Bing News (en-US) aiweekly.co
- Bing News (ja-JP) note.com
- Reddit: lokale Modelle & Bild-KI reddit.com
Selbst ausprobieren: Pika H3 Flex
Schritt für Schritt erklärt, auch ohne Vorkenntnisse – auf deinem Rechner oder kostenlos im Browser.
Was kann ich damit machen?
Pika H3 Flex erzeugt aus Text, Start-/Endbildern oder bis zu 12 Referenzdateien kurze Videos von 5–15 Sekunden mit passendem Stereo-Ton. Dank nur sechs Sampling-Schritten soll es schnell iterieren lassen. Du kannst Kamerabewegungen zeitlich im Prompt festlegen und Figuren per Referenz konsistent halten. Lokal sind 480p/768p möglich, höhere Auflösungen nur über die Pika-API. Wie gut es im Vergleich zu anderen Video-Modellen ist, belegen die Quellen nicht; es gibt nur Herstellerbeispiele. Die Hardware-Anforderungen sind hoch.
Für wen lohnt es sich?
Interessant für Kreative, Studios und Entwickler mit Zugang zu einer großen GPU (z. B. H100 80 GB oder Cloud-Miete) und für ComfyUI-Nutzer, die Video mit Ton und Referenzsteuerung experimentell testen wollen. Für normale Gaming-PCs ist es eher nichts.
Ideen: Was du damit anstellen kannst
Mit einem Produktfoto als Referenz erzeugst du einen kurzen Clip mit Kamerafahrt und Musik. Nützlich für Shops oder Social Media.
Mit Start- und Endbild lässt du Übergänge zwischen zwei Szenen animieren, um Ideen schnell zu prüfen.
Mit Referenzbildern bleibt eine Figur über mehrere Clips gleich. So entstehen Mehrszenen-Geschichten.
Grafische Elemente und Typo-freie Animationen als Intro oder Hintergrund für eigene Videos.
Mit Audioreferenz und Beschreibung entsteht ein kurzer Clip, der zum Rhythmus eines Songs passt.
Was dein Rechner braucht
Es gibt zwei Adapter: FL2VA für Text-zu-Video und Start-/Endbild, Ref2VA für Referenzen. Wähle nach Aufgabe. Für ComfyUI liegen BF16-LoRAs bereit. Die Quelle nennt keine kleineren Quantisierungen.
- Basiskomponenten ca. 210 GB Speicherplatz; pro Workflow wird nur die passende Transformer-Partition geladen.
- Getestet auf H100 mit 80 GB für 480p und 768p.
- Große Anfragen brauchen --cpu-offload und viel Host-RAM.
- Das CLI nutzt eine GPU pro Anfrage.
- Diffusers-Beispiele haben eigene Installations- und Validierungshinweise in examples/README.md.
Wie finde ich heraus, was mein Rechner hat?
- Windows: Strg + Umschalt + Esc drücken → Task-Manager → Reiter Leistung → links GPU anklicken. Unten steht Dedizierter GPU-Speicher (das ist dein VRAM). Den Arbeitsspeicher findest du unter Arbeitsspeicher.
- Mac: Apfel-Menü oben links → Über diesen Mac. Dort stehen Chip (z. B. M2) und Speicher (z. B. 16 GB). Bei Apple-Chips teilen sich Grafik und Prozessor diesen Speicher.
- Linux: Im Terminal
nvidia-smieingeben (zeigt Grafikkarte und Speicher) undfree -hfür den Arbeitsspeicher.
Anleitung
Google Colab (im Browser, ohne Installation)
Google Colab ist ein kostenloser Dienst von Google: Du bekommst für ein paar Stunden einen Rechner mit Grafikkarte im Browser. Du brauchst nur ein Google-Konto. Für dieses Modell: nur mit Colab Pro/Pro+ – braucht eine A100 mit 80 GB oder H100.
- Notebook herunterladen. Klick auf den Knopf und speichere die Datei.
- Colab öffnen. Geh auf colab.research.google.com und melde dich mit deinem Google-Konto an.
- Notebook hochladen. Im Fenster, das erscheint, links auf Hochladen klicken (oder oben Datei → Notebook hochladen) und die Datei
colab.ipynbauswählen. - Grafikkarte einschalten. Oben im Menü Laufzeit → Laufzeittyp ändern → bei Hardwarebeschleuniger T4-GPU auswählen (mit Colab Pro: L4 oder A100) → Speichern.
- Alles starten. Laufzeit → Alle ausführen (Tastenkürzel Strg + F9). Kommt die Warnung „Dieses Notebook wurde nicht von Google erstellt“, auf Trotzdem ausführen klicken.
- Warten. Die Zellen laufen nacheinander durch. Links neben jeder Zelle erscheint ein grüner Haken, wenn sie fertig ist. Installation und Download dauern hier etwa 77 Minuten.
- Ausprobieren. Das Ergebnis steht unter der letzten Zelle. Um etwas anderes zu testen, den Text in der Zelle ändern und mit Shift + Enter erneut ausführen.
- Aufräumen. Wenn du fertig bist: Laufzeit → Sitzung beenden. Das schont dein kostenloses Kontingent.
Gut zu wissen: Die Gratis-GPU ist begrenzt (meist einige Stunden am Tag). Nach rund 90 Minuten ohne Aktivität trennt Colab die Verbindung, dann alles neu starten.
Windows 10 / 11
Dieses Modell läuft mit Python. Unser Skript erledigt die Einrichtung automatisch: Es legt eine abgeschottete Python-Umgebung an, installiert die nötigen Programme (PyTorch, ca. 3 GB) und lädt das Modell (220 GB (bei 100 MBit/s ca. 4,9 Std.)).
- Grafikkartentreiber aktualisieren (NVIDIA): aktuellen Treiber installieren. Ohne NVIDIA-Karte läuft es auf dem Prozessor – deutlich langsamer.
- Python installieren. Auf python.org Python 3.12 herunterladen und starten. Wichtig: Unten im ersten Fenster das Häkchen bei Add python.exe to PATH setzen, dann Install Now.
- Ordner anlegen und Dateien laden. Einen Ordner erstellen, z. B.
Dokumente\KI-Test, und beide Dateien hineinspeichern: - Terminal im Ordner öffnen. Den Ordner im Explorer öffnen, Rechtsklick auf eine freie Stelle → In Terminal öffnen.
- Starten. Diesen Befehl einfügen und Enter drücken:
Jetzt laufen Installation und Download. Das kann beim ersten Mal 10–30 Minuten dauern.powershell -ExecutionPolicy Bypass -File try_windows.ps1 - Ergebnis. Im Ordner liegt jetzt das erzeugte Bild
output.png. - Nochmal mit eigener Eingabe:
demo.pymit dem Editor öffnen, den Beispieltext ändern, speichern. Dann im Terminal:.\.venv-pika-h3-flex\Scripts\Activate.ps1 python demo.py
macOS
Ideal sind Macs mit Apple-Chip (M1 bis M5). Ältere Intel-Macs sind sehr langsam.
- Terminal öffnen. Cmd + Leertaste, Terminal eintippen, Enter.
- Entwicklerwerkzeuge installieren (nur beim ersten Mal, liefert Python mit):
Im Fenster auf Installieren klicken. Kommt „already installed“, ist alles schon da.xcode-select --install - Dateien herunterladen – beide landen im Ordner Downloads:
- Starten:
Installation und Download dauern beim ersten Mal 10–30 Minuten.cd ~/Downloads bash try_mac.sh - Ergebnis. Im Ordner liegt jetzt das erzeugte Bild
output.png.
Linux
- Grafikkarte prüfen.
nvidia-smisollte deine Karte anzeigen. Wenn nicht, unter Ubuntu den Treiber installieren und neu starten:sudo ubuntu-drivers install - Python-Grundlagen installieren (Ubuntu/Debian):
sudo apt update && sudo apt install -y python3-venv python3-pip git - Dateien in einen Ordner laden und dort ein Terminal öffnen:
- Starten:
bash try_linux.sh - Ergebnis. Im Ordner liegt jetzt das erzeugte Bild
output.png.
Das kannst du ausprobieren
Ein Golden Retriever läuft bei Sonnenaufgang durch einen nebligen Wald, Vogelgezwitscher im Hintergrund, ruhige Klaviermusik.Bild 1 zeigt meine Hauptfigur: Halte sie exakt bei. 0–5 s: Totale von oben auf einen Marktplatz; 5–10 s: langsame Kranfahrt nach unten zur Figur; Ton: Stimmengewirr und Straßenmusik.Produktfilm: Eine Sportuhr dreht sich auf einem Podest, 180-Grad-Orbit, weiches Studiolicht, dezenter Elektro-Beat.Zwei Tänzer in einer leeren Halle, schnelle Schwenks, echte Geschwindigkeit ohne Zeitlupe, Schuhquietschen und Hall.Start- und Endbild vorgeben: Tag wird zur Nacht über einer Stadt, mit sanftem Übergang und Verkehrsgeräuschen.Tipps für bessere Ergebnisse
- Nutze den Prompt-Guide: Beschreibe Szene, Bewegung, Dialog, Ambiente und Musik getrennt.
- Gliedere Kamerabewegungen mit Zeitstempeln wie im Beispiel-Prompt.
- Schreibe bei Bedarf „normale Geschwindigkeit, keine Zeitlupe“ in den Prompt.
- Starte mit 480p und kurzer Dauer, bevor du 768p und 15 Sekunden probierst.
Wenn es hakt
Generisches Sechs-Schritt-Euler-Sampling ist nicht gleichwertig; der mitgelieferte Sampling-Plan muss genutzt werden.
Die Diffusers-Beispiele brauchen einen bestimmten Upstream-Commit (examples/requirements-diffusers.txt), getrennt vom Pika-CLI installieren.
Der Transformer im Repo ist nur das Basismodell; der Adapter muss separat geladen werden.
Maximal erlaubte Referenzkombinationen passen nicht automatisch in den GPU-Speicher.
Lizenz: MiniMax H3 Community License prüfen, bevor du kommerziell arbeitest.
Höhere Auflösungen (1080p–4K) gibt es nur über die gehostete Pika-API.
„out of memory“, Absturz oder der Rechner hängt
Das Modell ist zu groß für deinen Grafikspeicher. Nimm eine kleinere Variante aus der Tabelle oben und schließe andere Programme, vor allem Spiele und Browser mit vielen Tabs.
Es läuft, aber extrem langsam
Wahrscheinlich rechnet der Prozessor statt der Grafikkarte. Bei Ollama zeigt ollama ps in der Spalte PROCESSOR, wie viel auf der GPU läuft. Steht dort „100% CPU“, Grafiktreiber aktualisieren oder eine kleinere Variante nehmen, die komplett in den Grafikspeicher passt.
„ollama“ bzw. „python“ wird nicht gefunden
Das Eingabefenster schließen und neu öffnen, damit es das frisch installierte Programm kennt. Bei Python unter Windows: neu installieren und das Häkchen Add python.exe to PATH setzen.
Windows: „Die Ausführung von Skripts ist auf diesem System deaktiviert“
Das Skript genau mit dem Befehl oben starten: powershell -ExecutionPolicy Bypass -File try_windows.ps1. Das erlaubt die Ausführung nur dieses einen Mal.
Fehlermeldung beim Laden des Modells (Version, „trust_remote_code“, unbekannte Architektur)
Ganz neue Modelle brauchen oft die neueste Programmversion. Bei Ollama: Ollama aktualisieren. Bei Python: pip install -U transformers in der aktivierten Umgebung. Die Model Card nennt meist die genaue Version.
Skripte und Notebook erzeugt Tokenstrom automatisch. Bitte vor dem Ausführen kurz ansehen – sie sind lesbarer Klartext. Lizenz des Modells beachten: eigene Lizenz (siehe Model Card).
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.