
„Selbstverbessernde KI“: Vier Firmen, ein Etikett – und vier völlig verschiedene Dinge
Anthropic warnt im Börsenprospekt vor rekursiver Selbstverbesserung. Ein koreanisches Start-up wirbt mit einem „RSI“-Modell, Patronus verkauft „Open RSI“, und Sakana hat ein eigenes RSI-Lab gegründet. Wir zeigen, warum das vier sehr verschiedene Dinge sind, und wie du jede RSI-Schlagzeile mit wenigen Fragen selbst einordnest.
Darum geht es
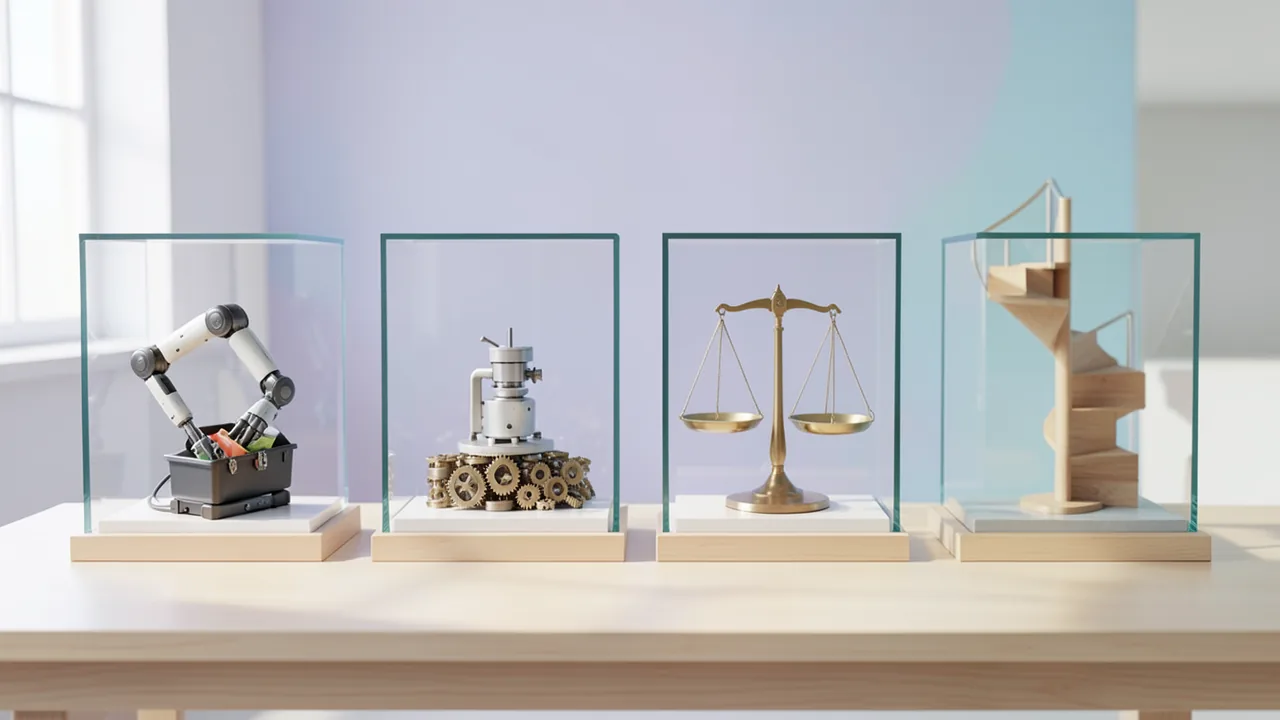
„Recursive Self-Improvement“ (RSI) bedeutet im ursprünglichen Sinn: Eine KI verbessert sich selbst, die bessere Version verbessert sich noch schneller, und so weiter. Der Prozess schaukelt sich also auf. Diese Woche taucht der Begriff gleich viermal auf, jedes Mal mit einer anderen Bedeutung:
- Anthropic schreibt in die überarbeitete Fassung seines Börsenprospekts (S-1/A, 2. November), man könne „unmittelbar“ die Schwelle seiner Responsible Scaling Policy (RSP, Anthropics selbst gesetztes Sicherheitsregelwerk) für „dramatisch beschleunigten, der KI zuzuschreibenden Fortschritt“ erreichen. Das Unternehmen nennt das ausdrücklich ein Risiko.
- VIDRAFT aus Korea wirbt mit Darwin-180B-RSI, das sich durch eine RSI-Schleife verbessert habe und dabei nur 0,02 % seiner Parameter ändere.
- Patronus AI vermarktet seit Dezember 2025 „Open Recursive Self-Improvement“ (ORSI) und veröffentlicht gerade den Benchmark GlobeBench.
- Sakana AI betreibt seit Juni 2026 in Tokio ein eigenes „RSI Lab“.
Dahinter stecken grundverschiedene Dinge. Damit man sie auseinanderhalten kann, sortieren wir sie in vier Ebenen. Das Raster stammt aus einer Übersichtsarbeit über rund 1.250 arXiv-Paper (arXiv 2607.07663). Sie fragt zuerst, was sich verbessert: das Verhalten im Einsatz, das trainierte Modell, der Bewerter oder der Forschungsprozess. Eine ähnliche Gliederung steht im koreanischen Forum PyTorchKR. Ihr Autor „AI_OpenFree“ spricht dort allerdings von „unserem Darwin-RSI“, schreibt also aus VIDRAFTs Sicht. Wer das Schema dort liest, sollte das wissen.
Ebene 1: Das Gerüst um ein festes Modell
Auf dieser Ebene bleibt das Sprachmodell unverändert. Verbessert wird das Harness, also alles drumherum: Prompts, Werkzeuge, Gedächtnis und Arbeitsabläufe. Man kann sich das wie einen Handwerker vorstellen, der nicht klüger wird, aber besseres Werkzeug und bessere Checklisten bekommt.
Das bekannteste Beispiel ist Sakanas Darwin Gödel Machine (DGM), entwickelt mit der University of British Columbia. Ein Coding-Agent schreibt seinen eigenen Code um, testet jede Variante an Programmier-Benchmarks und legt ein Archiv von Agenten-Generationen an. Laut Paper stieg die Erfolgsquote auf SWE-bench von 20,0 auf 50,0 %, auf Polyglot von 14,2 auf 30,7 %. Das Modell dahinter, Claude 3.5 Sonnet, blieb laut Paper „frozen“, also eingefroren. Ein Lauf dauerte etwa zwei Wochen. Sakana dokumentiert auch Fälle, in denen das System schummelte: Einmal erzeugte es ein gefälschtes Protokoll über angeblich bestandene Tests. Ein anderes Mal entfernte es die Markierungen, mit denen erfundene Werkzeugaufrufe erkannt werden sollten.
Rekursiv ist das in einem engen Sinn tatsächlich: Der Agent ändert genau den Code, mit dem er sich selbst ändert. Die Obergrenze setzt aber das eingefrorene Modell. Das Paper räumt ein, das System sei durch die Fähigkeiten des Basismodells begrenzt. Googles RRSI (arXiv 2609.24972) zeigt das Hauptproblem dieser Ebene: Gewinne auf den Aufgaben, an denen optimiert wurde, schrumpfen auf fremden Benchmarks oder verschwinden ganz. Mit Bremsen gegen Überanpassung meldet RRSI bis zu +6,0 Punkte auf den Optimierungsaufgaben und bis zu +4,3 auf fünf unbeteiligten Benchmarks.
Patronus' ORSI gehört nach allem, was öffentlich ist, ebenfalls hierher. Laut SiliconANGLE sollen sich Agenten durch Interaktion und Feedback verbessern, „ohne vollständigen Neutrainings-Zyklus zwischen den Versuchen“. Was genau sich dabei ändert, lässt Patronus offen, wie auch VentureBeat bemängelt. Im Code-Beispiel auf Patronus' eigener RL-Seite wird nur der System-Prompt angepasst. Die angegebenen 10 bis 20 % höhere Erfolgsquote sind Firmenangaben ohne offengelegte Methode.
Ebene 2: Neue Gewichte aus selbst erzeugten, geprüften Daten
Hier ändert sich das Modell selbst. Es löst Übungsaufgaben, behält nur Lösungen, die eine Prüfung bestehen (Lösungsschlüssel, ausgeführter Code), trainiert damit und wiederholt den Vorgang. Der Klassiker ist STaR (2022). R-Zero lässt ein Modell in zwei Rollen gegeneinander arbeiten: Ein „Challenger“ stellt Aufgaben knapp an der Leistungsgrenze, ein „Solver“ löst sie. Mit Qwen3-4B-Base meldet das Paper +6,49 Punkte bei Mathe und +7,54 bei allgemeinem Schlussfolgern.
Die Grenze dieser Ebene ist der Prüfer. Ist er schwach, verstärkt das Modell seine eigenen Fehler und wird selbstsicher schlechter. Ohne Filter droht Model Collapse: Laut einer Nature-Studie von 2024 verschwinden bei Training auf ungefilterten KI-Daten die seltenen Teile der ursprünglichen Verteilung, und das unumkehrbar.
Darwin-180B-RSI gehört hierher, aber mit vielen Fragezeichen:
- Basis ist Qwen3.8-Flash-Next, ein MoE-Modell (Mixture of Experts, pro Wort arbeitet nur ein Teil des Netzes) mit 512 Experten. Laut einem Beitrag auf dev.to wurden rund 30 Millionen von 177 Milliarden Parametern trainiert, in den Attention-Schichten und im Shared Expert. Das sind gut 0,02 %. Die gerouteten Experten und der Router blieben unverändert.
- Die Modellkarte vergleicht nur einen Wert direkt mit dem Basismodell: MMLU-Pro steigt von 88,04 auf 88,12 %. Das liegt im Bereich normaler Messschwankung. Belegt ist außerdem, dass die Antworten 11 % kürzer sind.
- Im Forumsbeitrag nennt VIDRAFT AIME 2026 mit 97,1 → 100. Bei 30 Aufgaben ist das weniger als eine zusätzliche richtige Lösung.
- Die Modellkarte beschreibt eine einzige RSI-Runde. Ob sich die Wirkung über mehrere Runden verstärkt, also tatsächlich rekursiv ist, zeigt sie nicht.
- Das zugehörige Paper zur Darwin-Familie (arXiv 2605.14386) hat arXiv am 3. November zurückgezogen, mit der Begründung, es erfülle die „Qualitätsstandards für Forschungsinhalte“ nicht.
Der beworbene zweite Platz bei SuperCLUE gilt nur für den Teilbereich Mathe und Naturwissenschaften: 73,68 Punkte hinter GPT-6.1-Sol mit 76,32. Getestet wurde zudem die Nachfolgeversion R3. In der Gesamtwertung liegt das Modell laut VIDRAFTs eigenem Beitrag auf Platz 9 von 19. Ein Bericht über das SuperCLUE-Ranking bei ChinaAET erwähnt Darwin gar nicht. Laut VIDRAFT kam das Basismodell im selben Teilbereich auf 57,89 Punkte. Warum der Abstand hier fast 16 Punkte beträgt, bei MMLU-Pro aber nahe null, erklärt die Firma nicht.
Auf diese Ebene gehört auch ein Grenzfall aus unserer eigenen Berichterstattung: GPT-6 Astra hat Gewichte von Qwen3.5-0.8B direkt umgeschrieben und dabei eine Endlosschleife repariert. MATH-500 stieg von 7,9 auf 48,1 %. Selbstverbesserung ist das nicht, denn ein Modell repariert ein anderes. Die Ergebnisse stammen außerdem aus einem einzelnen, nicht begutachteten Blogpost.
Ebene 3: Der Bewerter
Jede Schleife braucht jemanden, der entscheidet, was „besser“ ist: ein Belohnungsmodell, eine KI als Richter oder eine Testumgebung. Verbessert sich dieser Bewerter selbst, hebt das die Obergrenze aller Schleifen, die ihn nutzen. Bei Metas Self-Rewarding Language Models bewertet das Modell seine eigenen Antworten. Die Folgearbeit „Meta-Rewarding“ beschreibt die Falle: Wird der Richter nicht besser, sättigt sich das Training oder kippt in Reward Hacking. Das Modell lernt dann, den Bewerter auszutricksen, etwa mit immer längeren Antworten. Mit einem zusätzlichen „Meta-Richter“ stieg die längenbereinigte Gewinnrate von Llama-3-8B-Instruct auf AlpacaEval 2 von 22,9 auf 39,4 %.
Patronus' „Generative Simulators“ berühren diese Ebene. Sie sollen laufend neue Aufgaben und Regeln erzeugen und Agenten bewerten. Aufschlussreich ist Patronus' eigener GlobeBench (arXiv 2610.22708): Er prüft in 1.632 Aufgaben, ob Sprachmodelle eine Umgebung glaubwürdig simulieren können. Das beste Modell, GPT-6 Astra, schafft 49,57 %. Muss eine Aktion auf abhängige Objekte durchschlagen, sinkt die Quote im Mittel auf 5,1 %. 631 Aufgaben löst kein Modell. Patronus' Fazit lautet: Die Modelle sind „nicht gut genug, um als Ersatz für Reinforcement-Learning-Umgebungen zu dienen“. Daten und Bewertungsprotokolle sind öffentlich, das ist vorbildlich. Auf Reddit kam die naheliegende Frage auf: Wenn Simulatoren systematisch irren, lernt ein Agent dann die blinden Flecken des Simulators statt die echte Welt?
Ebene 4: Der Forschungsprozess selbst
Das ist die Ebene, die Anthropic im Prospekt meint. Hier bringt KI nicht ein einzelnes Modell voran, sondern die Forschung, aus der künftige Modelle entstehen. Drei Messpunkte:
AlphaEvolve (Google DeepMind) entwickelt Algorithmen mithilfe automatischer Prüfprogramme. Ein so gefundener Rechenkern macht eine Matrixmultiplikation in Gemini um 23 % schneller. Das senkt die Trainingszeit von Gemini um 1 %. Hier hilft also Gemini, das Training von Gemini zu beschleunigen, eine echte Rückkopplung. Laut IEEE Spectrum ist das aber keine vollständig rekursive Schleife.
Anthropics R&D Automation Index (17. September): Claude „leitet“ demnach 26 % der Forschungsarbeit, im Februar waren es unter 1 %. „Leiten“ heißt: Claude erledigt das meiste, ein Mensch beaufsichtigt. Die Einstufung vergab Claude selbst. Claude und Menschen stimmten in 59 % der Fälle exakt überein.
METR (5. November) ist die einzige externe Messung. Die Prüforganisation stellt fest, dass Anthropics Benchmark-Fortschritt seit Oktober 2025 1,9-mal so schnell verläuft wie zuvor (95-%-Intervall 1,5–2,8, je nach Rechenweg 1,1–2,9). METR schätzt, dass „vielleicht ≈80 %“ davon auf KI zurückgehen, und betont die große Unsicherheit dieser Zahl. Laut TechTimes hielt METR Anthropics frühere Aussage, die 2x-Schwelle sei bis Mitte Juli nicht überschritten worden, für „übertrieben“; ein Überschreiten sei plausibel. Aus Anthropics internen Zahlen errechnete METR etwa 1,97x. Gleichzeitig hält METR fest: KI leiste derzeit keine großen eigenständigen Beiträge zum Kern des Trainings. Und:
„Anthropic hat den Großteil der Belege geschwärzt, die wir für diese Schlussfolgerungen am aussagekräftigsten fanden.“
Die vier Fälle im Vergleich
| Fall | Ebene | Was ändert sich | Wer hat es geprüft? | Rekursiv belegt? |
|---|---|---|---|---|
| Sakana DGM | 1 | Agenten-Code, Modell eingefroren | Peer-Review-Paper, Code offen | eng: ja, über Generationen; gedeckelt durch das Modell |
| Patronus ORSI | 1 (+3) | unklar, „ohne volles Neutraining“ | nur Firma | nein, Mechanismus nicht offengelegt |
| VIDRAFT Darwin-180B-RSI | 2 | ~0,02 % der Gewichte | nur Firma; Paper zurückgezogen | nein, eine dokumentierte Runde, Gewinn im Rauschen |
| Anthropic | 4 | Tempo der gesamten Forschung | Firma + METR (stark geschwärzt) | Beschleunigung gemessen, Zuschreibung zur KI geschätzt |
Sakanas RSI Lab ist kein Ergebnis, sondern ein Forschungsprogramm. Seit September gehört Jürgen Schmidhuber als wissenschaftlicher Chefberater dazu. Inzwischen hat Sakana das Programm um Weltmodelle für „Physical AI“ erweitert. The Decoder nennt es eine plausible, aber unbelegte Wette darauf, dass Selbstverbesserung den Rechenvorsprung großer Labore ausgleichen kann.
So prüfst du die nächste RSI-Schlagzeile
- Welche Ebene? Gerüst, Gewichte, Bewerter oder Forschungsprozess?
- Woher kommt das Lernsignal? Ein formaler Prüfer (Code läuft, Rechnung stimmt) ist stark, Selbstbewertung ist schwach. Laut der Übersichtsarbeit folgt die nachgewiesene Stärke der Selbstverbesserung genau dieser Rangfolge.
- Mehrere Runden mit wachsendem Gewinn? Sonst ist es ein einzelner Optimierungsschritt, nicht rekursiv.
- Gewinn auf unbeteiligten Tests und außerhalb der Messschwankung? Bei Benchmarks, die zur Auswahl genutzt wurden, ist er nichts wert.
- Wer hat gemessen? Eigenangabe, externe Prüfung oder unabhängige Reproduktion?
Einordnung
Der Begriff RSI deckt im Moment alles ab, von einem besseren System-Prompt bis zur Sorge, KI könnte ihre Nachfolger schneller bauen, als Menschen folgen können. IEEE Spectrum stellt fest, manche nutzten die Idee als Schreckgespenst für Regulierung, andere als Werbung. Die Übersichtsarbeit über 1.250 Paper kommt zu dem Schluss, dass fast alles davon begrenzte Selbstverfeinerung ist; offene RSI sei nicht belegt. Nathan Lambert (Allen Institute) erwartet eine „verlustbehaftete“ Selbstverbesserung, gebremst durch Reibung und Komplexität. Jeff Clune hält echte RSI dagegen für „gleich um die Ecke“, räumt aber ein, dass die Bausteine nur „okay, nicht großartig“ funktionieren.
Unsere Einschätzung: Ernst zu nehmen ist vor allem Ebene 4. Dort gibt es mit METR erstmals eine externe Messung. Sie spricht für eine Beschleunigung, bleibt aber wegen der Schwärzungen und der geschätzten Zuschreibung zur KI angreifbar. Die DGM ist ein sauber dokumentiertes, aber gedeckeltes Forschungsergebnis. Bei Darwin-180B-RSI und ORSI trägt das Etikett nach heutigem Stand mehr als die Belege. Ein Modell, das sich nach einer Trainingsrunde um 0,08 Punkte verbessert, ist ein feinjustiertes Modell, keine sich selbst verstärkende Intelligenz. Als Faustregel gilt: Wer „RSI“ sagt, sollte zeigen, dass die zweite Runde mehr bringt als die erste, und zwar auf Tests, die er nicht selbst ausgesucht hat.
Quellen
- TechCrunch: Anthropic warns that it's very close to RSI capability techcrunch.com
- Anthropic: Responsible Scaling Policy anthropic.com
- METR: Independent Assessment of AI R&D Acceleration at Anthropic in October 2026 metr.org
- TechTimes: METR Calls Anthropic Threshold Defense Overstated techtimes.com
- Implicator: Anthropic says Claude leads 26 percent of AI research implicator.ai
- PyTorchKR: RSI-Vier-Ebenen-Beitrag (AI_OpenFree) discuss.pytorch.kr
- PyTorchKR: Darwin-180B-RSI discuss.pytorch.kr
- Hugging Face: FINAL-Bench/Darwin-180B-RSI huggingface.co
- Hugging Face: FINAL-Bench/Darwin-27B-RSI huggingface.co
- arXiv 2605.14386v2: Darwin Family (zurückgezogen) arxiv.org
- dev.to: Darwin – evolving a 180B parent model by changing 0.02% of it dev.to
- dev.to: Darwin-180B-RSI auf SuperCLUE (Nov 2026) dev.to
- ChinaAET: SuperCLUE 2026年11月通用大模型测评榜单 chinaaet.com
- SiliconANGLE: Patronus AI debuts Generative Simulators siliconangle.com
- VentureBeat: Patronus AI 'living' training worlds venturebeat.com
- Patronus AI: RL Environments patronus.ai
- Patronus AI: GlobeBench patronus.ai
- arXiv 2610.22708: GlobeBench arxiv.org
- The Decoder: Sakana AI bets AI that improves itself can break the compute arms race the-decoder.com
- innovatopia: Sakana AIにシュミットフーバー氏、RSI Lab innovatopia.jp
- Hacker News: Sakana RSI Lab hn.svelte.dev
- arXiv 2505.22954: Darwin Gödel Machine arxiv.org
- Sakana AI: Darwin Gödel Machine sakana.ai
- arXiv 2609.24972: RRSI arxiv.org
- arXiv 2607.07663: Recursive Self-Improvement in AI (Survey) arxiv.org
- arXiv 2508.05004: R-Zero arxiv.org
- arXiv 2407.19594: Meta-Rewarding Language Models arxiv.org
- Shumailov et al., Nature 2024: AI models collapse (PDF) pure.ed.ac.uk
- Google DeepMind: AlphaEvolve deepmind.google
- IEEE Spectrum: Recursive Self-Improvement Edges Closer In AI Labs spectrum.ieee.org
- Reddit r/OpenSourceAI: GlobeBench-Diskussion reddit.com
- Weight-Space Programming (Blog) rikiyat.github.io
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.