
Videoanruf mit der KI: Metas Muse bekommt einen Avatar mit Mimik und Gestik
Meta schaltet für US-Nutzer Sprach- und Videoanrufe mit seinem KI-Agenten Muse frei. Ein animierter Avatar reagiert dabei in Echtzeit mit Mimik, Lippenbewegungen und Gesten auf das Gespräch, als Person, Tier oder Fantasiefigur.
Worum es geht
Meta hat seinem persönlichen KI-Agenten Muse eine Stimme und ein Gesicht gegeben. Seit dem 5. November 2026 können Nutzer in den USA ihre Muse anrufen oder per Video mit ihr chatten. Auf dem Bildschirm erscheint dabei ein animierter Avatar, der passend zum Gespräch die Miene verzieht, die Lippen synchron bewegt und gestikuliert. Die Funktion läuft in der Muse-App auf dem Smartphone, im Web und auf dem Mac. Angekündigt hat sie Metas Chief AI Officer Alexandr Wang in einem Blogbeitrag und auf X. Gezeigt hatte Meta die Technik zum ersten Mal im September auf seiner Entwicklerkonferenz Connect 2026.
Muse ist laut Android Authority erst seit rund zwei Monaten auf dem Markt und hat seitdem schon zwei neue Modelle namens „Muse Wonder“ bekommen. Der Dienst ist bislang nur in einigen Ländern verfügbar, darunter die USA, Kanada, Japan und Singapur. Die neue Sprach- und Videofunktion gilt vorerst nur in den USA. Einen Zeitplan für weitere Länder hat Meta laut shiftdelete.net nicht genannt. Ob und wann Muse nach Deutschland kommt, ist offen.
So funktioniert der Anruf mit der KI
Gestartet wird ein Gespräch über das Telefonsymbol oben rechts im Muse-Chatfenster. Danach redet man einfach drauflos, statt einen sorgfältig formulierten Prompt zu tippen. Man kann Muse mitten in der Antwort unterbrechen. Laut shiftdelete.net läuft das Gespräch sogar weiter, während Muse im Hintergrund Aufgaben erledigt. Zur Auswahl stehen mehrere Hundert Stimmen.
Wichtig ist: Die KI sieht dich nicht. Anders als bei einem normalen Videotelefonat nutzt Muse nicht die Kamera, um dein Gesicht zu analysieren. Wie der Avatar reagiert, ergibt sich allein aus deiner Stimme und dem Gesprächsverlauf. Er „hört“ sichtbar zu und reagiert schon, während du sprichst.
Drei Ansichten stehen zur Wahl:
- nur Sprache, also ein klassisches Telefonat,
- Avatar neben dem Chat,
- Vollbild für ein Gespräch „von Angesicht zu Angesicht“.
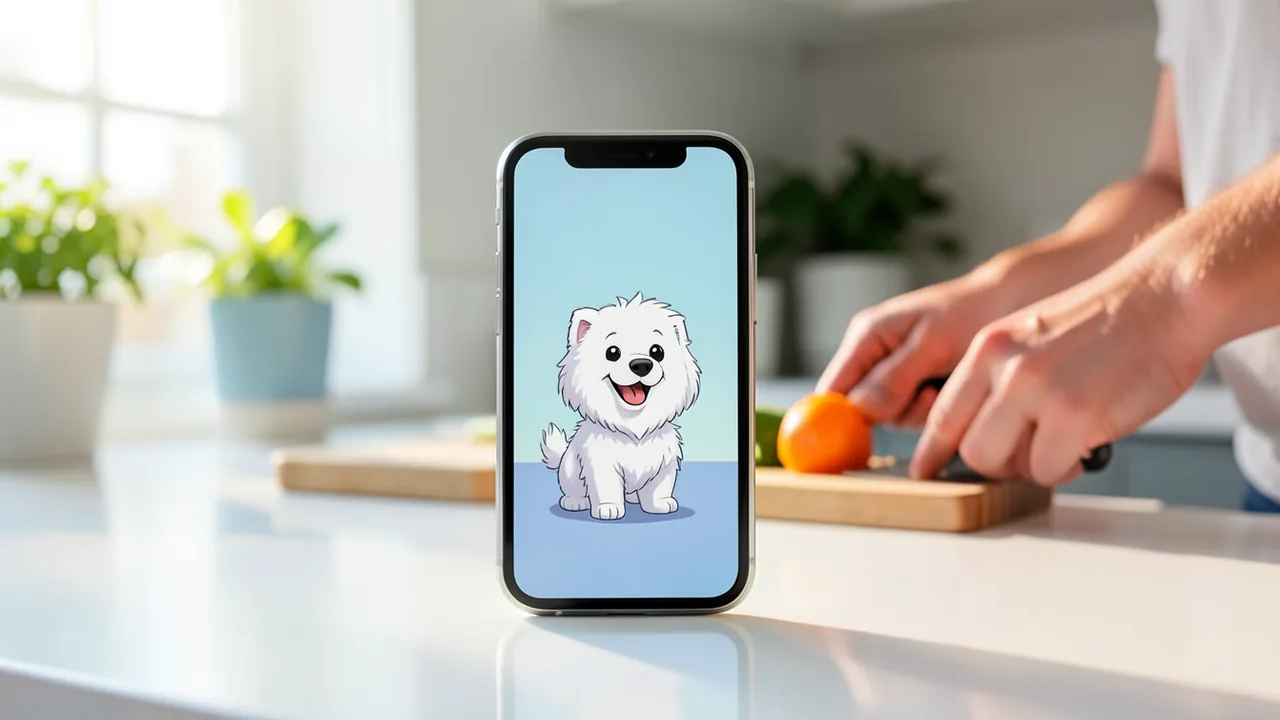
Ab Werk heißt der Avatar „Jolly“, eine niedliche animierte Figur. Man kann ihn aber frei umgestalten, etwa als andere Person, als Tier, als eigene Figur oder sogar als Alltagsgegenstand. Laut Meta lassen sich Figuren nach Referenzbildern oder -videos anlegen. Aussehen und Bewegungen sollen über das ganze Gespräch hinweg gleich bleiben. In seinem Demovideo hatte Wang seine Muse als flauschigen weißen Hund gestaltet und mit ihr gescherzt, ob seine Memes ihn auf der Arbeit in Schwierigkeiten bringen könnten.
Die Technik dahinter: von 120 auf 2 Rechenschritte
Nach Angaben von Meta, über die die koreanische AI Times berichtet, greifen zwei Modelle in einem durchgehenden Datenstrom ineinander:
- Muse Realtime Voice erzeugt sogenannte Sprach-Tokens. Das sind kleine Datenbausteine, die festhalten, was gesagt wird und wie, also Tonfall und Betonung.
- Muse Realtime Avatar bringt diese Tokens mit einem Sprachdecoder und einem Avatar-Modell in Bild und Ton. Stimme, Lippenbewegung und Mimik laufen dadurch synchron.
Das Video selbst erzeugt ein Modell auf Basis eines Diffusion Transformers. Diffusionsmodelle bauen ein Bild aus Rauschen auf und entfernen dieses Rauschen Schritt für Schritt, bis das fertige Bild steht. Normalerweise kostet das viele Rechendurchgänge. Meta setzt deshalb auf Destillation: Ein schnelles „Schüler“-Modell lernt, das Ergebnis eines langsamen „Lehrer“-Modells nachzuahmen. Statt 120 Rechenschritten braucht es nach Metas Angaben nur noch 2.
| Kennzahl (Herstellerangabe) | Wert |
|---|---|
| Auflösung | 448 × 768 Pixel (Hochformat) |
| Bildrate | 25 Bilder pro Sekunde |
| Verzögerung bis zur Antwort | ca. 870 Millisekunden |
| Diffusionsschritte | 2 statt 120 |
| Sitzungen pro Nvidia GB200 | 12 gleichzeitig |
| Kapazität gegenüber Basismodell | 8-fach |
Die Verzögerung von rund 870 Millisekunden misst Meta ab dem Moment, in dem du aufhörst zu sprechen, bis die synchronisierte Antwort aus Bild und Ton beginnt. Eine knappe Sekunde ist für ein Gespräch spürbar, aber noch im erträglichen Rahmen. Bei der Server-Infrastruktur hat Meta mit Nvidia zusammengearbeitet. Eine einzige GB200-GPU soll 12 Videositzungen parallel stemmen, insgesamt sei die Kapazität achtmal so hoch wie beim ursprünglichen Basismodell. Diese Zahlen stammen von Meta selbst, unabhängige Messungen gibt es bisher nicht.
Schutzmaßnahmen: Wasserzeichen und Altersgrenze
In jedes erzeugte Video bettet Meta das unsichtbare Wasserzeichen Video Seal ein. Das ist eine Art digitaler Stempel, den man mit bloßem Auge nicht sieht, der sich aber maschinell auslesen lässt. Er soll erkennbar machen, dass ein Video von der KI stammt, und so Missbrauch erschweren, etwa wenn jemand Mitschnitte als echte Aufnahmen ausgibt. Laut Meta bremst das Wasserzeichen die Echtzeit-Interaktion nicht aus. Muse ist zudem ausschließlich für Menschen ab 18 Jahren freigegeben.
Was als Nächstes kommt: Muse Charm und KI-Brillen
Der Start ist auch eine Vorbereitung auf neue Hardware. Noch vor Jahresende will Meta den Muse Charm herausbringen, ein handtellergroßes Gerät, das India Today mit einem Tamagotchi vergleicht. Auf seinem kleinen Bildschirm soll der eigene Muse-Avatar „wohnen“. Man könnte also mit der KI reden und ihr Aufgaben geben, ohne das Handy hervorzuholen. Auch auf Metas KI-Brillen sollen die Echtzeit-Gespräche nach und nach kommen.
Einordnung
Sprachmodi gibt es bei ChatGPT, Gemini und anderen schon länger. Shiftdelete.net nennt Echtzeit-Sprache deshalb „Pflichtprogramm“ für KI-Agenten. Meta setzt darauf, dass ein reagierendes Gesicht und Aufgaben, die nebenbei im Hintergrund laufen, Muse eher wie einen Begleiter wirken lassen als wie einen Chatbot. Technisch ist die Kombination aus knapp einer Sekunde Verzögerung und flüssigem Video bemerkenswert. Wie gut das außerhalb ausgewählter Demos klappt, muss sich aber erst zeigen. Für Nutzer in Deutschland ist das Ganze vorerst ohnehin nur ein Ausblick.
Kritische Stimmen gibt es auch. Analytics Insight warnt, dass Menschen im gesprochenen Gespräch mit einem freundlichen Gesicht eher mehr über Gesundheit, Beziehungen oder Privates verraten als beim Tippen. Gerade bei einem Konzern wie Meta, der vom Datengeschäft lebt, stellt sich die Frage, wie diese Gespräche gespeichert und genutzt werden. Auch shiftdelete.net nennt die Datenschutz-Voreinstellungen als offenen Punkt. Konkrete Angaben dazu macht Meta in den vorliegenden Quellen nicht. Unklar sind außerdem Nutzungsgrenzen, mögliche Kosten und der Zeitplan für weitere Länder.
Quellen
- AI Times (KR) aitimes.com
- Bing News (en-US) indiatoday.in
- androidauthority.com androidauthority.com
- shiftdelete.net shiftdelete.net
- analyticsinsight.net analyticsinsight.net
- NewsData (japan) news.mynavi.jp
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.