
DeepSeek zeigt „Super-agent“: KI findet Bugs und schickt selbst Fixes
DeepSeek hat die Architektur eines „Super-agent“ vorgestellt, der ohne direkte Anweisung Fehler reproduziert, Lösungen sucht und Pull Requests einreicht. Ein Prototyp-Plugin ist als Open Source auf GitHub verfügbar. Erste Tests zeigen deutlich kürzere Bearbeitungszeiten, aber auch höheren Token-Verbrauch.
Worum es geht
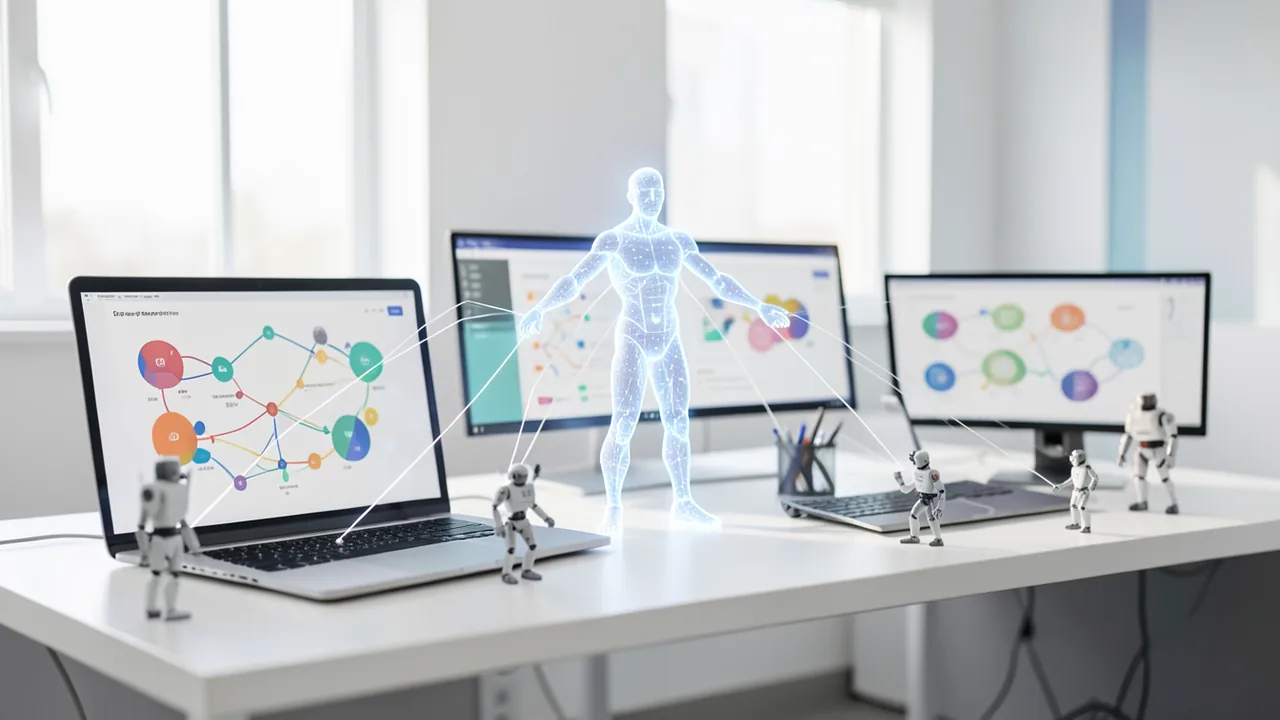
Das DeepSeek-Harness-Team hat am Abend des 31. Oktober 2026 über seinen offiziellen WeChat-Kanal einen Technikartikel mit dem Titel „Super-agent Design Exploration: Toward a More Autonomous Agent System“ veröffentlicht. Darin beschreibt es erstmals systematisch eine Agenten-Architektur für Mehraufgaben- und Teamszenarien. Ein interner Super-agent wird laut DeepSeek schon im Entwicklungsalltag eingesetzt: Er beteiligt sich an der Reproduktion und Behebung von Fehlern, reagiert auf Code-Reviews und treibt sogar Iterationen von DeepSeek Harness selbst voran.
Wichtig zur Einordnung (laut BigGo Finance): Es handelt sich um eine Erkundung auf Ebene der Ingenieurspraxis, nicht um ein eigenständiges, offiziell veröffentlichtes Produkt. Einige Teile sind im Open-Source-Prototyp-Plugin dsh-superagent-prototype umgesetzt (GitHub: deepseek-ai/dsh-superagent-prototype). Das von manchen erwartete „dsh dot“ ist damit nicht gemeint, wie QbitAI anmerkt.
Das Problem: Menschen können nur wenige Sessions im Blick behalten
Die meisten heutigen Agenten arbeiten mit einer Session (einem abgeschlossenen Gesprächs- und Arbeitskontext) als kleinster Einheit; verschiedene Sessions wissen nichts voneinander. Entwickler wechseln aber ständig zwischen Plattformen: Erst wird im Chat eine Lösung besprochen, dann der Code auf GitHub eingereicht, dann nach Kommentaren am Pull Request (PR, einem Änderungsvorschlag am Code) nachgebessert. Bei klassischen Coding-Agenten liegt das in getrennten Sessions, und der Nutzer muss den Überblick halten und Kontext nachreichen.
Nach Beobachtung des Teams kann ein Mensch typischerweise nur 3 bis 5 aktive Sessions gleichzeitig verfolgen. Während Modelle bei Einzelaufgaben besser werden, wird also die menschliche Aufmerksamkeit zur Grenze für die Zahl paralleler Aufgaben. Auch mit CLI- und MCP-Anbindungen bleiben laut Team Probleme: serielle Abarbeitung innerhalb einer Session, vermischter Kontext bei mehreren Aufgaben und Abbrüche, wenn das lokale Gerät offline geht.
Die Architektur: Router, Worker und Abonnements
DeepSeek definiert vier Eigenschaften eines Super-agent: kontinuierlich (Kontext bleibt über Sessions und Plattformen erhalten), effizient (mehrere Aufgaben laufen parallel, lange Aufgaben blockieren nichts), proaktiv (er beobachtet die Umgebung und handelt bei Bedarf) und persistent (läuft dauerhaft und versucht, sich von Fehlern zu erholen).
Dazu gibt es zwei Ebenen:
- Router: ein dauerhaft laufender Koordinator. Er nimmt Nachrichten aus Gruppenchats, GitHub und E-Mail entgegen, verteilt Aufgaben und hält den übergreifenden Kontext.
- Worker: einzelne Agenten-Sessions mit eigenem Kontext und eigenen Werkzeugen, etwa für Fehlerreproduktion, Code-Review oder Feature-Entwicklung. Sie können bei Bedarf Subagenten aufrufen und melden Ergebnisse an den Router, der gesammelt mit dem Nutzer spricht.
Für den Nutzer bleibt es derselbe Assistent, im Hintergrund arbeiten womöglich mehrere Agenten. Um Koordinationsaufwand zu sparen, gibt es einen Abonnement-/Direktdurchleitungs-Mechanismus: Übernimmt ein Worker einen GitHub-PR, gehen spätere Kommentare direkt an ihn, ohne Umweg über den Router. Laut BigGo argumentiert der Artikel, dass der Router vor allem Informationen verstehen und verteilen muss und deshalb ein relativ leichtes Modell genügt, während stärkere Modelle für die eigentliche Ausführung reserviert bleiben.
Ein Beispiel aus dem Team: Im Gruppenchat wird Lösung A beschlossen, später verlangt jemand in einem GitHub-Kommentar Lösung B. Der Super-agent erkennt, dass beides zur selben Arbeit gehört, und passt den Kurs an.
Proaktivität: Filter, spekulative Ausführung, asynchrone Schleife
Chatnachrichten, E-Mails, Kalendererinnerungen, GitHub-Kommentare und CI-Testergebnisse gelten als Trigger. Da die meisten Chatnachrichten keine KI brauchen, filtert das System zweistufig: Zuerst sortieren programmatische Regeln Irrelevantes aus, dann entscheidet ein großes Modell, ob gehandelt wird. Das spart Token.
Dazu kommt spekulative Ausführung, eine Idee aus der Computertechnik: Der Agent versucht im Hintergrund etwas vorab, bevor feststeht, ob das Ergebnis gebraucht wird. Wird im Chat ein Bug besprochen, reproduziert der Super-agent ihn, sucht die Ursache und meldet sich nur, wenn der Fehler existiert und es einen vergleichsweise einfachen Fix gibt; sonst bleibt er still. Ähnlich könnte ein persönlicher Assistent bei einer Terminanfrage vorab Konflikte prüfen, Material sammeln und eine Antwort vorbereiten.
Die asynchrone ReAct-Schleife (ReAct: Muster, bei dem ein Modell abwechselnd nachdenkt und Werkzeuge nutzt) verlagert zeitraubende Werkzeugaufrufe in den Hintergrund, sodass die Session weiter Nachrichten annimmt. Das ist in DeepSeek Harness implementiert, aber noch nicht standardmäßig aktiv.
Für den Dauerbetrieb trennt DeepSeek Rechnen, Zustand und Arbeitsumgebung: Die Ausführungsschleife läuft in der Cloud, der Sitzungszustand liegt in einer Datenbank, Code, Dateien und Toolchain bleiben auf dem Gerät des Nutzers. Lokal läuft nur ein schlanker Daemon (Hintergrunddienst). Geht das Gerät kurz offline, kann die Arbeit danach weitergehen. Ein unabhängiger Watchdog fungiert als KI-Aufseher: Er prüft, ob Aufgaben vorankommen oder in Endlosschleifen hängen, und versucht Reparaturen.
Messwerte
Getestet wurde mit simulierten Chat- und GitHub-CI-Nachrichtenströmen: etwa 300 Nachrichten pro Durchlauf, davon rund 20 echte Arbeitsaufträge, je fünf Wiederholungen, Vergleich mit einem klassischen Ansatz aus einer Session plus Subagent.
| Kennzahl | Super-agent | Klassisch (neutraler Prompt) |
|---|---|---|
| Bearbeitungszeit, Median | 12,4 Min. | nicht genannt |
| Bearbeitungszeit, 95. Perzentil | 15,7 Min. | 29,5 Min. |
| Gelesene Cache-Tokens (ohne Durchleitung) | 31,77 Mio. | 23,23 Mio. |
Der Unterschied kommt laut BigGo vor allem aus der Aufgabenverteilung: Unter neutralem Prompt rief das Modell in fünf Läufen kein einziges Mal einen Subagenten auf und wurde im Hauptdialog ständig von neuen Nachrichten unterbrochen. Der Preis: Ohne Event-Durchleitung stiegen Router-Entscheidungen um etwa 30 %, die Cache-Lese-Tokens um etwa 37 %. Steigt die Ereignisrate von etwa 1 auf 40 pro Minute, wächst die Latenz einer Einzelanfrage laut Team nur von 2,5 auf 3,9 Sekunden, weil der Router Nachrichten bündelt. Das Team betont, dass synthetische Nachrichten und simulierte Werkzeuge verwendet wurden; echte Codequalität wurde nicht bewertet.
Hintergrund: DeepSeek Harness
DeepSeek Harness (dsh) ist laut InfoQ eine Open-Source-Laufzeitumgebung unter MIT-Lizenz für autonome Agenten, als Developer Preview veröffentlicht. Sie basiert auf dem Meta-Framework Cordis und nutzt eine Micro-Kernel-Architektur: Modelladapter, Werkzeugregister, Sandboxes, Sitzungszustand, Event-Verteiler und Oberflächen sind austauschbare Plugins. Ein Append-only-Ereignisprotokoll hält jede Nachricht und jeden Werkzeugaufruf fest. Version 0.1 hat vier Modi: Standard, Code, Minimal und Creator. InfoQ weist darauf hin, dass sich Erweiterungsschnittstellen noch ändern können.
Am Rande: Geeky Gadgets berichtet über DeepSeek-4-Modelle (Pro mit 1,6 Billionen, Flash mit 284 Milliarden Parametern, 1 Mio. Token Kontext). Das ist ein anderes Thema und hier nur Kontext.
Offene Hürden
Laut BigGo nennt DeepSeek selbst offene Probleme: Langzeitgedächtnis über Wochen oder Monate, Sicherheit und Datenschutz (Prompt-Injection oder Serverangriffe könnten Repositories, sensible Daten und lokale Zugangsdaten gefährden) sowie neue Bedienkonzepte, wenn viele Aufgaben parallel laufen – etwa wie Nutzer Fortschritt sehen, eingreifen und welche Schritte manuell freigegeben werden müssen. Das Team räumt ein, keine völlig neue Theorie zu liefern, sondern klassische Systemideen (Scheduling, Cache-Management, Event-Steuerung, Trennung von Speicher und Rechnen) auf Agenten zu übertragen.
Einordnung
Die Veröffentlichung ist vor allem ein Architekturpapier mit Prototyp, kein Produkt. Interessant ist sie für Entwickler, die Agenten-Systeme bauen: Sie zeigt, wie sich der Engpass „menschliche Aufmerksamkeit“ durch Router/Worker-Aufteilung mildern lässt. Die Zahlen stammen vom Hersteller selbst, aus einem kleinen Test (5 Läufe) mit synthetischen Daten; zudem war der Vergleichsansatz unter neutralem Prompt besonders schwach, weil er keine Subagenten nutzte. Ob das in echten Teams mit realer Codequalität und vertretbaren Kosten funktioniert, ist offen – ebenso die Sicherheitsfragen bei einem Agenten, der dauerhaft externe Nachrichten liest und auf Geräte zugreift.
Videos zum Thema
Quellen
- QbitAI 量子位 (CN) qbitai.com
- geeky-gadgets.com geeky-gadgets.com
- finance.biggo.com finance.biggo.com
- infoq.com infoq.com
- Bing News (en-US) phemex.com
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.