
Tencent Hy-SimulMT: Simultanübersetzer Chinesisch–Englisch mit 3 Sekunden Verzögerung
Tencent hat mit Hy-SimulMT ein offenes Modell veröffentlicht, das gesprochenes Chinesisch und Englisch live übersetzt, noch während die Person spricht. Die Verzögerung liegt laut Tencent bei rund drei Sekunden, die Qualität soll mit erfahrenen Dolmetschern mithalten. Die Gewichte stehen unter Apache-2.0 bereit, die Benchmarks stammen aber ausschließlich von Tencent selbst.
Worum es geht
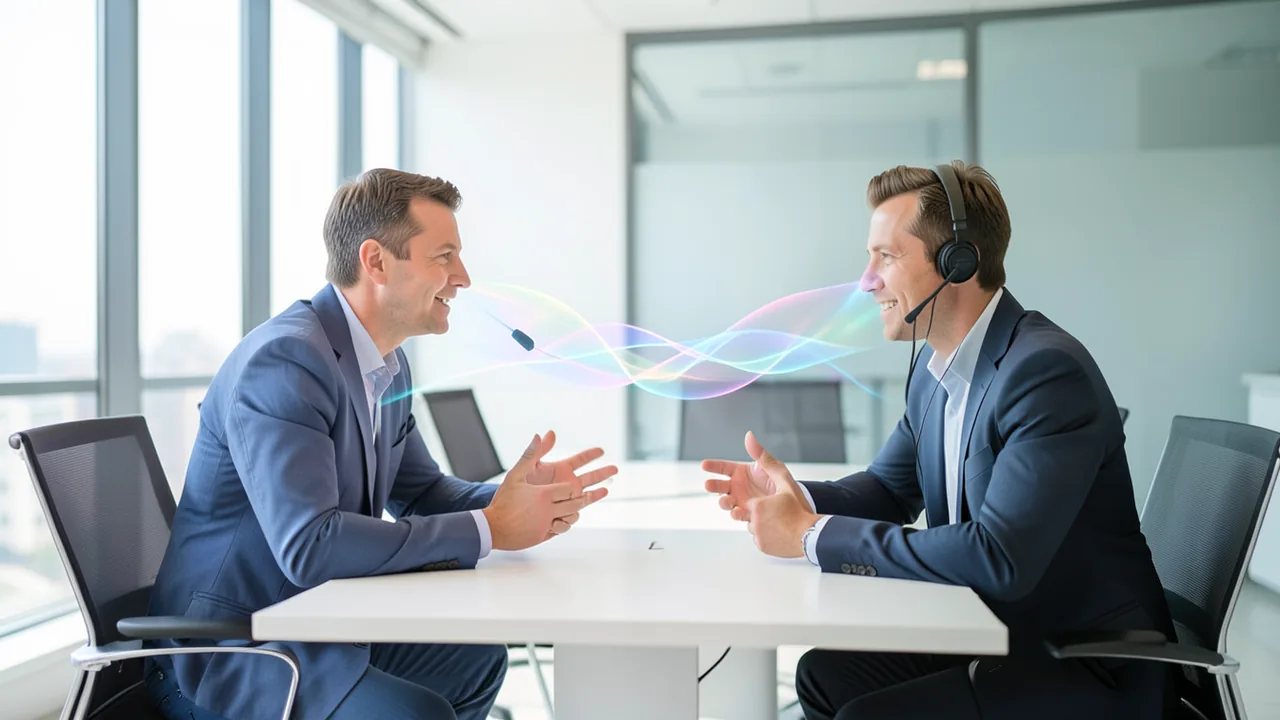
Tencent Hunyuan hat Hy-SimulMT veröffentlicht, ein Modell für simultanes Übersetzen von Sprache zwischen Chinesisch und Englisch, in beide Richtungen. „Simultan“ heißt: Das Modell nimmt fortlaufend Audio auf und übersetzt, während die Person noch spricht – wie ein Dolmetscher im Konferenzraum, nicht wie ein Übersetzer, der erst den ganzen Satz abwartet. Es liefert übersetzten Text und, mit angeschlossenem Sprachausgabe-Dienst, auch gesprochene Sprache, auf Wunsch mit der geklonten Stimme des Sprechers.
Die Modellkarte auf Hugging Face nennt als Veröffentlichungsdatum den 26. Oktober 2026. Laut dem Blog OrcaRouter tauchten die sechs Repositories bereits am 22. Oktober auf; dort ist auch von einer sehr leisen Veröffentlichung ohne Pressemitteilung und ohne Paper die Rede. Dass das Modell zeitlich zur APEC-Leaderstagung in Shenzhen passt, bei der Tencents Hy Translate App als offizielles KI-Übersetzungstool genannt wird, ist ausdrücklich eine Vermutung von OrcaRouter, keine Aussage von Tencent.
Was im Paket steckt
Die Familie umfasst sechs Checkpoints:
| Variante | Ausgabe | Format |
|---|---|---|
| Hy-SimulMT-30B-A3B | nur Übersetzung | BF16, FP8, GGUF |
| Hy-SimulMT-30B-A3B-Interleave | erkannter Quelltext plus Übersetzung | BF16, FP8, GGUF |
Laut OrcaRouter handelt es sich um ein Mixture-of-Experts-Modell (MoE – viele spezialisierte Teilnetze, von denen pro Token nur einige aktiv sind) mit 48 Schichten, 128 Experten, acht gerouteten plus einem gemeinsamen Experten pro Token. Insgesamt sind es etwa 30,4 Milliarden Parameter (die beim Training gelernten Stellschrauben). Das „A3B“ im Namen erklärt Tencent nicht; die Rechnung aus der Konfiguration ergibt grob 3 Milliarden aktive Parameter – das ist eine Schätzung von OrcaRouter, keine Herstellerangabe. Der Audio-Eingang arbeitet mit 16 kHz und verarbeitet Fenster von höchstens 30 Sekunden. Die Lizenz ist Apache-2.0, Drittkomponenten behalten ihre eigenen Bedingungen.
Dazu gibt es auf GitHub zwei Werkzeuge: SimulInfer (Inferenzdienst mit Weboberfläche, Datei-Upload, Mikrofon und WebSocket) und SimulTrain (Training auf Basis der veröffentlichten Checkpoints). Sprachausgabe und Stimmklonen brauchen einen separat konfigurierten TTS-Dienst (Text-to-Speech). „Speech-to-Speech“ beschreibt also ein System rund um das Modell, nicht ein einzelnes Modell, das Audio ausgibt.
Zahlen und Benchmarks
Das zentrale Maß ist die StreamLAAL – die durchschnittliche Verzögerung zwischen gesprochener Quelle und übersetzter Ausgabe im Streaming-Betrieb (niedriger ist besser). Sie ist nicht die Zeit bis zur ersten Sprachausgabe. Auf dem Langaudio-Benchmark RealSI erreicht Hy-SimulMT laut Tencent etwa 3 Sekunden, den niedrigsten Wert im Vergleich. Der GEMBA-Score (ein automatisiertes Qualitätsmaß für Übersetzungen) liegt über den verglichenen Open-Source-Modellen und vier von fünf kommerziellen APIs. Welche API vorn liegt, nennt die Karte nicht.
Auf kurzen Audioclips (höher ist besser):
| Modell | FLEURS | CoVoST2 | ACL6060 | RealSI-Sentence |
|---|---|---|---|---|
| Hy-SimulMT | 90,3 | 75,5 | 81,2 | 84,7 |
| Qwen3.8-LiveTranslate | 88,4 | 82,1 | 80,5 | 84,4 |
| Gemini3.5-LiveTranslate | 92,4 | 74,4 | 82,6 | 82,2 |
| Seed-LiveInterpret2.0 | 85,8 | 67,7 | 74,8 | 80,0 |
| GPT-Realtime-Translate | 77,7 | 50,8 | 76,4 | 76,7 |
| SeamlessStreaming | 72,8 | 60,9 | 49,8 | 56,9 |
Tencent hebt hervor, dass das Modell unter den Open-Source-Modellen bei FLEURS, ACL6060 und RealSI-Sentence vorn liegt und bei RealSI-Sentence mit 84,7 den Höchstwert aller Systeme hat. OrcaRouter weist darauf hin, dass CoVoST2 die schwächste Spalte ist (6,6 Punkte hinter Qwen) und bei FLEURS Gemini 2,1 Punkte vorn liegt.
Vergleich mit menschlichen Dolmetschern
Tencent ließ 18 chinesische und englische Aufnahmen (je rund 6 Minuten, online ab September 2026 erschienen, zehn Themenfelder von Medizin bis Recht) von sechs Dolmetschern übersetzen: drei mit CATTI-Level-1-, drei mit Level-2-Zertifikat. Pro Level zählte der beste Dolmetscher. Ergebnis laut Tencent: Qualität auf Augenhöhe mit Experten, oft bei geringerer Latenz. Tencent schränkt selbst ein, dass dies nur für diese Proben und Dolmetscher gilt und nichts über Sprachqualität oder Stimmähnlichkeit aussagt. OrcaRouter merkt an, dass der Vergleich mit dem jeweils besten Dolmetscher bei der Qualität ein hoher Maßstab ist, bei der Latenz aber nicht den Durchschnitt abbildet.
Zwei chinesische Hochschulexperten loben das System: Das Modell beginne zu sprechen und korrigiere sich danach, ähnlich wie Dolmetscher bei Selbstkorrekturen. Es sei auf dem Weg von „Verständnishilfe“ zu „brauchbarer Kommunikation“ in risikoarmen Situationen. Bei strenger Haftung oder wichtigen Entscheidungen bleiben menschliche Dolmetscher laut Tencent wichtig.
Was du zum Ausprobieren brauchst
- Offizieller Weg: Linux, Python 3.12+, Git, NVIDIA-GPU und vLLM ab 0.31 mit HYV3ForCausalLM-Unterstützung. Der Befehl
bash deploy.sh --install-server --model tencent/Hy-SimulMT-30B-A3B-Interleaverichtet alles ein und startet Modell (Port 8800) und Weboberfläche (Port 8080). - Speicher: Tencent nennt keine Mindestanforderung. Nach OrcaRouters Rechnung wiegt BF16 rund 61 GB, eine 80-GB-Karte wäre die realistische Untergrenze; die FP8- und GGUF-Varianten (Q4/Q8) machen kleinere Karten plausibel. Das sind Schätzungen.
- llama.cpp/Ollama/LM Studio: Die Unterstützung ist noch nicht im offiziellen llama.cpp gemergt. Tencent empfiehlt, auf ein Release zu warten. Es gibt eine Bridge (
serve_llamacpp.py, Port 8094) für einen bereits laufenden audiofähigen llama.cpp-Server. - Mikrofon aus der Ferne braucht HTTPS. Sprachausgabe braucht einen eigenen TTS-Dienst. Alternativ gibt es die Hy Translate App für Android und iOS.
Einordnung
Ein offen herunterladbarer Simultanübersetzer mit rund drei Sekunden Verzögerung ist ungewöhnlich; bisher sind vergleichbare Systeme meist kommerzielle APIs. Für Entwickler, die Live-Untertitel oder Meeting-Übersetzung lokal und ohne Cloud betreiben wollen, ist das interessant – allerdings nur für Chinesisch und Englisch.
Kritisch zu sehen: Alle Zahlen stammen von Tencent, eine unabhängige Prüfung fehlt, ebenso ein technischer Bericht. Der Dolmetschervergleich ist klein. Die Modellmetadaten markieren laut OrcaRouter 36 Sprachen, dokumentiert ist aber nur Chinesisch–Englisch; ob weitere Sprachen für Sprache funktionieren, ist unbestätigt. Es gibt keine gehostete API und keinen Preis. Zudem hängt der Praxiseinsatz an der noch fehlenden llama.cpp-Unterstützung und an der Hardware: Wer keine große NVIDIA-Karte hat, wartet am besten auf die Community-Unterstützung.
Quellen
- r/LocalLLaMA huggingface.co
- Google News (US) orcarouter.ai
- Google News (BR) orcarouter.ai
Selbst ausprobieren: Hy-SimulMT-30B-A3B
Schritt für Schritt erklärt, auch ohne Vorkenntnisse – auf deinem Rechner oder kostenlos im Browser.
Was kann ich damit machen?
Das Modell hört Chinesisch oder Englisch und übersetzt es live in die jeweils andere Sprache, noch während gesprochen wird. Über die mitgelieferte Weboberfläche kannst du Audiodateien hochladen oder das Mikrofon nutzen und bekommst Text. Mit einem zusätzlich eingerichteten TTS-Dienst gibt es auch gesprochene Übersetzung mit geklonter Stimme.
Für wen lohnt es sich?
Interessant für Entwickler und Bastler mit starker NVIDIA-GPU, die Live-Übersetzung für Meetings oder Vorträge selbst betreiben wollen. Weniger sinnvoll für alle, die andere Sprachen als Chinesisch/Englisch brauchen oder nur einen einfachen Ollama-Chat erwarten.
Was dein Rechner braucht
Für den offiziellen Weg über vLLM nimm die FP8-Variante (Hy-SimulMT-30B-A3B oder -Interleave) auf einer großen NVIDIA-Karte; BF16 braucht grob 61 GB für die Gewichte. Die GGUF-Varianten (Q4_K_M, Q8_0) sind für kleinere Hardware gedacht, laufen aber erst mit einer llama.cpp-Version, die das Modell unterstützt. 'Interleave' zeigt zusätzlich den erkannten Quelltext, die Standardvariante nur die Übersetzung.
- Offizieller Weg: Linux, Python 3.12+, NVIDIA-GPU mit CUDA-Treiber und vLLM ab 0.31.
- BF16 benötigt grob 61 GB nur für Gewichte (Schätzung von OrcaRouter), eine einzelne 80-GB-Karte ist die realistische Untergrenze; FP8 und GGUF senken das.
- Eine Tencent-Mindestangabe für VRAM gibt es nicht; 20 GB für 4-bit ist eine grobe Schätzung.
- llama.cpp-Unterstützung ist noch nicht im offiziellen Repo; auf Mac/CPU also vorerst abwarten.
- Der Audio-Eingang verarbeitet Fenster von maximal 30 Sekunden bei 16 kHz.
Wie finde ich heraus, was mein Rechner hat?
- Windows: Strg + Umschalt + Esc drücken → Task-Manager → Reiter Leistung → links GPU anklicken. Unten steht Dedizierter GPU-Speicher (das ist dein VRAM). Den Arbeitsspeicher findest du unter Arbeitsspeicher.
- Mac: Apfel-Menü oben links → Über diesen Mac. Dort stehen Chip (z. B. M2) und Speicher (z. B. 16 GB). Bei Apple-Chips teilen sich Grafik und Prozessor diesen Speicher.
- Linux: Im Terminal
nvidia-smieingeben (zeigt Grafikkarte und Speicher) undfree -hfür den Arbeitsspeicher.
Anleitung
Dieses Modell läuft mit einem eigenen Programm seiner Entwickler (Tencent-Hunyuan/Hy-SimulMT auf GitHub). Die Befehle unten stammen aus der Model Card und der Anleitung der Entwickler.
Windows 10 / 11
Windows 10 / 11: nicht offiziell getestet. Die Quelle nennt Windows nicht. Das Modell braucht sehr viel Grafikspeicher (ca. 74 GB). Das schaffen normale PCs nicht. Weich auf die Hy Translate App (Android/iOS) aus oder auf die kleineren Varianten FP8 oder GGUF aus.
- Voraussetzungen prüfen. Du brauchst Python 3 (am besten eine aktuelle Version), Git und eine NVIDIA-Grafikkarte mit aktuellem Treiber. Außerdem brauchst du etwa 65 GB freien Speicherplatz. Die Quelle nennt keine genauen Versionen.
python --version git --version nvidia-smi - Programm herunterladen. Hol dir das Programm (SimulInfer) von GitHub in einen neuen, leeren Ordner.
git clone https://github.com/Tencent-Hunyuan/Hy-SimulMT cd Hy-SimulMT - Umgebung anlegen. Eine virtuelle Umgebung hält die Pakete getrennt vom Rest deines PCs. Aktiviere sie danach.
python -m venv .venv .venv\Scripts\Activate.ps1 - Pakete installieren. Installiere zuerst das Download-Werkzeug. Die weiteren Pakete für den Dienst stehen in der README des GitHub-Projekts. Installiere sie genau so, wie dort beschrieben.
pip install -U huggingface_hub - Modell herunterladen. Der Download ist 60,8 GB groß und dauert lange. Er landet im Ordner model.
hf download tencent/Hy-SimulMT-30B-A3B --local-dir model - Dienst starten und testen. Starte den SimulInfer-Dienst mit dem Startbefehl aus der README des GitHub-Projekts und zeige ihm den Ordner model. Dieser Befehl stand nicht in unserer Quelle. Für gesprochene Ausgabe und Stimmklonen brauchst du zusätzlich einen eingerichteten TTS-Dienst (Text-zu-Sprache).
- Ergebnis. Das Modell liegt lokal im Ordner model. Der Übersetzungsdienst läuft, sobald du ihn nach der GitHub-README startest, und übersetzt Sprache zwischen Chinesisch und Englisch.
macOS
macOS: nicht offiziell getestet. Die Quelle nennt macOS nicht, und es ist keine Apple-Unterstützung erwähnt. Mit etwa 74 GB Speicherbedarf ist das Modell für die meisten Macs zu groß. Probiere stattdessen die Hy Translate App (iOS) oder die GGUF-Variante.
- Voraussetzungen prüfen. Du brauchst Python 3, Git (kommt mit den Xcode-Tools) und etwa 65 GB freien Speicherplatz. Die Quelle nennt keine genauen Versionen und keine Mac-Unterstützung.
python3 --version git --version xcode-select --install - Programm herunterladen. Hol dir das Programm (SimulInfer) von GitHub in einen neuen, leeren Ordner.
git clone https://github.com/Tencent-Hunyuan/Hy-SimulMT cd Hy-SimulMT - Umgebung anlegen. Eine virtuelle Umgebung hält die Pakete getrennt vom Rest deines Macs. Aktiviere sie danach.
python3 -m venv .venv source .venv/bin/activate - Pakete installieren. Installiere zuerst das Download-Werkzeug. Die weiteren Pakete für den Dienst stehen in der README des GitHub-Projekts. Installiere sie genau so, wie dort beschrieben.
pip install -U huggingface_hub - Modell herunterladen. Der Download ist 60,8 GB groß und dauert lange. Er landet im Ordner model.
hf download tencent/Hy-SimulMT-30B-A3B --local-dir model - Dienst starten und testen. Starte den SimulInfer-Dienst mit dem Startbefehl aus der README des GitHub-Projekts und zeige ihm den Ordner model. Dieser Befehl stand nicht in unserer Quelle. Für gesprochene Ausgabe und Stimmklonen brauchst du zusätzlich einen eingerichteten TTS-Dienst.
- Ergebnis. Das Modell liegt lokal im Ordner model. Der Übersetzungsdienst läuft, sobald du ihn nach der GitHub-README startest, und übersetzt Sprache zwischen Chinesisch und Englisch.
Linux
Linux: nicht offiziell getestet. Die Quelle nennt kein Betriebssystem ausdrücklich. Linux mit NVIDIA-Grafikkarte ist der übliche Weg für solche Modelle. Du brauchst aber ca. 74 GB Grafikspeicher, zum Beispiel eine 80-GB-Karte. Kleiner geht es mit den Varianten FP8 oder GGUF.
- Voraussetzungen prüfen. Du brauchst Python 3 (am besten eine aktuelle Version), Git, einen aktuellen NVIDIA-Treiber und etwa 65 GB freien Speicherplatz. Die Quelle nennt keine genauen Versionen.
python3 --version git --version nvidia-smi - Programm herunterladen. Hol dir das Programm (SimulInfer) von GitHub in einen neuen, leeren Ordner.
git clone https://github.com/Tencent-Hunyuan/Hy-SimulMT cd Hy-SimulMT - Umgebung anlegen. Eine virtuelle Umgebung hält die Pakete getrennt vom Rest des Systems. Aktiviere sie danach.
python3 -m venv .venv source .venv/bin/activate - Pakete installieren. Installiere zuerst das Download-Werkzeug. Die weiteren Pakete für den Dienst stehen in der README des GitHub-Projekts. Installiere sie genau so, wie dort beschrieben.
pip install -U huggingface_hub - Modell herunterladen. Der Download ist 60,8 GB groß und dauert lange. Er landet im Ordner model.
hf download tencent/Hy-SimulMT-30B-A3B --local-dir model - Dienst starten und testen. Starte den SimulInfer-Dienst mit dem Startbefehl aus der README des GitHub-Projekts und zeige ihm den Ordner model. Dieser Befehl stand nicht in unserer Quelle. Für gesprochene Ausgabe und Stimmklonen brauchst du zusätzlich einen eingerichteten TTS-Dienst.
- Ergebnis. Das Modell liegt lokal im Ordner model. Der Übersetzungsdienst läuft, sobald du ihn nach der GitHub-README startest, und übersetzt Sprache zwischen Chinesisch und Englisch.
Das kannst du ausprobieren
Lade eine englische Konferenz-Aufnahme (audio.wav) hoch und wähle die Richtung en-zh.Sprich über das Mikrofon einen kurzen Vortrag auf Chinesisch und wähle zh-en, um die Live-Übersetzung zu beobachten.Teste mit der Interleave-Variante eine Interview-Aufnahme, um Quelltext und Übersetzung nebeneinander zu sehen.Wenn es hakt
vLLM muss mindestens Version 0.31 mit HYV3ForCausalLM-Unterstützung sein, ältere Versionen starten das Modell nicht.
Erneutes Ausführen von deploy.sh mit --install-server installiert Abhängigkeiten neu; bei eigener vLLM/CUDA-Umgebung stattdessen die Option --server-python nutzen.
Mikrofonzugriff von einem anderen Rechner funktioniert nur über HTTPS.
Sprachausgabe und Stimmklonen funktionieren nur mit einem konfigurierten TTS-Dienst.
Ein belegter Port führt zum Startfehler; mit --port oder --model-port einen anderen wählen.
„out of memory“, Absturz oder der Rechner hängt
Das Modell ist zu groß für deinen Grafikspeicher. Nimm eine kleinere Variante aus der Tabelle oben und schließe andere Programme, vor allem Spiele und Browser mit vielen Tabs.
Es läuft, aber extrem langsam
Wahrscheinlich rechnet der Prozessor statt der Grafikkarte. Bei Ollama zeigt ollama ps in der Spalte PROCESSOR, wie viel auf der GPU läuft. Steht dort „100% CPU“, Grafiktreiber aktualisieren oder eine kleinere Variante nehmen, die komplett in den Grafikspeicher passt.
„ollama“ bzw. „python“ wird nicht gefunden
Das Eingabefenster schließen und neu öffnen, damit es das frisch installierte Programm kennt. Bei Python unter Windows: neu installieren und das Häkchen Add python.exe to PATH setzen.
Windows: „Die Ausführung von Skripts ist auf diesem System deaktiviert“
Das Skript genau mit dem Befehl oben starten: powershell -ExecutionPolicy Bypass -File try_windows.ps1. Das erlaubt die Ausführung nur dieses einen Mal.
Fehlermeldung beim Laden des Modells (Version, „trust_remote_code“, unbekannte Architektur)
Ganz neue Modelle brauchen oft die neueste Programmversion. Bei Ollama: Ollama aktualisieren. Bei Python: pip install -U transformers in der aktivierten Umgebung. Die Model Card nennt meist die genaue Version.
Skripte und Notebook erzeugt Tokenstrom automatisch. Bitte vor dem Ausführen kurz ansehen – sie sind lesbarer Klartext. Lizenz des Modells beachten: apache-2.0.
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.