
Winziges 4B-Modell baut 3D-Assets für Godot als GLB-Export
Der Entwickler CCORE hat eine frühe Vorschau von Qwen3.5-4B-GLB-3D-Coder veröffentlicht. Das kleine Modell schreibt aus einem kurzen Satz eine Three.js-Szene, die sich als GLB-Datei exportieren und in Godot importieren lässt. Es läuft lokal, ist aber noch ein unfertiger Zwischenstand.
Worum es geht
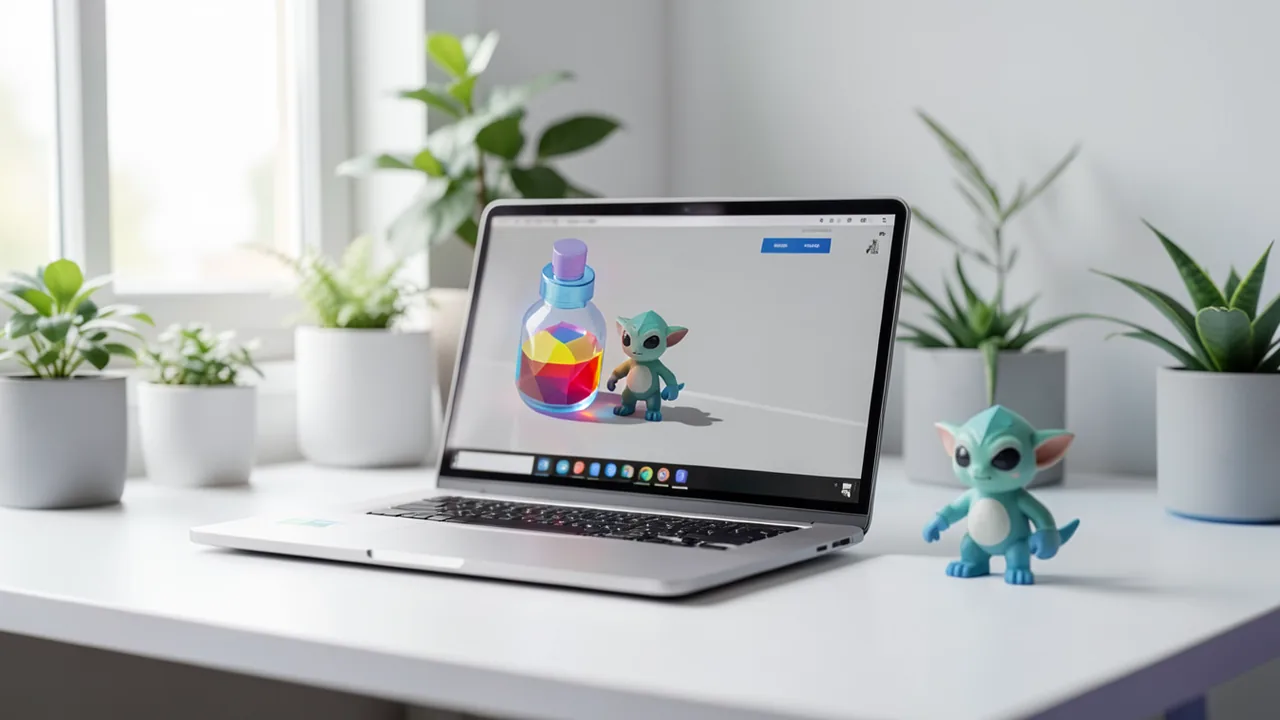
Der Entwickler CCORE hat auf Hugging Face einen frühen Vorschau-Checkpoint namens Qwen3.5-4B-GLB-3D-Coder veröffentlicht und bei r/LocalLLaMA vorgestellt. Es ist ein kleines Coding-Modell mit 4 Milliarden Parametern, das auf Qwen3.5-4B aufbaut. Es ist ausdrücklich keine offizielle Qwen-Veröffentlichung. Das Modell schreibt Code für Three.js-Szenen (eine JavaScript-Bibliothek für 3D-Grafik im Browser) und bringt dabei eine Exportfunktion für GLB-Dateien mit. GLB ist ein kompaktes Binärformat für 3D-Modelle, das Spiel-Editoren wie Godot direkt importieren können.
CCORE knüpft an sein früheres 3D-Coding-Modell an. Nach dessen Veröffentlichung hätten viele gefragt, ob man damit Assets für eigene Spiele erzeugen könne. Daraufhin trainierte er eine Version, die genau darauf ausgerichtet ist.
So funktioniert der Ablauf
Du gibst dem Modell einen Systemprompt (die Grundanweisung, die vor deiner eigentlichen Bitte steht) und danach eine kurze Anfrage als Nutzernachricht. Das Modell antwortet mit einer vollständigen, eigenständigen HTML-Datei. Öffnest du sie im Browser, siehst du das Asset und kannst über einen Button „Export GLB“ eine funktionierende GLB-Datei herunterladen. Braucht das Objekt eine Animation, soll das Modell sie einbauen und in die GLB-Datei übernehmen; sonst bleibt das Asset statisch. Die GLB-Datei importierst du dann in Godot oder einen anderen Editor.
Der Systemprompt aus der Modellkarte lautet sinngemäß: Erzeuge Spiel-Assets für den Godot-Editor, der GLB-Dateien nutzt; baue das Gewünschte als hochwertiges Low-Poly-Asset nur mit Three.js in einer einzigen HTML-Datei; die Seite muss das Asset zeigen und einen Export-Button enthalten; Animationen werden bei Bedarf ergänzt und mit exportiert.
Beispiele und Einstellungen
Die Prompts müssen laut CCORE nicht kompliziert sein. Gut funktioniert haben kurze englische Anfragen wie „Create a mana potion.“, „Build a goblin.“ oder „Build a weathered frontier medic station.“. Für mehr Kontrolle kann man ausführlicher werden, etwa: „Create a low-poly desert merchant in a self-contained Three.js HTML scene, with a button to export the character as a GLB file for use in Godot.“ Auf der Modellkarte und im Reddit-Video zeigt der Entwickler Screenshots von Assets im Browser und nach dem Import in Godot.
Die aktuell genutzten Sampling-Einstellungen (sie steuern, wie zufällig das Modell Wörter wählt) sind:
| Parameter | Wert |
|---|---|
| Temperature | 0,8 |
| Top K | 40 |
| Top P | 0,95 |
| Min P | 0,0 |
CCORE nennt sie einen Startpunkt und lädt zum Ausprobieren anderer Kombinationen ein.
Status und Grenzen
Das ist der erste funktionsfähige Checkpoint. Das Training läuft laut Entwickler noch und soll voraussichtlich am Abend nach dem Beitrag (UTC) enden, abhängig vom Fortschritt. Danach will er die vollständigen Safetensors-Gewichte und den Trainingsdatensatz veröffentlichen, so wie beim Vorgängermodell. Bekannte Einschränkungen: Manche Generierungen brauchen einen weiteren Versuch oder eine kleine Code-Korrektur, englische Prompts funktionieren besser als andere Sprachen, und das Verhalten kann sich mit späteren Checkpoints ändern. Alle Qualitätsaussagen stammen vom Entwickler selbst; unabhängige Tests oder Benchmarks liegen nicht vor.
Was du zum Ausprobieren brauchst
Mit 4 Milliarden Parametern ist das Modell klein. Die Q4_K_M-Datei sollte grob 3 bis 4 GB belegen, Q8_0 etwa das Doppelte (eigene Schätzung, die Quelle nennt keine Dateigrößen). Eine Grafikkarte mit 4 bis 6 GB VRAM reicht für Q4 wahrscheinlich; auch CPU-Betrieb mit 8 GB Arbeitsspeicher ist denkbar, wenn auch langsamer. Die Modellkarte nennt llama.cpp, Ollama, LM Studio, Jan, vLLM und weitere Programme. Für Ollama genügt ollama run hf.co/ccore/Qwen3.5-4B-GLB-3D-Coder:Q4_K_M. Das generierte HTML öffnest du in einem normalen Browser, für den Import brauchst du Godot.
Weiterer Kontext: Godot und 3D-Assets
Die weiteren Quellen zeigen, wie man in Godot sonst an Assets kommt. Laut vr.org hat Blendkit (früher BlenderKit) Ende Juli ein Godot-Plugin veröffentlicht, das rund 22.000 kostenlose Modelle plus Materialien und HDRIs erreichbar macht. Das Plugin ist laut vr.org alpha, läuft nicht auf macOS, und viele .blend-Dateien importieren fehlerhaft; eine GLTF-Option umgeht Blender. Das zeigt, dass GLB/GLTF der robustere Weg in Godot ist. Das Godot Pixel Renderer von Jude Janitha (laut Digital Production MIT-lizenziert) wandelt animierte GLB-/GLTF-Dateien in Pixel-Art-Sequenzen um, wäre also ein möglicher Folgeschritt für mit diesem Modell erzeugte Assets. Ein direkter Zusammenhang mit CCOREs Modell wird in diesen Quellen nicht hergestellt.
Einordnung
Die Idee ist praktisch: Statt Meshes direkt zu erzeugen, schreibt ein kleines Sprachmodell Code, der das Objekt aus einfachen Formen zusammensetzt. Das passt zu Low-Poly-Stilen, Prototypen und Platzhaltern. Man sollte aber keine fotorealistischen oder detailreichen Ergebnisse erwarten, und Animationen sind vermutlich einfach gehalten. Kritisch: Es ist ein Zwischenstand, es gibt keine Benchmarks, die Aussagen zur Zuverlässigkeit sind Eigenangaben, und Lizenz und Gewichte im Safetensors-Format fehlen noch. Für Hobby-Entwickler mit Godot ist es dennoch ein günstiger Versuch, weil es lokal und kostenlos läuft.
Quellen
- Reddit: lokale Modelle & Bild-KI huggingface.co
- vr.org vr.org
- digitalproduction.com digitalproduction.com
Selbst ausprobieren: Qwen3.5-4B-GLB-3D-Coder
Schritt für Schritt erklärt, auch ohne Vorkenntnisse – auf deinem Rechner oder kostenlos im Browser.
Was kann ich damit machen?
Das Modell schreibt aus einer kurzen Beschreibung eine komplette HTML-Datei mit einer Three.js-Szene. Darin siehst du dein Objekt, etwa einen Manatrank, einen Goblin oder eine Krankenstation, und kannst es per Button als GLB-Datei herunterladen. Diese Datei lässt sich in Godot und andere Editoren importieren. Das Ergebnis ist Low-Poly, also eher Prototyp- und Platzhalter-Qualität als fertige Spielgrafik. Laut Entwickler klappen die meisten Versuche sofort, einige brauchen einen Retry oder eine kleine Code-Korrektur. Englische Prompts funktionieren am besten. Es ist ein früher Checkpoint, der sich noch ändern kann. Mit nur 4 Milliarden Parametern läuft es auf Durchschnitts-Hardware, ersetzt aber keine großen Modelle oder Modeling-Software.
Für wen lohnt es sich?
Interessant für Hobby-Spieleentwickler, Game-Jam-Teilnehmer und Tüftler, die schnell Platzhalter-Assets für Godot oder andere Engines brauchen. Weniger geeignet, wenn du detailreiche, produktionsreife Modelle oder zuverlässige deutsche Prompts erwartest.
Ideen: Was du damit anstellen kannst
Du lässt dir Kisten, Tränke oder Bäume generieren und importierst sie in Godot, um dein Level schnell zu füllen. So testest du Spielideen ohne eigenes Modeling.
Bei knapper Zeit erzeugst du in Minuten ein Set an Low-Poly-Assets. Fehlerhafte Ergebnisse generierst du einfach neu.
Du liest den erzeugten Code und siehst, wie Objekte aus einfachen Formen aufgebaut und exportiert werden. Das ist ein guter Einstieg in 3D im Browser.
Mit Prompts wie „Build a goblin“ bekommst du einfache Figuren, die du in Blender oder Godot weiter anpasst.
Exportierte GLB-Dateien lassen sich mit Tools wie dem Godot Pixel Renderer in Retro-Sprites umwandeln.
Was dein Rechner braucht
Welche Variante passt zu mir?
Viele Modelle gibt es in mehreren Größen oder „Quantisierungen“. Das sind komprimierte Fassungen: kleiner und schneller, dafür minimal ungenauer. Faustregel: Nimm die größte Variante, deren Speicherbedarf in deinen Grafikspeicher (VRAM) passt. Die Skripte unten wählen das automatisch für dich aus.
| Variante | Download | Braucht ca. | Passende Grafikkarten |
|---|---|---|---|
Q4_K_M Standard |
2,7 GB | 4 GB | fast jede Grafikkarte ab 4 GB (z. B. GTX 1650, RTX 3050) |
Q8_0 |
4,5 GB | 6 GB | z. B. RTX 2060, RTX 3050 8 GB, RX 6600 |
Q4_K_M ist die Standardwahl für kleine Grafikkarten oder normale Laptops. Q8_0 ist genauer, braucht etwa doppelt so viel Speicher und lohnt sich, wenn du eine Karte mit 8 GB oder mehr hast und die Codequalität wichtiger ist. Die vollen Safetensors-Gewichte folgen erst nach Trainingsende.
- Q4_K_M sollte mit etwa 4 GB VRAM laufen (Schätzung), Q8_0 braucht grob das Doppelte.
- CPU-Betrieb ist bei 4B-Modellen mit 8 GB RAM möglich, aber langsamer.
- Das generierte HTML wird im normalen Browser angezeigt, dafür ist keine starke GPU nötig.
- Lange Antworten (komplette HTML-Dateien) brauchen eine ausreichend große Kontextlänge, die zusätzlich Speicher kostet.
Wie finde ich heraus, was mein Rechner hat?
- Windows: Strg + Umschalt + Esc drücken → Task-Manager → Reiter Leistung → links GPU anklicken. Unten steht Dedizierter GPU-Speicher (das ist dein VRAM). Den Arbeitsspeicher findest du unter Arbeitsspeicher.
- Mac: Apfel-Menü oben links → Über diesen Mac. Dort stehen Chip (z. B. M2) und Speicher (z. B. 16 GB). Bei Apple-Chips teilen sich Grafik und Prozessor diesen Speicher.
- Linux: Im Terminal
nvidia-smieingeben (zeigt Grafikkarte und Speicher) undfree -hfür den Arbeitsspeicher.
Anleitung
Google Colab (im Browser, ohne Installation)
Google Colab ist ein kostenloser Dienst von Google: Du bekommst für ein paar Stunden einen Rechner mit Grafikkarte im Browser. Du brauchst nur ein Google-Konto. Für dieses Modell: läuft kostenlos – Gratis-GPU Tesla T4 mit 15 GB reicht.
- Notebook herunterladen. Klick auf den Knopf und speichere die Datei.
- Colab öffnen. Geh auf colab.research.google.com und melde dich mit deinem Google-Konto an.
- Notebook hochladen. Im Fenster, das erscheint, links auf Hochladen klicken (oder oben Datei → Notebook hochladen) und die Datei
colab.ipynbauswählen. - Grafikkarte einschalten. Oben im Menü Laufzeit → Laufzeittyp ändern → bei Hardwarebeschleuniger T4-GPU auswählen → Speichern.
- Alles starten. Laufzeit → Alle ausführen (Tastenkürzel Strg + F9). Kommt die Warnung „Dieses Notebook wurde nicht von Google erstellt“, auf Trotzdem ausführen klicken.
- Warten. Die Zellen laufen nacheinander durch. Links neben jeder Zelle erscheint ein grüner Haken, wenn sie fertig ist. Installation und Download dauern hier etwa 5 Minuten.
- Ausprobieren. Das Ergebnis steht unter der letzten Zelle. Um etwas anderes zu testen, den Text in der Zelle ändern und mit Shift + Enter erneut ausführen. Die letzte Zelle startet einen richtigen Chat mit Eingabefeld.
- Aufräumen. Wenn du fertig bist: Laufzeit → Sitzung beenden. Das schont dein kostenloses Kontingent.
Gut zu wissen: Die Gratis-GPU ist begrenzt (meist einige Stunden am Tag). Nach rund 90 Minuten ohne Aktivität trennt Colab die Verbindung, dann alles neu starten.
Windows 10 / 11
Am einfachsten geht es mit Ollama, einem kostenlosen Programm, das KI-Modelle mit einem Befehl startet.
- Grafikkartentreiber aktualisieren (nur bei NVIDIA-Karten): Die NVIDIA-App bzw. den aktuellen Treiber installieren. AMD-Karten: aktuellen Adrenalin-Treiber nutzen.
- Ollama installieren. Auf ollama.com/download/windows die Datei OllamaSetup.exe herunterladen, doppelklicken und Install wählen. Danach sitzt rechts unten in der Taskleiste ein kleines Lama-Symbol.
- Eingabefenster öffnen. Windows-Taste drücken, PowerShell eintippen und Enter drücken. Es öffnet sich ein blaues oder schwarzes Fenster.
- Modell starten. Diesen Befehl kopieren (Knopf „Kopieren“), mit Rechtsklick ins Fenster einfügen und Enter drücken:
Beim ersten Mal lädt Ollama das Modell herunter (2,7 GB (bei 100 MBit/s ca. 4 Min.)). Danach geht es sofort.ollama run hf.co/ccore/Qwen3.5-4B-GLB-3D-Coder:Q4_K_M - Losschreiben. Sobald
>>> Send a messageerscheint, deine Frage eintippen und Enter drücken. Mit/byebeendest du den Chat.
Zu wenig Speicher? Nimm eine kleinere Variante aus der Tabelle oben, z. B. ollama run hf.co/ccore/Qwen3.5-4B-GLB-3D-Coder:Q4_K_M.
Lieber automatisch? Skript, das die passende Variante selbst auswählt
- Beide Dateien in denselben Ordner herunterladen: try_windows.ps1 demo.py
- Den Ordner im Explorer öffnen, mit Rechtsklick auf eine freie Stelle In Terminal öffnen wählen.
- Diesen Befehl einfügen und Enter drücken:
powershell -ExecutionPolicy Bypass -File try_windows.ps1
Das Skript installiert Ollama bei Bedarf über winget, misst deinen Grafikspeicher und lädt die passende Variante.
macOS
Ideal sind Macs mit Apple-Chip (M1 bis M5). Ältere Intel-Macs sind sehr langsam.
- Ollama installieren. Auf ollama.com/download/mac herunterladen, die Datei öffnen und Ollama in den Ordner Programme ziehen. Ollama einmal starten – oben in der Menüleiste erscheint ein Lama.
- Terminal öffnen. Cmd + Leertaste drücken, Terminal eintippen, Enter.
- Modell starten. Befehl einfügen (Cmd + V) und Enter:
Beim ersten Mal wird das Modell heruntergeladen (2,7 GB (bei 100 MBit/s ca. 4 Min.)).ollama run hf.co/ccore/Qwen3.5-4B-GLB-3D-Coder:Q4_K_M - Losschreiben. Frage eintippen, Enter. Mit
/byebeenden.
Linux
- Grafikkarte prüfen.
nvidia-smisollte deine Karte anzeigen. Wenn nicht, unter Ubuntu den Treiber installieren und neu starten:sudo ubuntu-drivers install - Ollama installieren:
curl -fsSL https://ollama.com/install.sh | sh - Modell starten:
Mitollama run hf.co/ccore/Qwen3.5-4B-GLB-3D-Coder:Q4_K_M/byebeenden. Mitollama pssiehst du, ob das Modell auf der GPU läuft. - Oder automatisch die passende Variante wählen lassen:
bash try_linux.sh
Das kannst du ausprobieren
Create a mana potion.Build a goblin.Build a weathered frontier medic station.Create a low-poly desert merchant in a self-contained Three.js HTML scene, with a button to export the character as a GLB file for use in Godot.Create a low-poly treasure chest with an opening lid animation, exported in the GLB.Tipps für bessere Ergebnisse
- Nutze exakt den Systemprompt aus der Modellkarte und schicke die Anfrage als Nutzernachricht.
- Starte mit kurzen englischen Prompts und werde erst bei Bedarf ausführlicher.
- Beginne mit Temperatur 0,8, Top-K 40, Top-P 0,95, Min-P 0 und variiere dann.
- Wenn der Code fehlerhaft ist, generiere neu oder bitte das Modell, den Fehler zu beheben.
Wenn es hakt
Der Systemprompt muss gesetzt sein, sonst entsteht nicht zuverlässig eine HTML-Datei mit Export-Button.
Nicht-englische Prompts funktionieren schlechter; formuliere auf Englisch.
Manche Ausgaben enthalten Fehler und brauchen einen neuen Versuch oder eine kleine Korrektur.
Es ist ein Vorschau-Checkpoint: Die Safetensors-Gewichte fehlen noch, und das Verhalten kann sich ändern.
Speichere die Antwort als .html-Datei und öffne sie im Browser, um den Export-Button zu nutzen.
„out of memory“, Absturz oder der Rechner hängt
Das Modell ist zu groß für deinen Grafikspeicher. Nimm eine kleinere Variante aus der Tabelle oben und schließe andere Programme, vor allem Spiele und Browser mit vielen Tabs.
Es läuft, aber extrem langsam
Wahrscheinlich rechnet der Prozessor statt der Grafikkarte. Bei Ollama zeigt ollama ps in der Spalte PROCESSOR, wie viel auf der GPU läuft. Steht dort „100% CPU“, Grafiktreiber aktualisieren oder eine kleinere Variante nehmen, die komplett in den Grafikspeicher passt.
„ollama“ bzw. „python“ wird nicht gefunden
Das Eingabefenster schließen und neu öffnen, damit es das frisch installierte Programm kennt. Bei Python unter Windows: neu installieren und das Häkchen Add python.exe to PATH setzen.
Windows: „Die Ausführung von Skripts ist auf diesem System deaktiviert“
Das Skript genau mit dem Befehl oben starten: powershell -ExecutionPolicy Bypass -File try_windows.ps1. Das erlaubt die Ausführung nur dieses einen Mal.
Fehlermeldung beim Laden des Modells (Version, „trust_remote_code“, unbekannte Architektur)
Ganz neue Modelle brauchen oft die neueste Programmversion. Bei Ollama: Ollama aktualisieren. Bei Python: pip install -U transformers in der aktivierten Umgebung. Die Model Card nennt meist die genaue Version.
Skripte und Notebook erzeugt Tokenstrom automatisch. Bitte vor dem Ausführen kurz ansehen – sie sind lesbarer Klartext. Lizenz des Modells beachten: apache-2.0.
Frag den KI-Assistenten
Fragen zu diesem Artikel, zur Installation oder zu Hintergründen? Unser Assistent kennt diese Seite und läuft auf unserem eigenen Rechner, nicht in einer fremden Cloud.
Der Assistent ist eine KI (Gemma 4) und kann sich irren – wichtige Angaben bitte in der Quelle prüfen. Fragen werden nur zum Beantworten genutzt und nach einer Stunde gelöscht. Bitte keine persönlichen Daten eingeben.
Kommentare
Was meinst du dazu? Schon ausprobiert? Schreib es hier, ohne Anmeldung.
Kommentare sind öffentlich. Links sind nicht erlaubt, beleidigende Beiträge löschen wir. Deinen eigenen Kommentar kannst du in diesem Browser jederzeit wieder löschen. Mehr dazu in der Datenschutzerklärung.